Wiki 知识库

全部文档 / 标签: 推理加速

12 篇
清除

Cerebras 如何部署万亿参数前沿模型

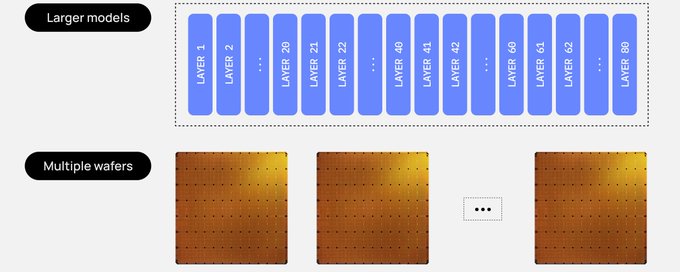
Cerebras 团队详细介绍了如何在 WSE-3T 晶圆级芯片上部署万亿参数大模型。以 3 万亿参数的开源模型 Kimi K3 为例,团队通过 4-bit 权重量化和 8-bit KV 缓存计算每层约 16 GB 的显存需求,将模型切分到 59 片晶圆上:每个 dense 层独占一片晶圆,每片可放两个 linear-attention 层。晶圆间通过以太网 RDMA 传递激活值,权重无需移动。系统以流水线方式运行,各阶段可同时处理不同请求和微批次,从而实现 1000-2000+ tokens/秒的推理速度。

技术 › LLM Sarah Chieng 2026-10-239.9 KB 282.4K 816 85

12G显存部署125B Qwen3.8-Flash-Next 全攻略

本文介绍如何在12GB显存上部署125B参数的Qwen3.8-Flash-Next模型。核心是Strata技术让GPU、CPU、RAM和SSD协同工作:常用专家留GPU,其余放RAM,CPU处理cache miss。RTX 5070 12GB + 64GB RAM在Q2_0量化下短对话可达94 tok/s。文章还讲解了量化选择策略——显存占用相同时速度可差1.72倍,关键在于专家命中率。作者全程使用蚂蚁的Ling-3.1-flash Agent自动完成从检查机器、选权重、下载安装到排错验收的完整部署流程,跑通了一套用Agent自动部署本地模型的可复用方法。

技术 › LLM 实践哥 Li 2026-10-087.4 KB 79

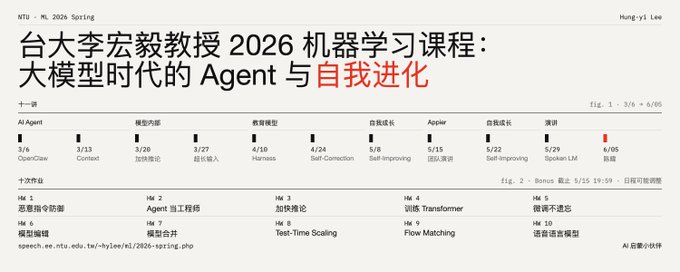
台大李宏毅教授 2026 机器学习课程更新:大模型时代的 Agent 与自我进化

文章介绍台湾大学李宏毅教授 2026 春季机器学习课程,该课程完成了从经典机器学习到大模型时代前沿课的彻底转型。课程以四幕叙事展开:AI Agent 与 Context Engineering、模型内部架构(Flash Attention、KV Cache、位置编码)、模型教育(Harness Engineering、自我修正)、模型自我成长(Self-Improving、自我进化 Agent)。十次硬核作业与授课主题严格对应,涵盖 LLM 安全、Agent 搭建、推理优化、后训练等技能。文章认为课程演变折射学科趋势:Agent 成应用层范式、系统级工程能力重要、后训练时代重心移向环境设计与模型自我进化。

技术 › LLM meng shao 2026-09-2710.2 KB 22.4K 222 85

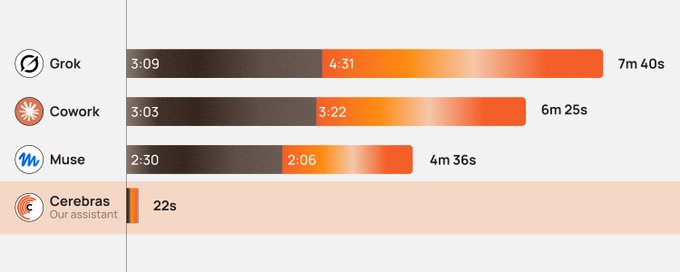
We built a 20x faster Grok bot

Cerebras 团队测试了主流 AI 个人助理完成订餐任务的表现,发现现有助理耗时过长(如 Grok Bot 需 7 分 40 秒)。团队使用 Qwen 3.8 27B 模型运行在 Cerebras 硬件上,以 Pi 作为 Agent Harness,通过三项优化将任务压缩至 22 秒:1) 并行执行独立的检查操作;2) 借助 Cerebras 快速推理加速模型调用;3) 将探索网站的经验固化为 Skill 复用,减少 80% 以上的工具调用。文章展示了 Harness Engineering、快速推理和经验沉淀对 Agent 效率的巨大提升潜力。

技术 › Agent Cerebras (Sarah Chieng, @0xSero) 2026-09-267.4 KB 685.5K 1.9K 70

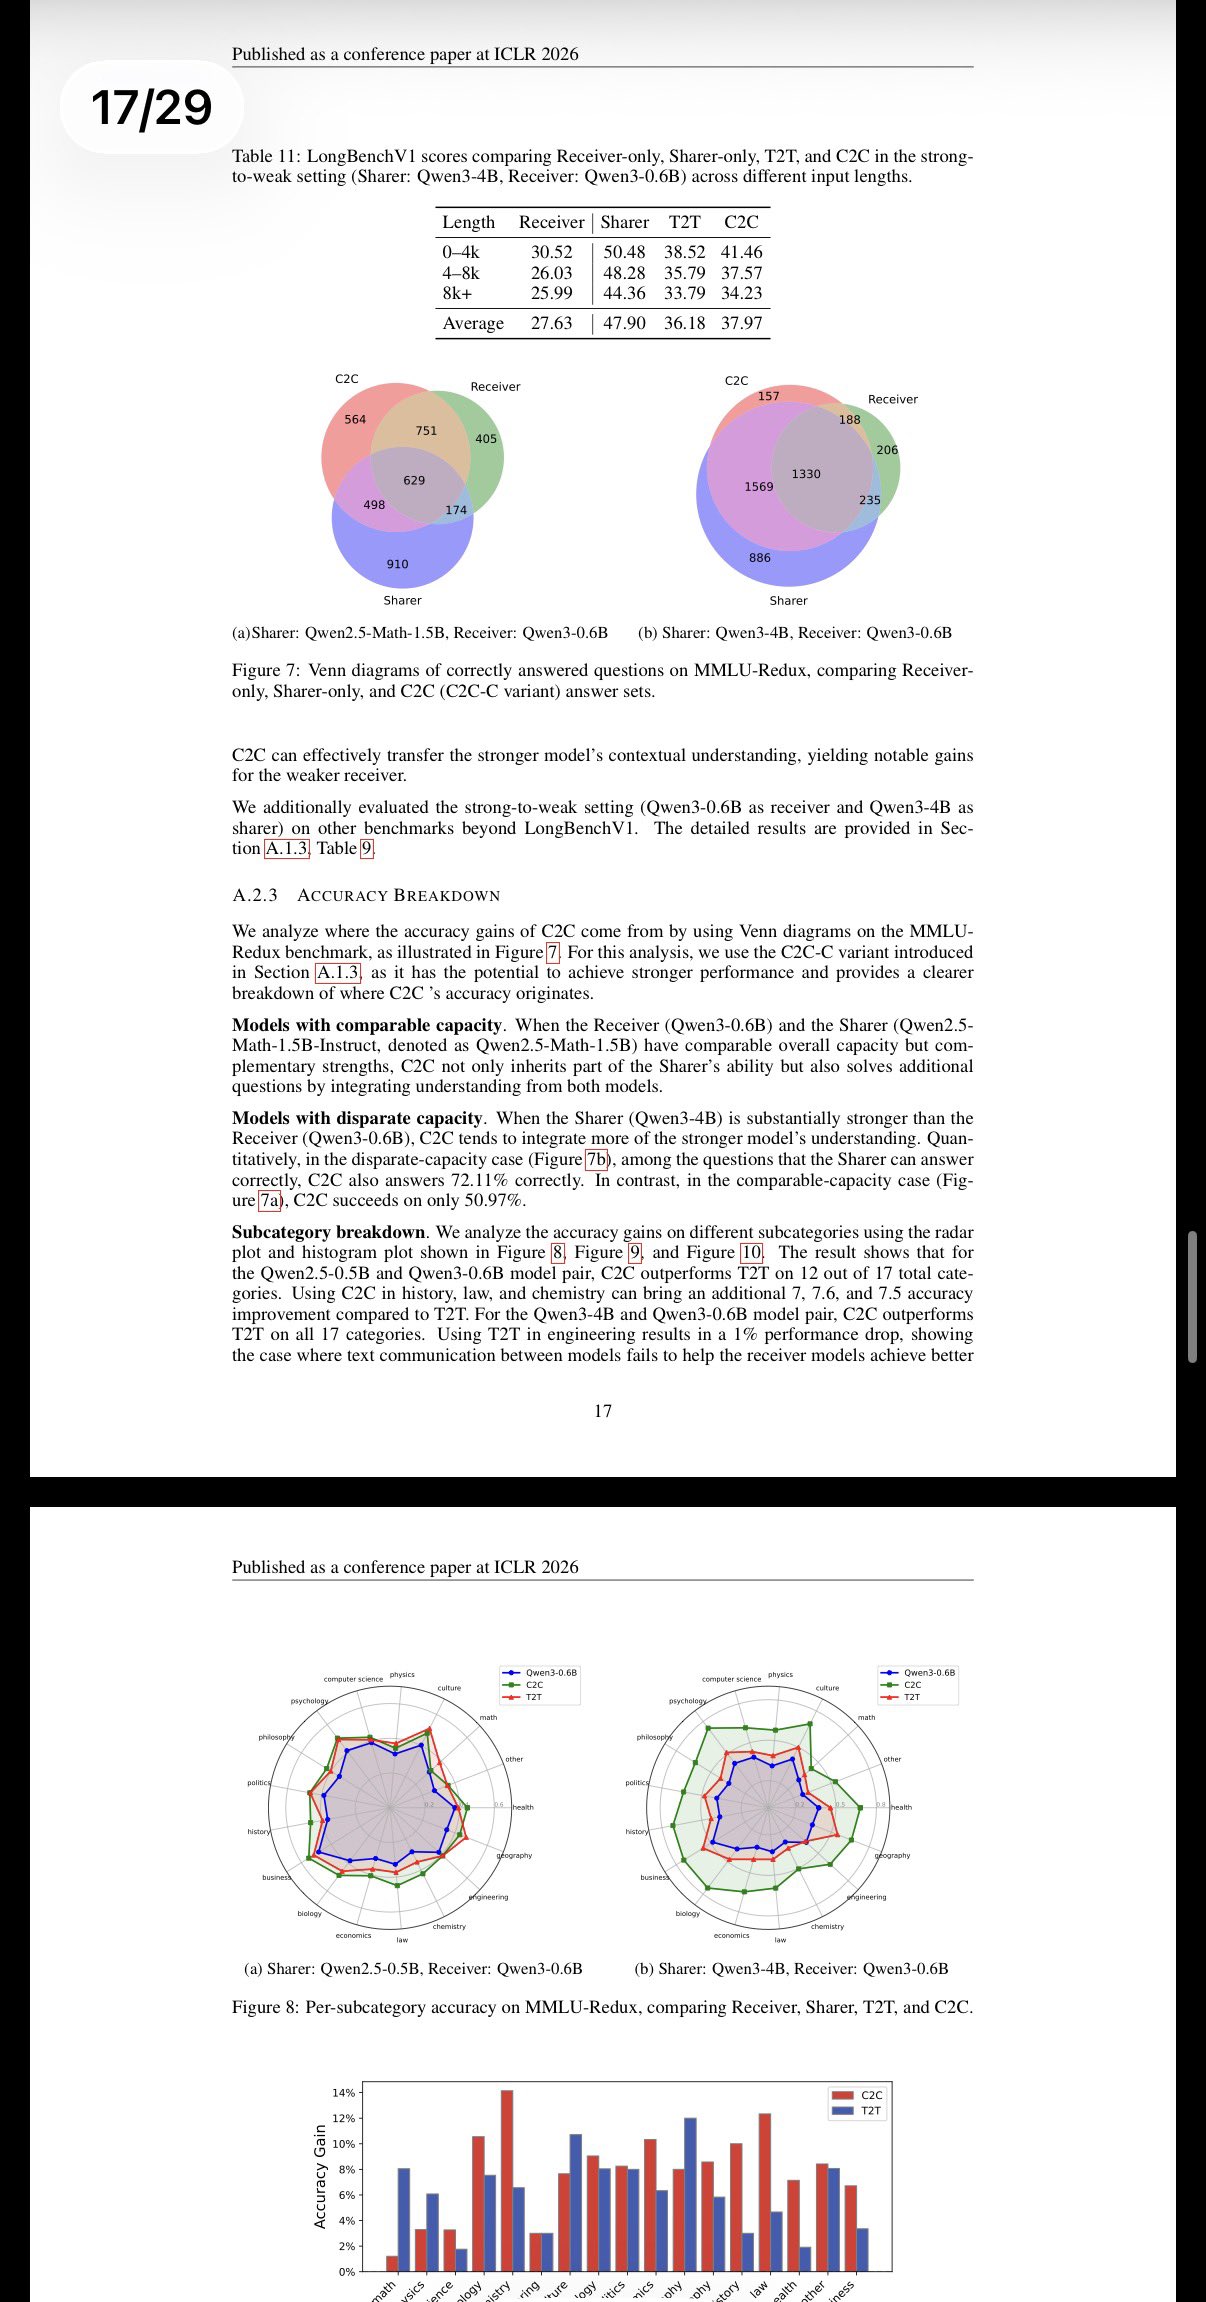
清华团队开源C2C技术:大模型缓存直连,绕过文字交流

清华大学联合无问芯穹、上海AI Lab发布C2C(Cache-to-Cache)技术论文(ICLR 2026),彻底改变多智能体系统通信范式。传统Multi-Agent协作中模型需将高维思考压缩为文本逐字解码再传递,造成延迟、语义丢失和高昂Token成本。C2C通过轻量级神经网络(Neural Fuser)将模型A的KV-Cache直接旋转对齐后融进模型B的KV-Cache,并引入可学习门控机制动态决定各层吸收外部缓存的程度。实测推理速度提升2.0-2.5倍,问答准确率较单模型提升14.2%,比文本通信的Agent团队高5%。代码与论文均已开源,未来有望大幅降低Mixture-of-Agents调用成本。

技术 › LLM AYi (@AYi_AInotes) 2026-09-194.3 KB 71

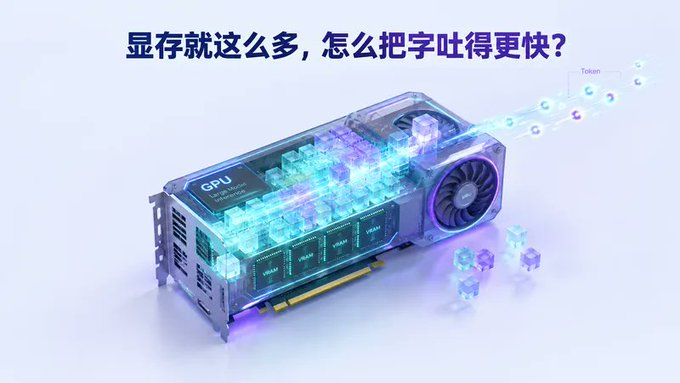
显存就这么多,怎么把字吐得更快?——从 MoE、KV Cache 到 DFlash 的本地部署全景拆解

文章从一张16GB显卡出发,系统拆解大模型本地部署的显存与速度权衡。首先澄清运行显存不只包含模型权重,还有KV Cache、运行时工作区和草稿模型开销;解释MoE与量化对容量和计算的不同影响,区分总参数与激活参数;分析CPU/GPU卸载的代价;介绍KV Cache与混合注意力如何影响上下文长度;区分Prefill与Decode两个阶段的速度特征;最后详解投机解码、MTP与DFlash/DFlash2的加速原理及实测收益。强调各优化手段需配合使用,预算刚好装满并不代表能稳定运行。

技术 › LLM huangserva 2026-09-1423.1 KB 9.9K 69 84

大开眼界:把 DeepSeek V4.1 Flash 的 Causal Encoder-Decoder 思路移植到 Qwen3-8B

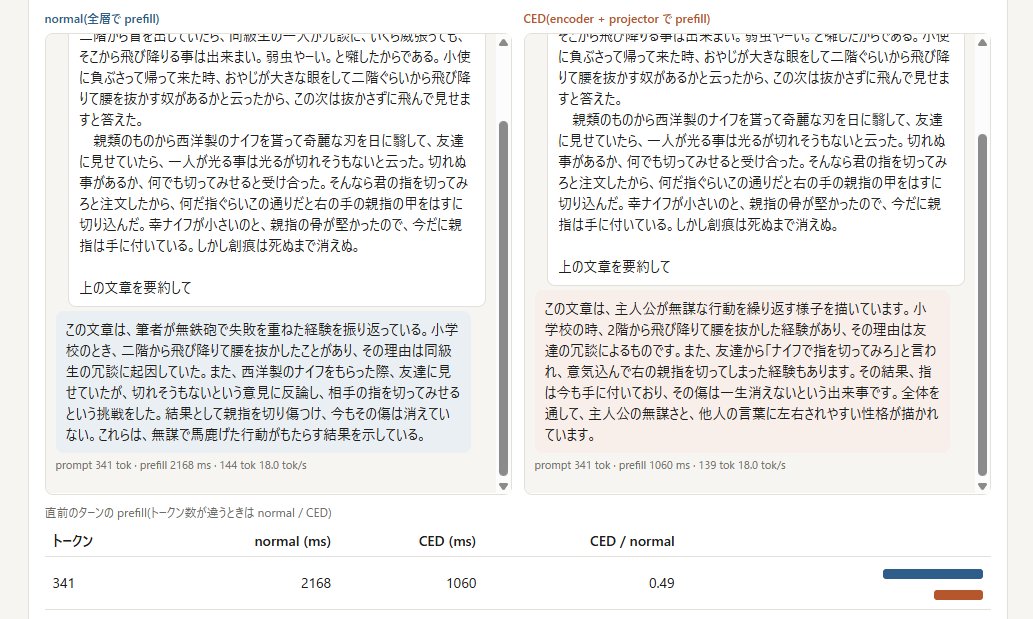
文章介绍了一项实验:研究者将 DeepSeek V4.1 Flash 的 Causal Encoder-Decoder 机制移植到现有 Qwen3-8B 上,不修改原模型权重,仅外挂一个小模型近似后半层 KV Cache,使 Prefill 时间缩短近一半且输出一致。作者分析了这对本地模型部署(尤其 DGX Spark)的重大意义:长上下文首 token 等待明显降低,KV Cache 内存占用减少,Coding Agent、Computer Use Agent 等本地工作负载体感大幅提升。文章同时指出结果尚需在更多任务上验证,但认为已有模型可通过轻量近似层获得架构级推理升级。

技术 › LLM Wei (@wei_wang) 2026-09-135.5 KB 75

KV Cache Engineering for LLM Serving, clearly explained

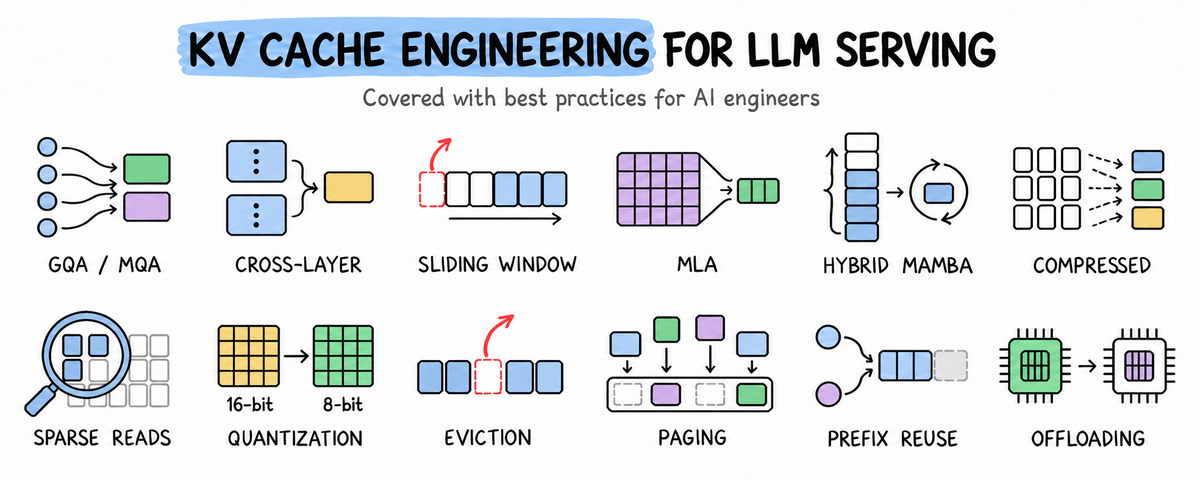
文章系统讲解了LLM推理中KV缓存的工程优化。KV缓存随序列长度增长,Llama 3.1 70B单条128K序列的BF16缓存约需40GB,成为GPU内存和注意力计算的双重瓶颈。作者将12种优化技术按减少的对象分类:GQA/MQA减少KV头数量,跨层注意力减少缓存层数,滑动窗口与淘汰减少保留token数,MLA减少表示宽度,量化减少字节数,混合循环层用固定状态替代增长缓存,分页与前缀复用减少分配浪费。文章配有可运行代码示例,并分析各技术的适用场景与权衡。

技术 › LLM Avi Chawla 2026-09-0640.4 KB 206.5K 557 82

Agentic Kernels in Production

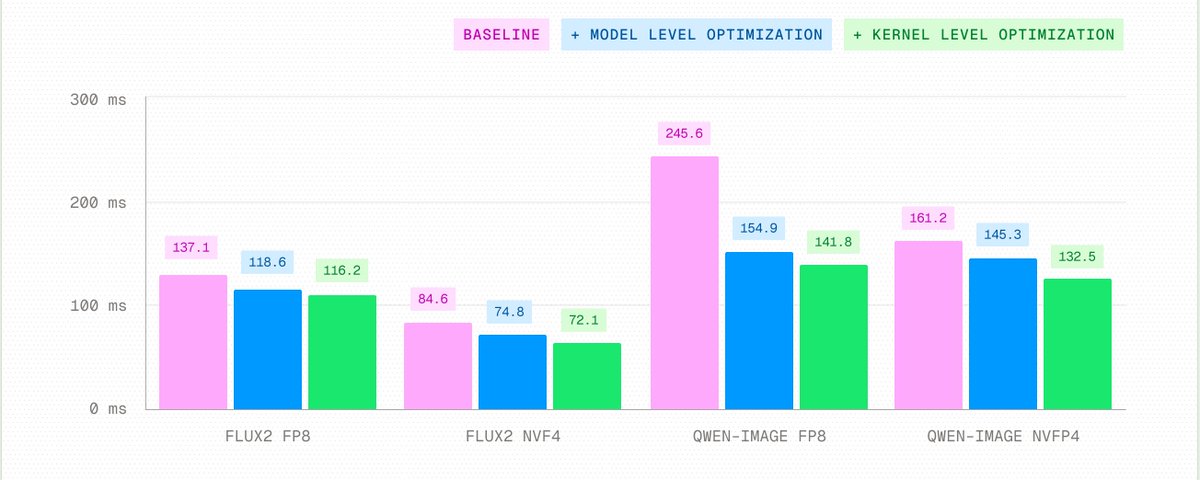
文章介绍了一个面向生产环境的 agentic kernel 优化框架,弥合基准测试与生产部署之间的差距。框架分为模型级优化和单 kernel 优化两层:先对完整 workload 进行 profile,提出算子融合、冗余消除等改进,再并行探索多个 kernel 实现并迭代优化。框架还具备自我改进机制,将成功与失败的优化经验存入知识库供后续复用。在实际部署中,该框架将 Qwen-Image 端到端延迟降低 42.3%,FLUX.2 降低 15.2%,MiniMax M3 吞吐提升 5.5%,具体优化包括 FP8 scale 预打包、QKV 投影融合、归一化与量化融合等。

技术 › LLM Brian Li 2026-08-2917.1 KB 265.1K 758 77

BestBlogs 早报 · 08-14|DeepSeek Harness 智能体,GPT-5.6 Sol 压缩推理等待,多智能体实验暴露协作失灵

本期早报聚焦智能体系统的三大核心问题:架构、算力与协作机制。DeepSeek Harness 提供插件化 Agent Harness,将模型、工具等能力拆分为可替换组件;Cerebras 与 OpenAI 推出 GPT-5.6 Sol Ultrafast,通过专用硬件实现高速推理;Anthropic 的多智能体实验揭示了协作中的冲突、从众与信任问题。此外,速览部分涵盖 Gemini 3.7 Flash 发布、Agent 评测与轨迹复盘、ICML 论文复现经验、Claude Tag 更新及小红书开源 TTS 模型。

技术 › LLM ginobefun 2026-08-1430.6 KB 7.7K 2 76

Kimi K3 技术报告拆解:全球首个开源 3T 级模型

本文拆解了 Kimi K3 的技术报告,这是一个全球首个开源的 2.8 万亿参数模型。文章详细解析了其混合注意力架构、注意力残差机制、MoE 设计以及在长文本训练和推理优化上的创新。报告指出 K3 性能虽略逊于顶级闭源模型,但在多项任务中表现优异,且具有极高的成本效率,甚至已能辅助团队进行内核优化和芯片设计。

技术 › LLM Berryxia.AI 2026-07-2920.0 KB 393.1K 186

Paper List for AI beginners

这是一份针对计算机科学和数学专业大二学生的机器学习(ML)与强化学习(RL)入门阅读清单。清单分为四个部分:基础(如ResNet、Attention)、AI基础设施(如VAE、BERT、LoRA、Agent)、推理加速(如Linear Attention、Speculative Decoding)以及强化学习(如PPO、DPO、RLHF)。该列表由导师 Mingyang Yi 推荐,旨在帮助本科生构建系统的 AI 知识体系。

技术 › LLM Xiuyu Li 2026-04-182.5 KB 18.6K 364 59