Wiki 知识库

全部文档 / 标签: 模型路由

41 篇
清除

Devin Desktop 从入门到进阶:界面拆解、Fusion 模型搭配与隐藏技巧

本文是 Devin Desktop 桌面客户端的使用教程,作者从安装配置讲起,详细介绍界面布局(Agents View 与 IDE View 两种视图)、模型切换与 Adaptive/Fusion 两种智能路由模式(推荐 Claude Opus 5.5 + SWE-2 的主导+辅助模型搭配)、权限设置提示词、Normal/Plan/Ask 三种工作模式,以及 IDE View 的 Git 提交、Codemaps 等功能。重点介绍了较少被讨论的 Devin Cloud 功能,可在 Windows 上通过云端虚拟机构建 Mac/iPhone 应用。文章面向刚上手 Devin 或从 Codex 迁移的开发者。

技术 › 工具与效率 雪瑜 2026-10-278.1 KB 16.8K 37 79

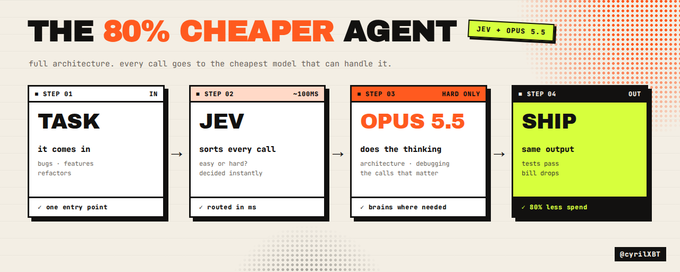
如何构建成本降低 80% 的编码 Agent:Jev + Opus 5.5 完整架构

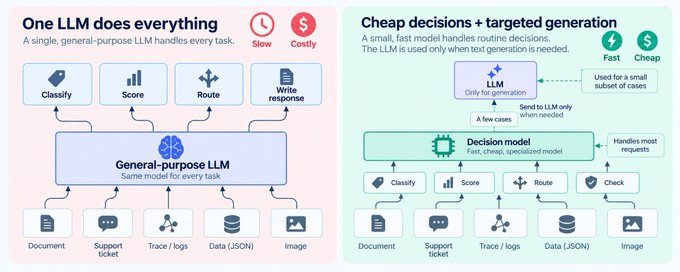
文章指出当前编码 Agent 在简单决策(如选择加载哪些笔记、任务路由、工具失败处理、测试优先级)上滥用昂贵的前沿大模型,造成成本浪费。作者提出三层架构:Opus 5.5 负责规划、写代码、调试等开放性推理;Jev(TypeSafe 出品,毫秒级响应、输入 $0.042/百万 token、输出免费)负责从固定选项中做小决策并返回概率;Harness 层构建选项、校验概率阈值并在低置信度时回退到 Opus。文章给出四个具体决策点及代码实现:按标题分块并用 Jev 并行评分筛选相关笔记(将 30k token 降至 6k)、任务路由、工具失败处理、测试优先级选择。实测一个功能开发会话成本从 $6.42 降至 $2.00,降低 69%,且架构可作为函数调用插入现有 Agent 循环,无需重写。
技术 › Agent CyrilXBT 2026-10-2626.0 KB 515.7K 385 87

顶尖 AI 公司都在押注 Fusion,我实测了一款:你装没听见,它还在提醒你

作者设计 15 道两轮陷阱题,第一轮故意说出错误前提,第二轮装作没听见继续提问,用三个 AI 裁判评测了 5 个模型的'回头纠错'能力。150 次对话结果显示,融合模型 FUMO 旗下的 Fusion Code 以 90% 的纠错比例遥遥领先,GPT-6 Astra、Claude Fable 5.1、Claude Opus 5 和 GPT-5.6 均在 70% 左右。文章对比了模型路由与多模型协作的差异,指出榜单分数高不等于会在用户走偏时拦截,并介绍了 FUMO Fusion Max 2.0 在办公文档分析上的新能力。

技术 › LLM 阿良|AI 工作流 2026-10-2325.4 KB 31.5K 115 85

Codex 也能免费用 DeepSeek V4.1 Flash 了:Magpie + WorkBuddy AI 保姆级教程

本文是详细的保姆级教程,讲解如何通过本机中转站 Magpie 和 WorkBuddy AI 海外版账号,让 Codex 免费使用 DeepSeek V4.1 Flash 模型。作者介绍了从注册 WorkBuddy AI 账号、安装 Magpie、配置插件、将 Codex 接入 Magpie 的完整流程,并通过路由记录和积分验证免费模型的真实使用。进一步还介绍了路由组功能,实现自动任务分配:复杂任务(架构设计、bug 排查、代码评审)交给 GPT-6 Astra,代码编写等任务交给免费的 DeepSeek。全文在 Mac 环境下实操,包含一个 3D 网页开发的完整实践案例及踩坑经验分享。

技术 › Codex Jonathan Hu 2026-10-1924.1 KB 1.8K 18 79

从Anthropic看用工变化与人的价值,LangChain CEO谈模型路由和运行框架,DeepSeek V4.1 Flash新版本发布

本期早报聚焦三大主题:一是Anthropic内部研究揭示AI如何重塑用工方式,初级技术岗占比从27%降至9%,员工角色从执行转向定义任务、分流输出与验证结果,判断力成为核心能力;二是LangChain创始人Harrison Chase谈智能体系统中模型、运行框架与上下文三层拆分,强调路由价值来自对任务结构的理解,并分享记忆与持续学习的实践经验;三是DeepSeek V4.1 Flash新版本发布,强化从零构建完整项目能力,开放Search/Fetch接口并单独计费。速览部分涵盖AI成本优化、智能体评估实操、美光存储产业史与AI安全等七篇内容。

技术 › LLM ginobefun 2026-10-1828.6 KB 1.7K 3 76

Introducing Glass: Learn Things Once

Ramp CEO Eric Glyman 发布企业级 AI 产品 Glass,回答了 David Senra 的提问“Ramp 为何移动如此之快”。Glass 的核心理念是让公司只学习一次:将员工分散在聊天记录、Slack 和个人头脑中的最佳工作沉淀为企业共享知识库,成为所有人的工作起点。Glass 集成 Linear、Notion、Slack、Gong 等工具,支持多人协作、Skills 复用、任意模型选择,并通过 Ramp Router 自动选择合适模型和项目计费器控制成本,使 Ramp 的 AI 账单一夜下降 30%。产品上线后已有 323 名员工做出 6500 多次知识编辑,功能请求捕捉量从每月 300 提升至 20000。

技术 › LLM Eric Glyman 2026-10-134.9 KB 630.3K 2.1K 65

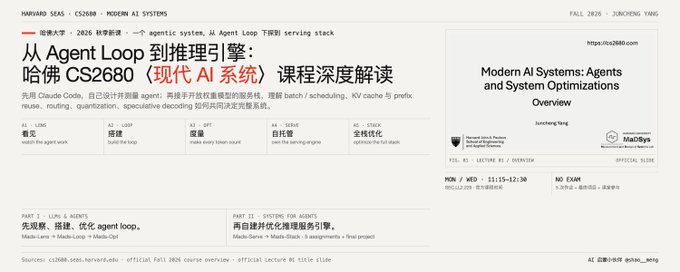
从 Agent Loop 到推理引擎:哈佛 CS2680 现代AI系统课程深度解读

本文深度解读哈佛大学2026年秋季Juncheng Yang开设的研究生课程CS2680《现代AI系统:Agent与系统优化》。课程以一条主线贯穿agent循环到LLM推理serving栈,通过五个递进式作业逐层解剖系统:A1为Claude Code构建Web前端,A2从零实现最小agent harness,A3在黑盒API下优化成本与延迟并引入排行榜竞争,A4自建推理引擎部署开源模型,A5全栈profile驱动的假设验证优化。文章还分析了课程的AI使用政策(强制披露、Claude Code session存档审计)、leaderboard评分机制、严格的20% A档曲线以及体现系统研究方法论的期末项目设计,展示了'AI时代如何教系统课'的完整答案。

技术 › LLM meng shao 2026-10-1233.1 KB 10.8K 103 85

How to Build a Model Router in the Harness

文章介绍 LangChain 如何为开源编码代理 Open SWE 构建模型路由器。作者首先通过 LangSmith 追踪数据分析任务类型与复杂度分布,发现许多任务无需前沿级模型;随后基于 Artificial Analysis 智能指数挑选快速、均衡、高性能三档模型(GLM-5.3-Flash、GPT-5.6 Sol、GPT-6 Astra);最后在 agent harness 的中间件层实现路由器,由分类模型根据任务标准选择最便宜可胜任的模型。结果显示每线程成本中位数降低 64%,质量无明显变化。文章强调路由决策应置于 harness 中,因其拥有网关所缺乏的任务与领域上下文。

技术 › LLM Sydney Runkle 2026-10-0221.4 KB 112.7K 324 83

Is Jev overhyped? We tested it on 4 real enterprise tasks.

作者基于 Glean 的四个真实企业场景测试了 Jev——一个输出类型化决策(选项、分数、概率)而非生成文本的'System One'模型。文章梳理了通用 LLM、零样本分类器、微调分类器与 Jev 的替代方案权衡,并对比了 Qwen/SGLang、Kev 等开源复现。实验显示:查询分类上 Jev 零样本明显优于 Laya 但微调后反超;模型路由(专家转移)是最强结果,准确率更高且中位加速 8.1 倍;重排序中 Jev 的 Choice 表述最强,但平均 41 个候选中约 37 个分数相同需靠生产排序打破平局。结论是 Jev 在新任务或标签频繁变化时最具吸引力,是否被高估取决于具体场景。

技术 › LLM Tony Gentilcore 2026-09-2913.0 KB 196.4K 379 83

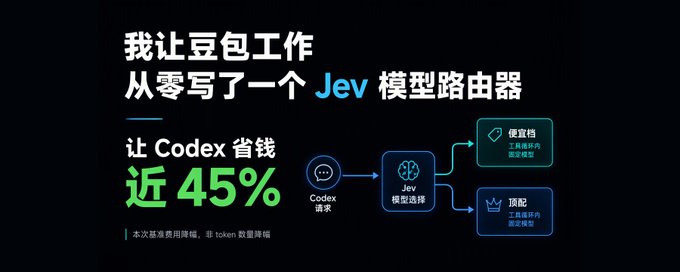
我让豆包工作从零写了一个 Jev 模型路由器,让 Codex 省钱近 45%

作者针对 Codex 账单越来越贵的问题,利用 TypeSafe AI 的 Jev 模型(只做带概率的判断、成本极低)搭建了一个外部模型路由器 HippoRoute-Jev-Codex,仅在线程首请求、新用户轮次、压缩检查点、子 agent 首请求四个缓存重建时机选模型,其余工具循环沿用钉住的模型,避免打掉 prompt 缓存。整个项目由豆包工作通过计划模式和目标模式从零完成,作者全程仅操作四次、未看一行代码,最终 76 个测试全通过并自行揪出 3 个 bug。实测机械任务省 95.4%,子 agent 场景省 79.7%,整体省 44.8%,且任务通过率无差别。

技术 › Codex huangserva 2026-09-2417.9 KB 82K 80 81

Building a Custom Harness with Pi and Jev

本文是构建自定义 AI Agent Harness 的教程。Harness 是驱动 Agent 循环的代码,负责模型路由、工具安全检查和答案校验等判断决策。传统做法需调用聊天模型,成本高导致检查被跳过。Jev 是 TypeSafe AI 推出的专用小型决策模型(System One 模型),以 0-1 概率快速回答问题,成本极低,可对每步操作进行实时检查。教程使用 Pi SDK(TypeScript 工具包)构建 Harness,通过 beforeToolCall 等钩子集成 Jev,实现破坏性操作拦截、模型路由、失败降级和答案质量校验,并以徒步调查笔记 Agent 为运行示例演示完整流程。

技术 › Agent elvis 2026-09-2417.4 KB 126.8K 1.2K 84

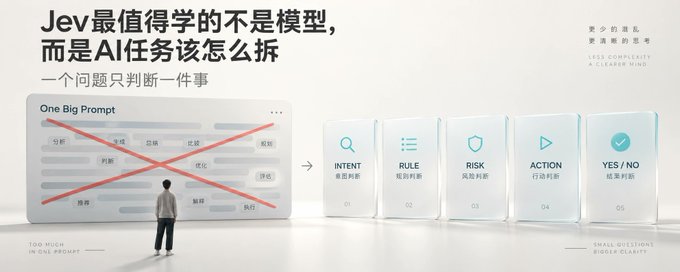
Jev与你有什么关系?它提供了一套AI工作流拆分法

文章介绍了TypeSafe AI于2026年9月发布的Jev模型,一个不做文本生成、只做封闭判断的“System One Model”。它提供三种能力:Choice(选项选择)、Score(等级打分)和Noul(真假概率判断),直接返回类型化结果和概率,省去生成文本的延迟和成本。文章分析了Jev与生成式模型的本质区别,指出类型安全只保证接口格式而非事实正确,概率不等于正确率,并详细说明其在缺陷分诊、Agent路由、发布说明审核等真实场景中的应用方法,以及官方Agent Skill倡导的AI工作流拆分法:代码负责计算和规则,模型只做清楚的语义判断。

技术 › LLM 苏乐 2026-09-2224.6 KB 20.2K 41 85

Loop Engineering for Sub-Dime Agents: Cutting Token Costs in AI Coding Harnesses

本文探讨如何通过循环工程降低自主编码 Agent 的 Token 成本。以一个 5 轮 PR 修复任务为例,未优化的 Harness 消耗 81,000 tokens($1.53),而优化后仅需 12,050 tokens($0.042)。核心机制包括:稳定的系统前缀以最大化 KV 缓存命中;基于 AST 的工具输出压缩,仅提取代码骨架;沙箱确定性工具预检与自动修复,避免浪费 LLM 推理;MCP 工具 Schema 的按需懒加载与 Code-Mode 执行;以及双层级模型路由(Workhorse 处理机械性任务,Frontier 处理复杂规划),并定义了四种确定性升级触发条件,实现亚角级(sub-dime)任务成本。

技术 › Harness Engineering Balaji Subramaniam (Google Cloud) 2026-09-2211.8 KB 49.6K 359 90

Jev 猛蹬教程:通过 Vercel AI Gateway 免费接入 Jev 及 7 个开源应用案例

文章介绍如何通过 Vercel AI Gateway 的 key 免费调用 TypeSafe 的 Jev 模型,无需白名单。作者列举了 7 个开源应用案例:浏览器自动化查找机票、Android 手机自动操作打车、Agent 上下文压缩节省 token、用 Jev 核对任务完成声明的 MCP 工具、PostgreSQL 扩展按语义筛选客户流失记录、工具调用前的自动审批流程、以及多模型自动路由分发任务。最后给出接入教程:登录 Vercel、创建 Gateway key、让编程 Agent 完成调用配置。

技术 › LLM 0x 哆啦A梦 2026-09-218.4 KB 14.1K 75 76

Jev 新手指南:System One 判断型模型入门

本文是 Jev(一个通用 System One 模型)的新手指南。Jev 专为快速、聚焦的判断设计,而非长推理或开放式写作。用户给它提供上下文(状态)和决策表(问题),它返回结构化答案及不确定性概率。答案类型包括 Choice(单选)、Noul(是/否概率)和 Score(有序打分),可一次请求多个互不影响的问题。文章介绍了 Jev Playground 中的六个用例,如支持工单分流、模型路由、Agent 工具调用守卫、智能家居请求等,并强调最终决策应由代码完成:设置阈值、硬规则和权限判断。Jev 适合重复性、答案有界的判断场景,但在算术、计数、日期、对抗性输入等方面表现不均,需谨慎使用。

技术 › LLM elvis 2026-09-215.9 KB 130.3K 927 72

新模型 Jev 爆火,5 天挤进 14 万开发者:快 200 倍、便宜 400 倍

文章介绍了发布即爆火的新模型 Jev(TypeSafe 公司出品),它不生成文本,只做判断:路由、分类、打分、审核。相比大模型,它判断速度快 40-200 倍(0.1 秒级),成本便宜约 400 倍,且因输出限定在预定义选项内而不存在幻觉空间。创始人 Diogo Almeida 是前 OpenAI 研究员。文章给出了三条免费或低成本使用方式(OpenJev、官方 waitlist、OpenRouter),并冷静指出官方数据的局限:444 倍提升是评测上限,第三方实测准确率约 68%。Jev 定位为给大模型打配角的 System One 模型,适合 Agent 场景中的高频小判断。

技术 › LLM 路飞 2026-09-207.9 KB 62.4K 76 83

火爆全网的Jev到底是什么?

文章介绍了旧金山创业公司 TypeSafe 推出的闭源基础模型 Jev。它不做文本生成,只做判断题、选择题和打分题,输出严格限定在预设选项内,可在约100毫秒内出结果,成本极低。其核心技术是通过 RLCD 强化学习实现概率校准,类似于卡尼曼所说的 System 1 快思考,与传统大模型的慢思考互补。文章展示了社区应用案例,如浏览器 Agent、游戏实时决策、LangChain 工具路由、AI 输出审核等,也指出其在数数、算数、多跳推理和中文上的短板及提示词注入风险,认为 AI 调用正在走向分层架构。

技术 › LLM 泊舟 2026-09-1913.9 KB 134.9K 549 80

Will TypeSafe's Jev change how we build AI applications?

文章分析了 TypeSafe 发布的新模型 Jev——一种只能做分类、评分和路由决策、不能生成文本的'System One'模型。Jev 比通用 LLM 快 40-200 倍、便宜 40-400 倍,通过 RLCD 训练方法实现零样本概率判断。早期独立测试显示其准确率接近 GPT-5.6 等大模型,垃圾邮件分类甚至可媲美有标注训练的分类器。代价是失去了解释能力,无法说明判断理由。作者认为这可能改变 AI 应用架构:用 Jev 做大规模廉价监控评估,用 LLM 判官处理少量样本以获取改进方向信号。

技术 › LLM Aparna Dhinakaran 2026-09-1912.8 KB 15.2K 202 78

WTF Is Jev? 9 Things People Are Already Building With It

Jev 是由 ChatGPT 联合创造者、RLHF 联合发明人 Diogo Almeida 在隐身两年后推出的决策型 AI 模型。它不做对话生成,而是为软件提供快速决策:选择题、评分、是/否判断,号称比前沿 LLM 快约 200 倍、便宜 400 倍,响应仅需几十毫秒。文章盘点了社区基于 Jev 构建的 9 个实际应用,包括 7 秒找机票的浏览器代理、上下文即时压缩工具、编码代理安全审查器、模型路由中间件等。其命名源自 19 世纪经济学家 Jevons,暗喻资源越便宜消耗越多的悖论。

技术 › LLM Matt Van Horn 2026-09-1827.1 KB 308.2K 1.3K 86

Awesome Jev:Jev 低延迟判断模型项目合集

作者分享了自己获批使用 TypeSafe AI 推出的 Jev 模型后的体验,并整理了一份 Awesome Jev 项目清单。Jev 是一个不生成文本、只返回选项、分数和概率的低延迟判断模型,可并行输出结果。文中介绍了 14 个基于 Jev 的项目,包括高速浏览器 Agent、MCP 集成工具、命令行语义判断工具、模型路由器、上下文垃圾回收、代码审查前置筛选、语义寻路、知识图谱、桌面自动化、交易流动性分析以及 FPS 游戏等应用场景。核心思路是:用 Jev 反复做'要不要、选哪个、打几分、下一步干什么'的判断,复杂推理和生成任务仍交给传统大模型,从而降低成本、提升速度。

技术 › Agent 思维怪怪 (@0xLogicrw) 2026-09-184.5 KB 80

一篇讲透|GPT 为什么变笨、账号为什么被封|史上最全的降智说明(附自查清单)

文章系统梳理了 ChatGPT 和 Claude 的降智与封号机制。降智方面,OpenAI 会通过换成小模型、缩短思考时间、转给安全模型三种方式降级请求,原因是算力配给、对可疑账号降级而非封号、以及路由器本身的错误。作者认为 IP 只是第一道门槛,账号健康度(登录出口、档位、账号权重、环境一致性、渠道)才是风控打分的核心。封号方面,OpenAI 查的是账号用途而非网络来源,Claude 则因政策更严、检测信号(IP 关联、支付方式、时间同步、代理访问)明确而封号更狠。文章引用了大量官方文档、员工发言和社区案例作为佐证。

技术 › OpenAI 言溪 Yanxi 2026-09-1837.6 KB 42.2K 102 84

Building a Harness with Jev

本文介绍 TypeSafe AI 发布的新模型 Jev,一种名为 System One 的非传统 LLM 模型。Jev 不生成文本,而是通过 RLCD 强化学习训练,对给定状态快速返回结构化决策(Choice、Score、Noul 三种问题类型)及概率,推理速度最高快 200 倍、成本低至 1/400。文章展示了如何通过 LangChain 的 TypeSafeClassifier 集成 Jev,并给出两大应用场景:模型路由(根据任务复杂度自动选择低成本或高性能模型)和 Auto Mode(对危险工具调用进行分类守护,提升 Agent 可信度)。Jev 适合作为 LLM 的补充,在 Agent 循环中承担快速、低成本的分类决策。

技术 › Agent Sydney Runkle 2026-09-1811.3 KB 2M 5.6K 84

System One Models: What Comes After Agentic Software

文章介绍 TypeSafe 发布的 Jev 模型,一种用于快速语义决策而非生成或长推理的 System One 模型,延迟低至 70ms 且成本低廉。作者认为这类模型可将小型语义智能分散嵌入应用的各个决策点,而非集中于 Agent 循环中,从而推动微推理时代的到来。这将使代码库中包含更多非确定性判断,同时应用层更明确地掌控编排控制流,推理模型则退居处理模糊和复杂案例的升级路径。文章还探讨了围绕微推理所需的基础设施(批处理、缓存、模型路由),并以自动驾驶和 Waymo 的 ML-primary 架构类比这种通用语义模型进入控制循环的新范式。

技术 › LLM Josh Rosen 2026-09-1710.9 KB 14.2K 181 71

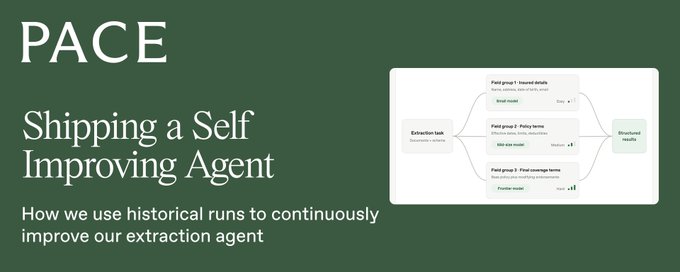
Shipping a Self-Improving Agent

文章介绍 Pace 公司如何在其保险文档提取 Agent 中实现自我改进。系统通过三个核心机制优化:1) 子代理委派——基于历史运行构建字段关系图,优化 fanout 分组,减少重复工作,降低 19% 成本和 16% 延迟;2) 模型路由——利用历史 trace 学习各子代理任务难度,将子任务路由到合适模型,部分场景成本降低 68% 且无精度损失;3) 上下文优化——通过 Review Agent 诊断错误根因、Proposer Agent 提出经验证的上下文或 Harness 修复,使每流程提取错误减少 75%。核心论点是随任务积累,系统可持续逼近最优的委派、模型与上下文组合。

技术 › Agent Arun J Moorthy 2026-09-169.0 KB 11.2K 156 77

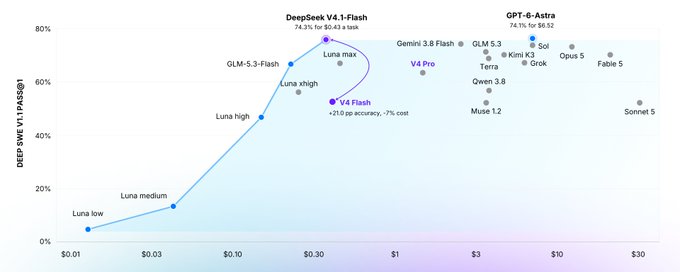
DeepSeek-V4.1-Flash on Fireworks: Astra-level DeepSWE at 1/15th the cost

Fireworks 发布的 DeepSeek-V4.1-Flash 在 DeepSWE 基准测试中以每任务 $0.43 的成本达到 GPT-6 Astra 级别的编码准确率,价格仅为 1/15。该模型采用 552B MoE 编码器-解码器分离激活架构(输入 8B、输出 16B 活跃参数),配合 KV Cache 优化(HBM 占用降至 1/4),在 Terminal-Bench 2.1 上以 12x 更低成本逼近 Astra。但在 HLE 学术推理上落后于 Astra;oracle 路由测试显示两模型组合可超越 Astra 单模型表现,凸显多模型路由系统的价值。

技术 › LLM Fireworks 2026-09-169.1 KB 24.1K 200 75

Put Claude Fable 5.1 and Gemini 3.8 Flash on the same team

本文介绍如何在 Google Cloud 的 Gemini Enterprise Agent Platform 上同时配置 Anthropic Claude Fable 5.1 与 Google Gemini 3.8 Flash 两款模型,并通过任务路由优化 token 成本(tokenomics)。作者指出单一模型路由全部任务是错误的:深度规划模型处理日常事务会浪费成本,而快速模型处理不可逆的复杂任务风险很大。文章详细演示了启用 Claude Fable 5.1 所需的数据共享配置(setPublisherModelConfig API)、Gemini 3.8 Flash 的调用方式,并建议先对常规任务做基准测试,以快速模型作为一线协调者、深度规划模型按需升级处理,从而大幅提升任务 ROI。

技术 › LLM Alan Blount (Google Cloud Tech) 2026-09-1518.4 KB 161.7K 894 82

BestBlogs 早报 · 09-12|开放权重模型降成本,HL-Mem 治理记忆,AI 使用心得重组 B 端需求协作

本期早报围绕 AI 落地的三个层面展开:先测量成本,再管理状态,最后明确责任。精讲一介绍 Uber、Pinterest、AT&T 通过开放权重模型、模型路由和基准测试,将单次请求成本降低 34%、会话成本降低 52% 的实践。精讲二解析大淘宝技术的 HL-Mem 系统,通过 Event 与 Claim 分离、双时间模型和显式遗忘机制,解决 Agent 长期记忆的证据、时间与冲突治理问题。精讲三分享京东技术的 B 端产品实践,把工作组织为 Prompt、Context、Harness 三层,AI 负责整理与生成,人负责业务判断与责任,使 34 人日工作压缩至 15 人日。速览还涵盖多智能体最佳实践、OpenAI 存储架构、AI 评估管道等内容。

技术 › LLM ginobefun 2026-09-1222.2 KB 3.8K 1 80

托管式 Agent 架构:为什么前沿实验室正在重构 Agent 循环

文章分析了 OpenAI Agents API、Anthropic Claude Managed Agents、AWS AgentCore Harness 和 Microsoft Foundry Agent Service 等托管式 Agent 基础设施的共同架构趋势。前沿实验室主张模型与 harness(代理执行框架)协同构建,以获得更好的效果。文中总结了四个关键模式:将 Agent 声明式资源化、为 Agent 引入版本化发布工程(含 A/B 测试)、在会话内动态选择模型实现解耦、以及将工具移出 Agent 之外的共享基础设施(MCP、Toolbox、Gateway)。作者提出开发者需要思考两个问题:应保留多少 Agent 循环的控制权,以及 harness 是否必须来自模型提供商。

技术 › Agent Josh Rosen 2026-09-1214.3 KB 46K 340 76

The software factory stack

本文由 Zach Lloyd 撰写,详细介绍了 Warp Factories 的软件工厂基础设施栈设计。该栈基于开放、可组合、代码定义的原则,分为五层:Factories-as-code(工厂即代码)、Data and context(数据与上下文)、Compute(计算)、Inference(推理)和 Improvement(改进)。文章逐层阐述了各层的核心组件与设计理念,强调版本化、可测试、可回滚的工厂定义,以及支持多模型、多代理、自托管和持续改进的基础设施,旨在帮助团队向工厂模式转型。

技术 › DevOps Zach Lloyd 2026-09-1013.4 KB 35.8K 351 79

Copy My $78k MRR Solo Agency (THE FULL SYSTEM)

作者分享了如何用AI将一人分发代理做到月经常性收入7.8万美元的完整系统。核心理念是:代理业务本质是七个循环(研究、筛选、生产、审核、策略、运营、客户维护),过去是七份工资,现在可用AI自动化。系统只需月成本约1400美元,服务9个客户。关键在于两个自我改进机制:每个部门维护自己的playbook.md,记录成功与失败经验并在每次任务后更新;结合模型路由层为不同任务分配最优模型。文章还提供12周构建顺序和真实单位经济数据。

技术 › Agent Ronin 2026-09-0865.2 KB 162K 651 82