Wiki 知识库

全部文档 / 作者: 雪瑜 / 标签: 量化

2 篇
清除

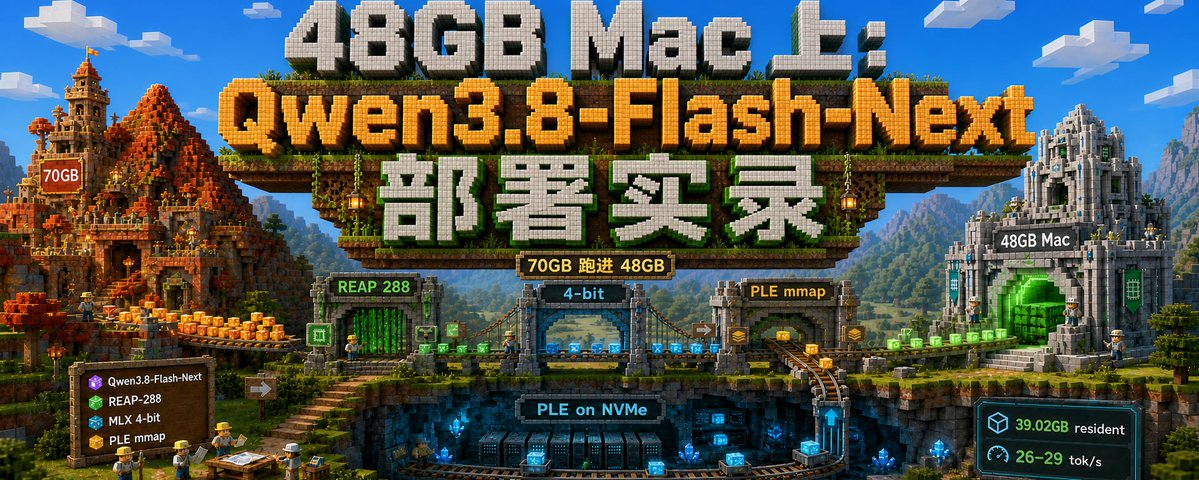
70GB 模型跑在 48GB Mac 上:Qwen3.8-Flash-Next 部署实录

作者在 48GB 内存 MacBook Pro(M4 Pro)上成功部署了磁盘体积约 70GB 的 Qwen3.8-Flash-Next REAP-288 MLX 4-bit 模型。文章解析了能跑起来的三重原因:REAP 将每层 512 个专家裁剪至 288 个、主模型与 PLE n-gram 表均做 4-bit 量化、以及 51B 参数的 PLE 表通过 mmap 留在 NVMe 按需流式读取。实际驻留约 39GB,首次加载约 10.14 秒,decode 稳定在 26~29 token/s,prefill 峰值约 149 token/s。实测最大上下文仅 8,217 tokens(配置声明 262K),建议日常使用 7,680 tokens。文章还记录了 Metal 内存上限调整、oMLX 服务启动及完整基准测试过程。

技术 › LLM 雪瑜 2026-09-0110.7 KB 55.5K 175 90

第一次下载本地大模型,如何看懂 Hugging Face 上的各种参数?

本文面向第一次在 Hugging Face 下载本地大模型的用户,讲解如何理解各种参数和名词。作者提出把整条链路分为五层:硬件资源、模型本身、权重精度与量化、文件格式、推理框架。文章依次解释了显存与统一内存的区别、参数量与文件大小的估算、Dense 与 MoE 架构差异、Base/Instruct/VL 等版本选择、BF16/FP8/4bit 等精度概念、GGUF 格式与量化方案、Safetensors 分片与配置文件、Hugging Face 页面阅读顺序,以及 MLX、llama.cpp、Ollama、LM Studio 等工具的关系,帮助新手不再凭文件名猜测下载。

技术 › LLM 雪瑜 2026-09-0118.8 KB 19.3K 196 86