Wiki 知识库

全部文档 / 标签: 模型推理

6 篇
清除

一篇文章带你祛魅算法工程师!

大厂在职算法工程师云辰 Cyan 撰文揭秘算法工程师职业真相。文章介绍了算法工程师的高薪现状:硕士校招 40-100 万,顶尖博士可超 150 万;并将岗位分为算法应用、模型推理、模型训练三个层级,指出 95% 的算法工程师从事的是'AI 赋能'类应用工作,门槛较低;而模型推理和基模训练则有较高技术壁垒。作者还提到当前校招竞争激烈(985 硕士+顶会论文+大厂实习已成标配),AI 人才供需失衡导致薪资倒挂,企业普遍存在 FOMO 心态。文章以幽默笔调对算法工程师这一职业进行了祛魅。

职场 › 职业发展 云 云辰 Cyan 2026-09-275.0 KB 58.8K 43 62

70GB 模型跑在 48GB Mac 上:Qwen3.8-Flash-Next 部署实录

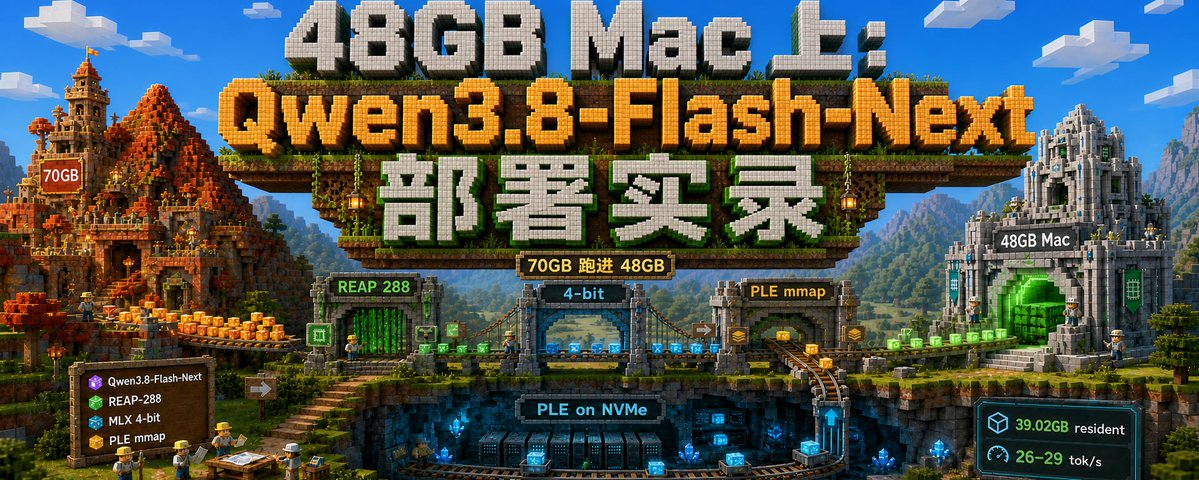
作者在 48GB 内存 MacBook Pro(M4 Pro)上成功部署了磁盘体积约 70GB 的 Qwen3.8-Flash-Next REAP-288 MLX 4-bit 模型。文章解析了能跑起来的三重原因:REAP 将每层 512 个专家裁剪至 288 个、主模型与 PLE n-gram 表均做 4-bit 量化、以及 51B 参数的 PLE 表通过 mmap 留在 NVMe 按需流式读取。实际驻留约 39GB,首次加载约 10.14 秒,decode 稳定在 26~29 token/s,prefill 峰值约 149 token/s。实测最大上下文仅 8,217 tokens(配置声明 262K),建议日常使用 7,680 tokens。文章还记录了 Metal 内存上限调整、oMLX 服务启动及完整基准测试过程。

技术 › LLM 雪瑜 2026-09-0110.7 KB 55.5K 175 90

从零安装Qwen3.8-27B:Mac本地部署与性能调优指南

本文详细介绍了如何在 Apple Silicon Mac 上从零部署 Qwen3.8-27B 模型。作者苏乐指出,普通 Mac 无需升级到最新 Mac Studio 即可运行该模型,关键在于算清内存账:模型权重、上下文缓存、运行缓冲、草稿模型和系统开销共享统一内存。文章对比了 4-bit、8-bit 和 BF16 量化版本的选择建议(24GB/32GB 选 4-bit,48GB/64GB 可选 8-bit),并提供了完整的部署流程:使用 uv 管理环境、通过 hf 命令下载模型、先测 baseline 速度再逐步开启优化。文章还解释了 DFlash 2 投机解码加速原理——通过轻量草稿模型并行提出候选 token,再由主模型验证,从而显著提升生成速度。

技术 › LLM 苏乐 2026-09-0137.3 KB 435.7K 623 85

Kimi K2.6 + Hermes:月成本从 $2550 降至 $85 的实践指南

本文介绍了如何利用 Kimi K2.6 模型配合 Hermes 系统,将原本使用 Claude Opus 的高昂开发成本(约 $2550/月)降低至 $85/月。文章详细分析了 Kimi K2.6 在 MoE 架构下的性能优势(如 SWE-Bench Pro 58.6%),展示了其在 12 小时自主编码和系统优化中的实战案例,并提出了“辅助模型模式”以进一步节省非关键任务的费用。作者还针对长上下文输出可能导致的成本陷阱提出了具体的优化策略。

技术 › LLM shmidt 2026-05-1226.6 KB 216K 395 92

AI 的记忆机制:从 KV Cache 到智能压缩

文章深入探讨了 AI Agent 遗忘信息的根本原因。作者指出,问题通常不在于检索,而在于 KV Cache 在上下文过长时的处理机制。文章对比了 StreamingLLM(仅保留近期信息)与 SnapKV(基于注意力分数保留关键信息)的区别,并解释了模型如何通过“注意力权重”来决定哪些 Token 值得被记忆,从而实现 92% 的压缩比且不丢失关键信息。

技术 › LLM Siddharth 2026-04-2915.4 KB 134.9K 253 74

LLM 中的 KV 缓存机制详解

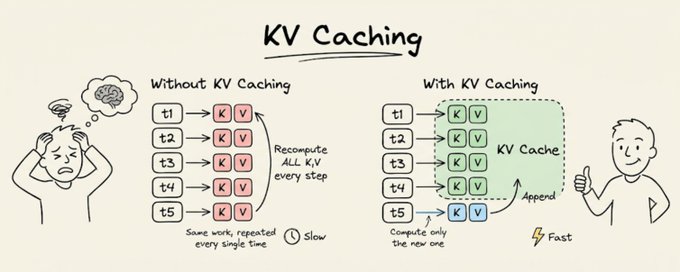
文章深入解释了大型语言模型(LLM)中的 KV 缓存技术。作者指出,LLM 生成文本时首个令牌较慢而后续令牌迅速的现象,归功于 KV 缓存的工程优化。该技术通过存储已计算键值向量,避免在自回归生成过程中的冗余计算,以 GPU 内存为代价换取显著的计算加速。文中详细解析了注意力机制的冗余问题、KV 缓存的工作原理、首令牌延迟(TTFT)的产生原因,以及内存与计算资源之间的权衡取舍。

技术 › LLM Avi Chawla 2026-03-226.3 KB 1.8M 2.9K 69