Wiki 知识库

全部文档 / 标签: llama.cpp

12 篇
清除

一个人十天写出的引擎,让 12GB 显卡跑起 1250 亿参数模型

个人开发者用十天时间(代码大部分由 AI 编写)打造了推理引擎 Strata,能让 12GB 显存的普通电脑运行 1250 亿参数的 Qwen 3.8 Flash Next 模型。文章剖析其六倍速度宣传实为不同量化版本对比,同版本实际是两到四倍;真正亮点是 prompt 读取速度达每秒 1500 token。核心技术是围绕 MoE 架构的专家缓存,命中率约 72%,代价是输出可能偏离原模型结果。文章还对比了买内存自建与云端 API 的成本账,并预判通用引擎 llama.cpp 将在几个月内补齐缓存能力。

技术 › LLM Saito 2026-10-218.8 KB 1.5K 4 84

Karpathy的本地LLM加速技巧终于有了完整解决方案:Uzu推理引擎

文章回顾了Karpathy在2023年指出的本地LLM推理瓶颈:解码阶段受限于内存带宽,每次前向传播只生成一个token,使得推理速度存在硬上限。以M5芯片和4-bit Qwen3.5 9B为例,理论极限约29 token/s,llama.cpp和MLX接近该上限。开源推理引擎Uzu通过组合优化突破瓶颈:采用4-bit/8-bit整数量化降低内存流量,利用M5的int8硬件加速路径,在量化前应用块对角随机Hadamard变换抑制离群值误差,并通过推测解码一次性验证多达16个草稿token。实测Uzu在M5上达到92-117 token/s,显著超越llama.cpp和MLX。

技术 › LLM Akshay 2026-10-0928.4 KB 115.2K 257 78

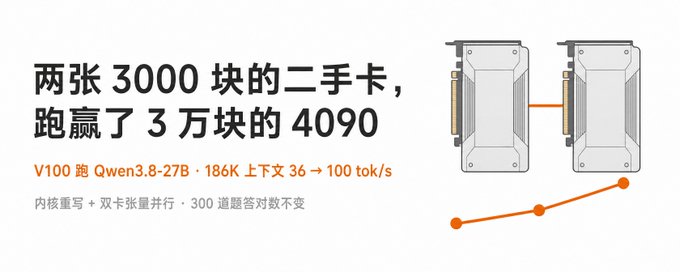
万字爆肝长文丨两张 3000 块老卡跑赢 3 万块 4090 48G:一次讲透怎么老显卡把 Qwen3.8-27B /NInfer跑到极致

作者详细记录了用两张二手 V100(各 3000 元)运行 Qwen3.8-27B 大模型的完整优化过程。V100 是 2017 年的数据中心显卡,HBM 显存带宽实测达 1004GB/s,甚至高于 4090。文章先建立测试口径与性能分析框架(读权重与读 KV 缓存两笔账),逐步排查瓶颈:验证带宽不是问题、测试双卡张量并行、分析 PCIe 延迟与 NCCL 版本坑,最终通过重写推理引擎内核、添加双卡支持,将长上下文生成速度从 36 tok/s 提升到 100 tok/s 以上,代码生成速度超过 3 万元的 4090 48G,并成功上线生产环境。文中深入浅出讲解了推测解码、CUDA Graph、内核优化等技术细节。

技术 › LLM huangserva 2026-10-0489.4 KB 141.5K 319 89

推理工程入门指南

本文介绍了推理工程的概念、重要性及入门方法。推理工程负责在满足产品需求(正确性、响应时间、可靠性和成本)的前提下运行已训练模型,涵盖模型选择、评估、服务、性能优化和运维。软件工程师可凭借API设计、性能分析、缓存等技能进入该领域。文章通过vLLM、SGLang和llama.cpp三个开源项目,展示了如何解决高并发、重复计算和硬件适配等实际问题,并强调定义工作负载和复现问题的重要性。

技术 › LLM danialhasan 2026-09-1418.6 KB 54.5K 526 78

如何在本地运行开源 GLM-5.3-Flash 模型

本文详细介绍在个人机器上本地部署 GLM-5.3-Flash(320B 总参数、激活约 18B 的 MoE 模型)的完整流程。作者首先澄清显存误区:即使激活参数小,仍需容纳完整权重,最小 GGUF 量化文件即超 93GB,100GB 内存是起跑线。教程提供两条路线:一是使用图形化的 Unsloth Desktop 快速上手;二是编译支持 glm5next 架构的 llama.cpp 专用分支,并启动兼容 OpenAI 接口的本地服务。文章还涵盖硬件需求估算、量化版本选择建议(UD-IQ2_XXS 适合 128GB 机器)、常见报错排查与性能优化要点。

技术 › LLM 极客开源 2026-09-0711.5 KB 3.9K 13 86

第一次下载本地大模型,如何看懂 Hugging Face 上的各种参数?

本文面向第一次在 Hugging Face 下载本地大模型的用户,讲解如何理解各种参数和名词。作者提出把整条链路分为五层:硬件资源、模型本身、权重精度与量化、文件格式、推理框架。文章依次解释了显存与统一内存的区别、参数量与文件大小的估算、Dense 与 MoE 架构差异、Base/Instruct/VL 等版本选择、BF16/FP8/4bit 等精度概念、GGUF 格式与量化方案、Safetensors 分片与配置文件、Hugging Face 页面阅读顺序,以及 MLX、llama.cpp、Ollama、LM Studio 等工具的关系,帮助新手不再凭文件名猜测下载。

技术 › LLM 雪瑜 2026-09-0118.8 KB 19.3K 196 86

一次性讲清楚 Qwen3.8 27B 的本地部署

本文详细介绍如何在本地部署阿里开源的 Qwen3.8 27B 模型,覆盖 Mac 和 N 卡两条路线,并附 4090 实测数据。作者通过四轮质量测试发现 9.83GB 压缩版在短任务上与 30GB 版本打平,指出 12GB 游戏卡即可运行。文章系统讲解硬件选型、量化版本选择、KV Cache 显存计算、MTP 加速配置及常见踩坑,强调窗口大小只占显存不影响速度这一关键认知,是一篇面向零基础用户的完整部署指南。

技术 › LLM huangserva 2026-08-2571.4 KB 296.8K 683 91

10款值得在本地运行的开源AI工具

文章介绍了10款免费开源、可在本地运行的AI工具,涵盖从模型引擎到日常应用的完整技术栈:llama.cpp作为本地推理引擎,Qwen3作为开源模型,AnythingLLM提供本地知识库聊天,whisper.cpp实现本地语音转文字,Kokoro-82M负责文本转语音,Immich用于自托管照片管理,Tabby提供本地代码补全,ComfyUI支持本地图像生成,Activepieces实现自动化工作流。每个工具均通过免费开源、本地运行、持续更新、有公开证据四项筛选标准,帮助用户摆脱云端订阅和数据外流。

技术 › 工具与效率 Alex Veremeyenko 2026-08-2510.5 KB 8.8K 23 78

本地部署的Ling-3.0-tiny实测:7.9B小模型能把活干好吗

作者在128GB统一内存小主机上本地部署开源MoE模型Ling-3.0-tiny(7.9B参数,激活1.3B),用llama.cpp Vulkan加载Q8_0量化版本。实测任务是将2360行、2小时17分的客户会议飞书妙记转写交给模型,进行需求提取、实施方案搭建和报价结构整理。结果显示:模型能在235秒内完成需求提取,方案模块划分与人工方案接近,但时间戳偶有不准需人工复核。经提示词调优后,碰撞长度上限次数从16次降至3次。作者认为它适合承担会议整理、需求归类等“脏活”,但范围、价格、承诺等决策仍需人负责,并推荐在真实业务场景中使用。

技术 › LLM 阿川 | AI thinking 2026-08-247.6 KB 20.7K 59 78

16GB 无独显本地部署 Ling-3.0-tiny 实测:21.7 token/s 与推理引擎版本的秘密

作者在一台单通道 16GB 内存、无独显的 Ryzen 5 5600G 台式机上,使用 llama.cpp 官方版部署 Ling-3.0-tiny(Q4KM 量化),实测生成速度 21.70 tok/s,比配置更强的 64GB+3090 机器快近 4 倍。经排查,差异源于推理引擎版本而非硬件。文章还分析了该模型线性注意力架构带来的超低上下文内存开销(约 6.79 KiB/token),总结了思考模式、Windows 编码、线程设置三个实践坑,并给出三步部署教程,证明普通电脑即可流畅本地运行该模型。

技术 › LLM 阿良|AI 工作流 2026-08-2414.2 KB 71.3K 177 90

Qwen3.8-27B 本地部署教程(全网最详细版)

本文详细介绍了阿里通义千问团队发布的Qwen3.8-27B模型的本地部署方法。文章首先分析了不同硬件配置下可选的模型量化版本,然后提供了两套部署方案:一是使用GGUF+llama.cpp,适合24GB显存或Apple Silicon用户;二是使用官方FP8+vLLM,适合48GB以上NVIDIA显存用户。此外,还介绍了如何将模型接入IDE、Agent或自定义应用,并总结了常见的五个部署陷阱及解决方案。最后,作者强调了本地部署在数据隐私、模型可控性和理解底层技术方面的价值。

技术 › LLM Smartpig 2026-08-1510.3 KB 60.1K 342 91

35B 越狱版大模型:Codex 替你装,6GB 老卡也能跑

本文介绍了一种利用 Codex 桌面应用在 Windows 上本地部署 35B 无审查大模型的方法。通过 llama.cpp 和 MoE 架构的量化模型,即使用户只有 6GB 显存的显卡(如 GTX 1660)也能以 30 t/s 的速度流畅运行。文章详细讲解了无需命令行知识、利用 Codex 自动完成环境配置、模型下载及脚本编写的全流程,实现了零门槛的本地高隐私 AI 体验。

技术 › Codex Wei 2026-05-2823.3 KB 129.4K 232 92