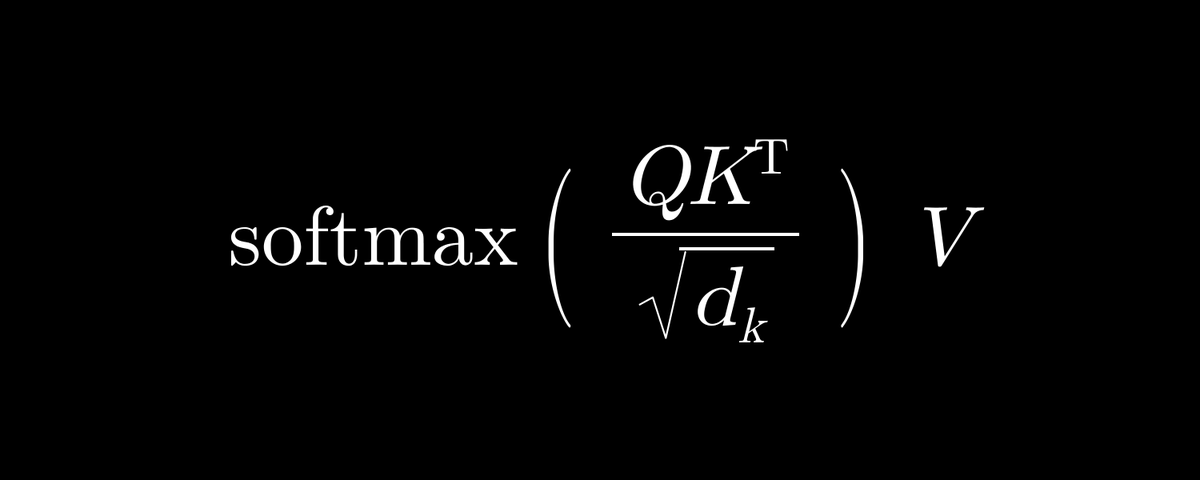
Wiki 知识库

全部文档 / 作者: Akshay

32 篇
清除

Karpathy的本地LLM加速技巧终于有了完整解决方案:Uzu推理引擎

文章回顾了Karpathy在2023年指出的本地LLM推理瓶颈:解码阶段受限于内存带宽,每次前向传播只生成一个token,使得推理速度存在硬上限。以M5芯片和4-bit Qwen3.5 9B为例,理论极限约29 token/s,llama.cpp和MLX接近该上限。开源推理引擎Uzu通过组合优化突破瓶颈:采用4-bit/8-bit整数量化降低内存流量,利用M5的int8硬件加速路径,在量化前应用块对角随机Hadamard变换抑制离群值误差,并通过推测解码一次性验证多达16个草稿token。实测Uzu在M5上达到92-117 token/s,显著超越llama.cpp和MLX。

技术 › LLM Akshay 2026-10-0928.4 KB 115.2K 257 78

Agent Memory Is Not a Search Problem

文章指出 Agent 记忆系统的核心问题不是检索而是上下文组织。跨 15 个模型、20 万模拟对话的研究显示,任务拆分为多轮会使准确率平均下降 39%,而合并为单轮可恢复大部分损失。文章回顾了 Agent 记忆的四个发展阶段(全量历史、滚动摘要、向量检索、知识图谱),批评语义/情景/程序性记忆分类无法指导检索决策,并主张按六种问题类型构建六种上下文形态。作者基于开源 Graphiti 引擎,以客户历史为例实操演示如何让记忆系统在模型运行前正确组织上下文,避免基于过时信息的自信回答。

技术 › Agent Akshay 2026-09-2919.3 KB 27.4K 171 86

Jev Clearly Explained

文章介绍了 TypeSafe 于 2026 年 9 月发布的 Jev 模型——一个专注于快速、低成本语义决策的"系统一"模型。传统 LLM 在智能体循环中处理大量小型判断(如工单分类、命令风险评估)时逐 token 生成,速度慢且成本高。Jev 通过三种原语(Choice、Score、Noul)接受非结构化输入,返回带概率的类型化答案,端到端延迟 70-500 毫秒,输入价格仅为 LLM 的一小部分。文章分析了概率置信度在自动决策中的作用、RLCD 校准训练方法,并澄清"无法幻觉"的说法:Jev 不会打破输出 schema,但仍可能自信地选错选项,适合与 LLM 配合而非替代。

技术 › LLM Akshay 2026-09-1916.0 KB 2.4M 5.6K 79

LLM 路由可能比不路由成本更高

文章探讨 LLM 路由(LLM Routing)的成本悖论:理论上将简单任务分配给廉价模型可节省大量成本(如 RouteLLM 实现约 85% 降本),Uber 因给 5000 名工程师统一部署 Claude Code 导致年度 AI 预算提前耗尽的案例也说明单一模型定价的问题。但传统路由方案在生产中会因四大失败模式而失效:分类调用额外计费、通用模型意图识别能力差、路由逻辑缺乏评估易腐化、以及模型切换破坏 KV 缓存导致全价重算。文章随后介绍 DigitalOcean 基于开源代理 Plano 的基础设施级路由方案:使用 1.5B 参数的专用路由模型(Arch-Router / Plano-Orchestrator)在代理内完成意图解析,准确率超越前沿大模型且更快,再结合成本与延迟数据对候选模型池按策略排序,实现成本与质量兼顾的动态路由。

技术 › LLM Akshay 2026-09-0715.7 KB 49.9K 475 75

LLM 注意力机制详解:从 Self-Attention 到 MLA

文章系统讲解了 Transformer 中各类注意力机制的演进:从自注意力、因果注意力、交叉注意力的基础概念,到 Multi-Head Attention(MHA)的表达力与显存代价,再到 MQA 通过共享 KV 头缩减缓存、GQA 在质量与内存间取得平衡成为主流、DeepSeek 提出的 MLA 通过低秩潜空间压缩 KV 缓存,以及 FlashAttention 通过改变内存访问方式优化计算效率。核心驱动力是 KV cache 的显存约束:长上下文大模型的注意力状态存储可与模型权重相当。每种机制都是为了解决前一设计的缺陷而诞生。

技术 › LLM Akshay 🚀 2026-09-0513.4 KB 191.5K 577 75

Static vs. Dynamic vs. Continuous Batching in LLMs, clearly explained

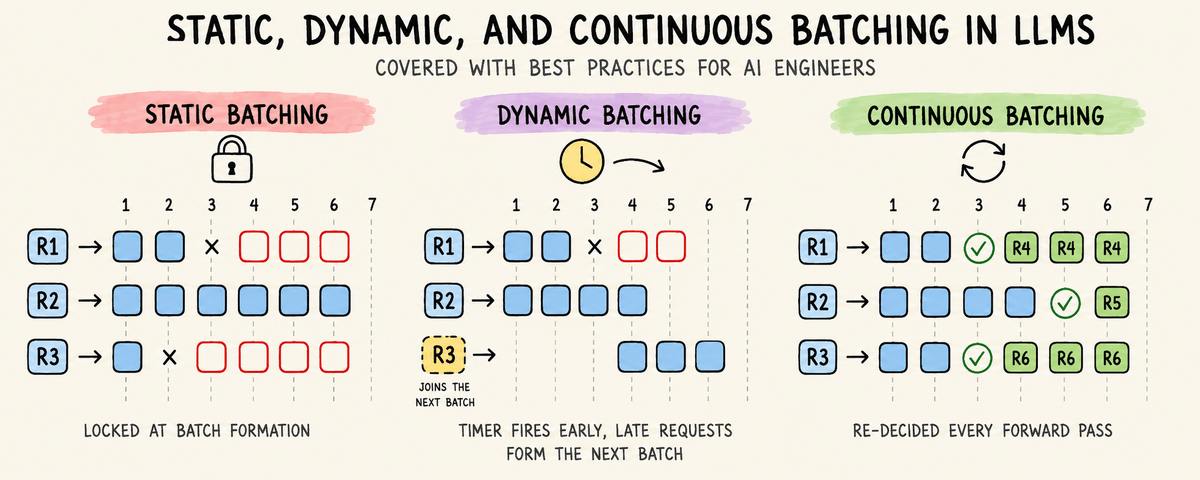
文章从第一性原理剖析了 LLM 推理服务中三种批处理策略。现代 GPU 在 LLM 解码时受显存带宽限制,计算单元大量空闲,批处理可将权重读取成本分摊到多个序列以提升吞吐。由于自回归解码的输出长度不可知、序列间相互依赖,传统批处理存在短板:静态批处理在批开始时一次决定,受最慢成员拖累;动态批处理加入定时器,缓解入批等待但仍整批绑定;连续批处理(iteration-level scheduling)在每次前向传播后重新调度,完成的序列立即让位给排队请求,是现代推理引擎高吞吐的关键。文章还讨论了固定输出场景下静态批处理的适用性,并给出 vLLM 和 Triton 的配置示例。

技术 › LLM Akshay 2026-09-0112.8 KB 57.2K 285 78

WebMCP Clearly Explained

Google 和 Microsoft 正在共同推动 WebMCP——一个由 Chrome 与 Edge 团队开发的浏览器 API,让网站能够向 AI Agent 声明自己可执行的操作。文章对比了 Agent 访问应用的六种方式(原始 API、后端 MCP 服务器、computer use、浏览器自动化、WebMCP、内置助手),指出 WebMCP 是唯一同时满足'使用自己的 Agent、零配置、获得真实具名操作'三个条件的方案。声明式描述优于让 Agent 从像素猜测:无需 API key、登录随浏览器会话免费获得、可用操作随页面状态动态变化、支持 JSON Schema 兼容主流模型。文章还展示了注册工具的 JavaScript 代码与纯 HTML 表单的极简接入方式,认为这可能是多年来 Web 最大的变革。

技术 › Agent Akshay 2026-08-298.8 KB 142.8K 853 86

用 Grok Bot 搭建一支 AI 工程团队

文章介绍如何用四个专业化 Agent(项目经理 Piper、后端 Bay、前端 Fin、测试 Tess)组成一个多智能体工程团队,解决多 Agent 协作中交接时上下文丢失的经典问题。Grok Bot 的优势在于所有 Bot 共享同一台持久化云计算机器,状态以文件形式保存在磁盘上,消息只传递路径,使接手的 Bot 能完整继承前一 Bot 的知识。作者通过磁盘任务板 board.md、五个强制交接纪律的 Skill 以及 InsForge 后端平台实现全自动功能交付流水线。

技术 › Agent Akshay 2026-08-2732.7 KB 21.6K 161 76

使用 Seltz 构建多智能体 GTM 情报系统

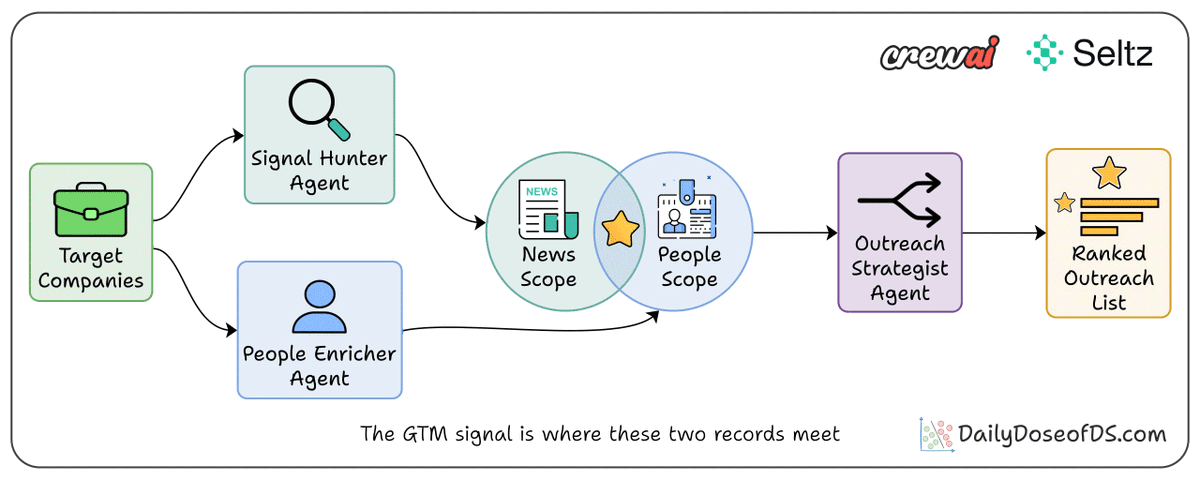
文章介绍了如何使用 CrewAI、OpenRouter 和 Seltz MCP 服务器构建一个多智能体 GTM(市场进入)研究管道。文章指出 GTM 研究的核心难题在于“连接问题”:触发信号(如新高管入职、融资)与人员背景信息分散在不同数据源中,传统搜索 API 只返回片段,需要大量抓取和拼装。Seltz 作为面向此场景的网络索引,单次调用即可返回完整结构化记录。管道由三个 Agent 组成:Signal Hunter 搜索目标公司的触发事件,People Enricher 获取相关人员的完整职业记录,Outreach Strategist 合并两者输出,生成带个性化首句的排序外联名单。

技术 › Agent Akshay 2026-08-2411.0 KB 33.1K 173 81

The Anatomy of a Claude Code Bill

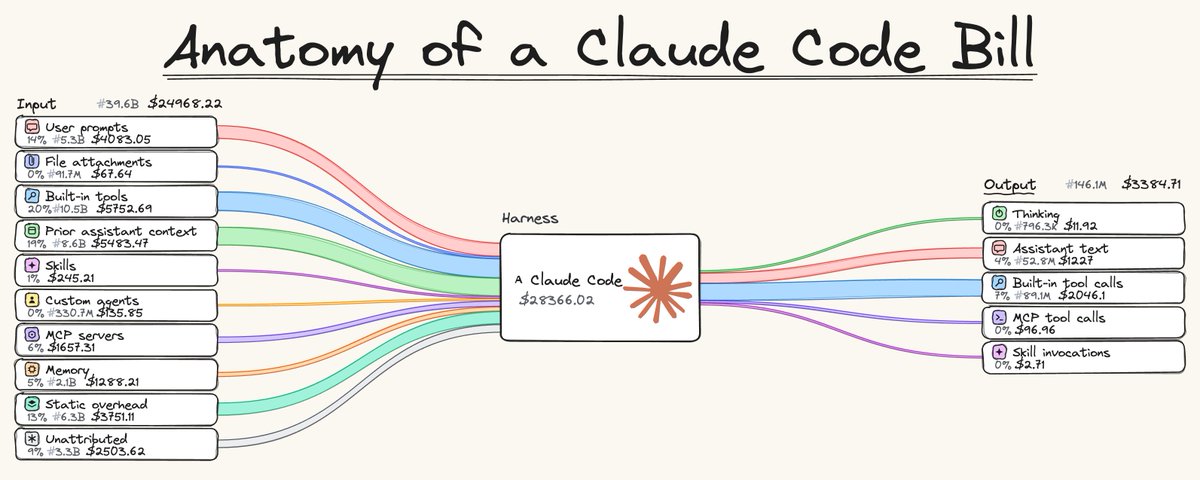
本文基于对45人工程团队30天的Claude Code使用追踪,剖析了其账单构成:真实用户提示仅占输入token的14%,其余为静态系统开销、CLAUDE.md与Skills、MCP服务器schema、工具结果回放及历史上下文等配置性开销。文章指出Uber等大规模部署中人均月支出高达500-2000美元,并介绍了Comet在Opik中推出的Cost Intelligence代理插件,通过token级可观测性帮助团队识别浪费,15分钟审计可削减20-40%账单。

技术 › Claude Code Akshay 2026-08-2412.8 KB 18.1K 139 75

How a GPU Actually Works

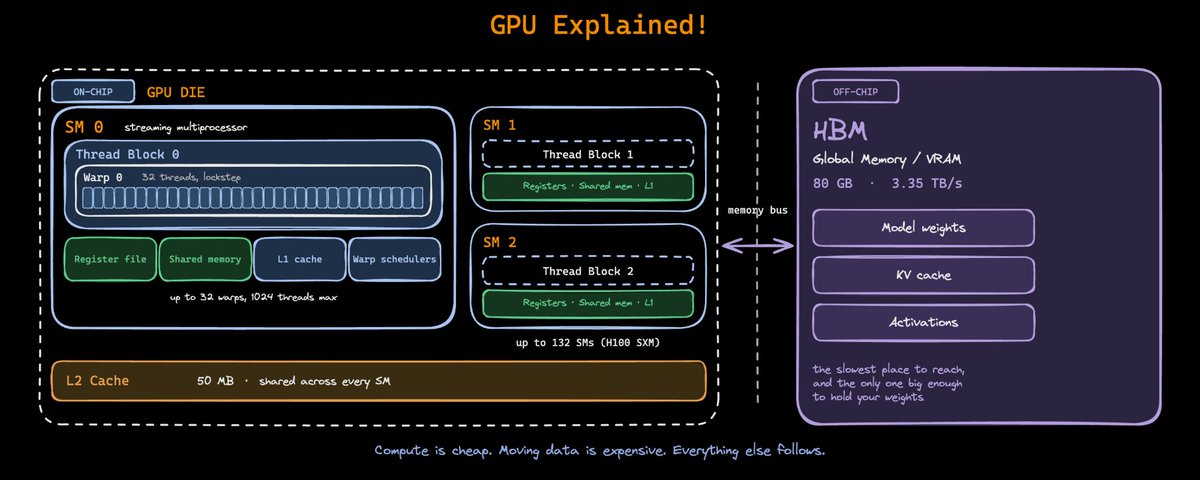
本文从硬件原理出发,解释了GPU为何在运行大模型时算力利用率低的现象。核心在于计算与内存带宽之间的不对称:算术操作便宜,而数据搬运昂贵。GPU通过大量简单计算单元和线程级并行来掩盖内存延迟,但受限于内存带宽,导致实际token生成速度远低于理论算力。文章还介绍了warp、分支分歧、内存延迟隐藏等概念,并指出性能优化技巧(如量化、投机解码、连续批处理)的本质是减少数据移动。

技术 › LLM Akshay 2026-08-1430.0 KB 853.2K 943 73

超越事实检索:AI Agent记忆系统中的模式识别与洞察

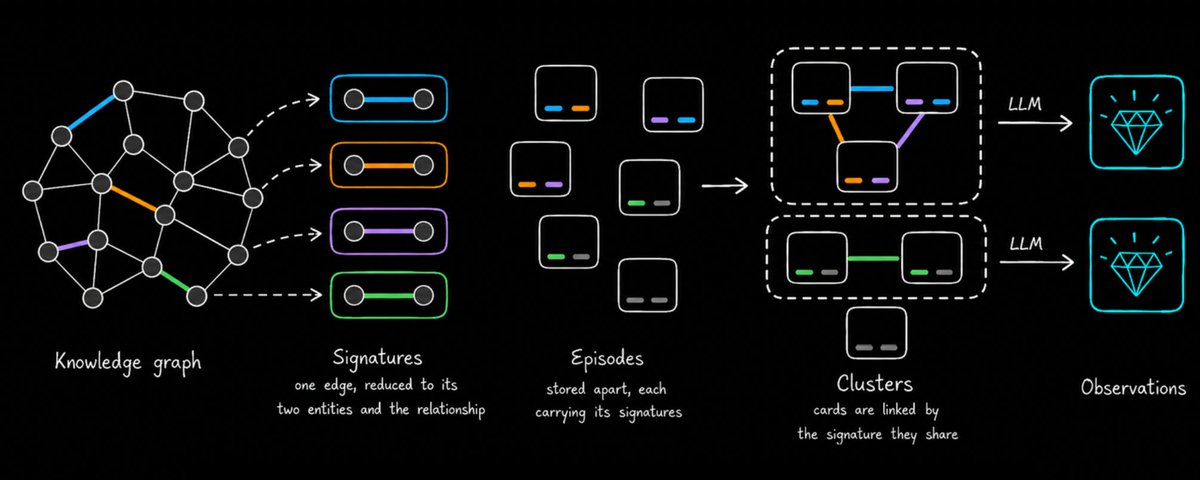
当前AI Agent的记忆系统虽能准确存储与检索单一事实,却无法像人类一样洞察事实间的结构关联。本文以项目管理为例,指出传统的检索优化无法解决这一局限。为此,Zep平台(开源Graphiti)引入了“Observations(观察)”功能,通过构建知识图谱,结合确定性算法聚类与LLM总结,跨实体分析并生成深度的上下文洞察。这种机制不仅能追溯证据,还能帮助Agent从全局视角识别如“核心阻塞点”等复杂问题。

技术 › Agent Akshay 2026-08-1013.7 KB 106.3K 517 81

你的 Agent 框架应该能够自我修复

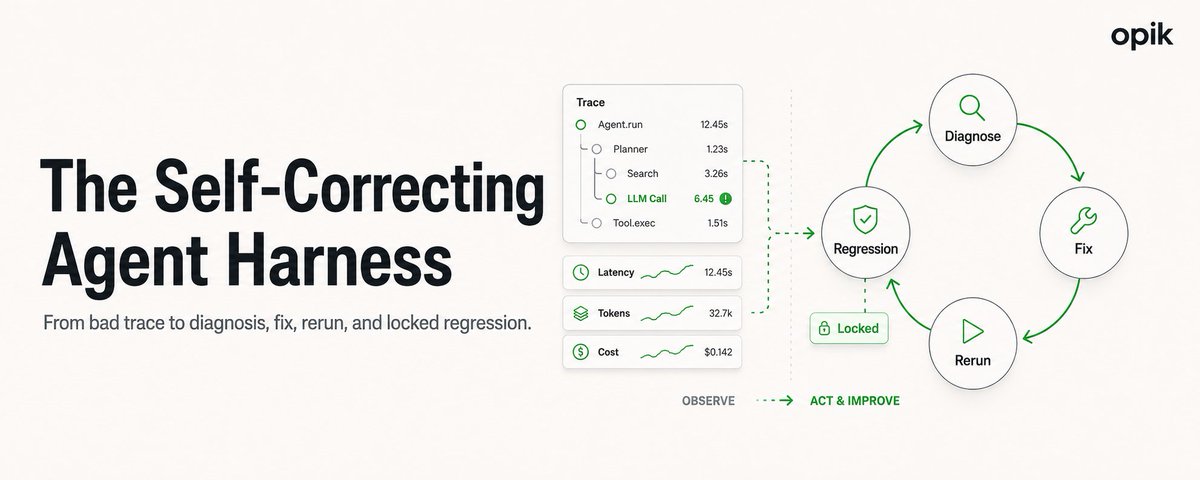
文章探讨了AI Agent在生产环境中失败时,传统可观测性工具仅能提供追踪数据,而无法自动解决修复问题的瓶颈。作者介绍了开源平台Opik,它通过四层架构(Tracing追踪、Ollie诊断与修复、Test Suites测试集、Agent Sandbox沙盒)形成闭环。该平台能自动诊断错误链路,内置代码代理提出修复方案,并将真实失败转化为回归测试,从而实现Agent框架的自我修复与持续优化。

技术 › Agent Akshay 2026-08-099.9 KB 1.8M 1.6K 84

Google和Anthropic对检索的共识:从单一应用到独立服务

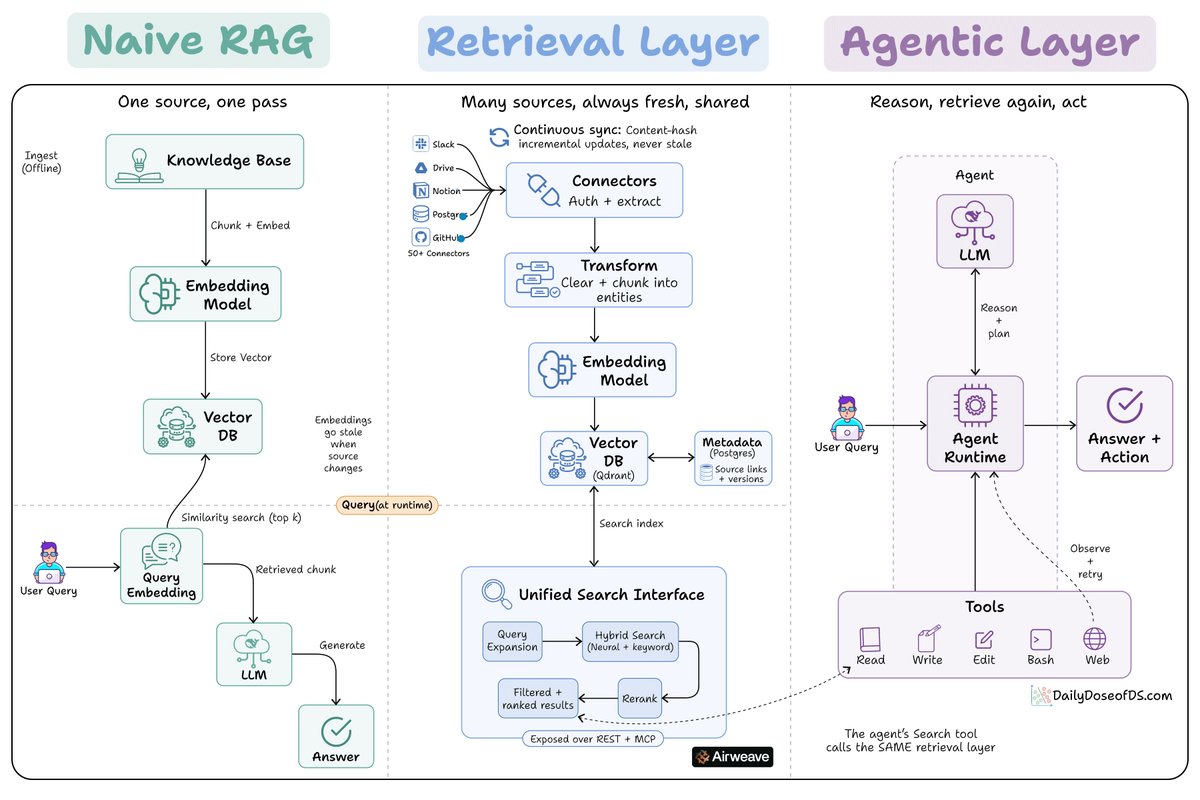
文章讨论了Google和Anthropic将检索从单一应用中移出,转变为独立服务的新趋势。这种分离解决了旧RAG设置中的过时嵌入和基础设施耦合问题。通过将摄取与查询分离,并使用结构化单元代替原始文本块,可以显著减少语料库大小并提高向量相关性。

技术 › LLM Akshay 2026-08-022.9 KB

Agents Need a New Kind of Web Search

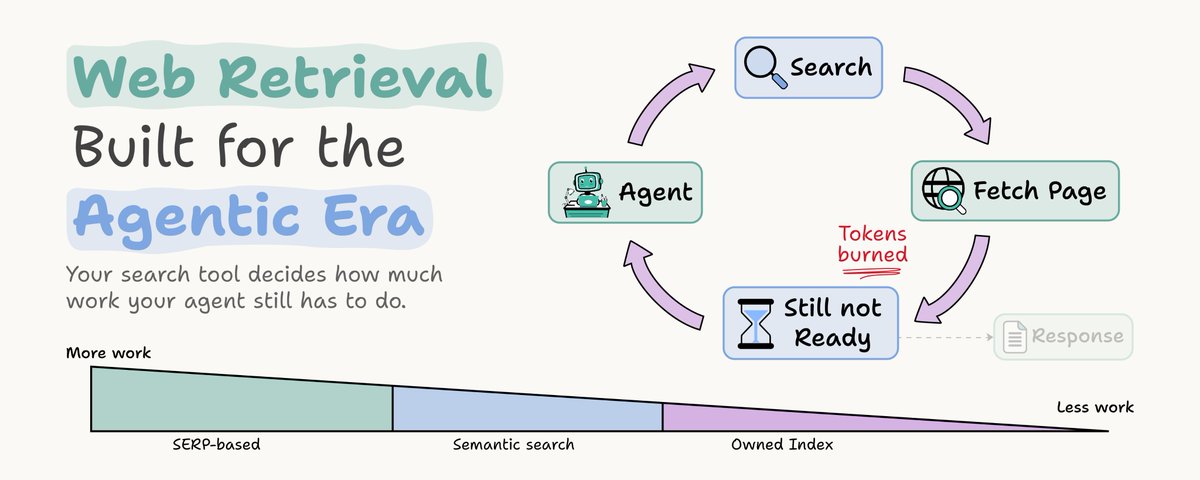
文章探讨了当前 AI Agent 在使用传统网页搜索时面临的“检索税”问题。传统搜索 API 仅返回链接和摘要,迫使 Agent 耗费大量 Token 去抓取和清洗内容。作者通过对比实验指出,使用预先爬取并结构化处理的索引(如 Seltz)能显著降低成本并提升效率,这种返回完整文档而非指针的方式是 Agent 搜索的未来。

技术 › Agent Akshay 2026-07-179.7 KB 72.1K 152

Let's build Claude Code's harness (step-by-step)

本文深入解析了Claude Code的“harness”架构,解释了为何简单的模型调用不足以构建可靠的代码代理。作者通过CrewAI框架逐步重建了包括核心循环、工具管理、规划机制在内的关键组件,揭示了通过工程化手段弥补模型差距的方法。

技术 › Claude Code Akshay 2026-07-1641.0 KB 306.3K 899

如何从头构建一个 RL 环境:以 Othello 游戏为例

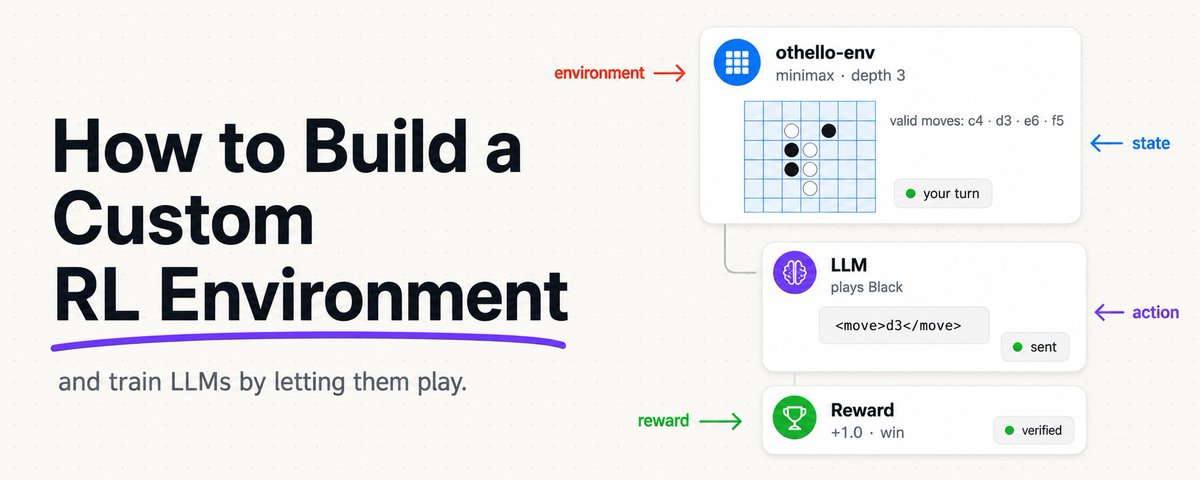
本文介绍了如何使用 Prime Intellect 的 Verifiers 框架从零开始构建一个用于强化学习(RL)的 Othello(黑白棋)游戏环境。文章解释了 RL 循环的基本组成部分(状态、动作、奖励、环境),并利用 GRPO 算法替代传统的人工偏好模型。文中详细展示了技术栈、游戏循环逻辑以及内置的 Minimax 对手引擎代码,旨在帮助开发者理解并掌握构建模型无关的 RL 环境的核心方法。

技术 › Agent Akshay 2026-07-0730.5 KB 61.5K 178

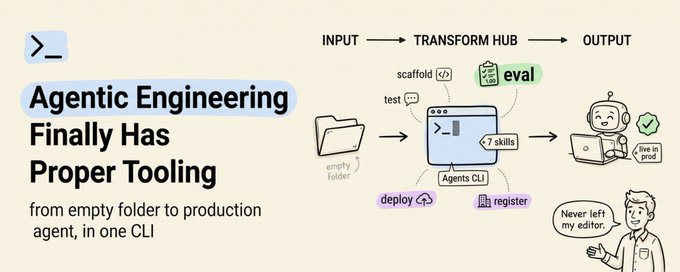
Karpathy's Agentic Engineering Finally Has Proper Tooling

文章介绍了 Google 发布的 Agents CLI 工具,它填补了 Karpathy 所定义的“代理工程”中的工具链空白。该工具将脚手架搭建、评估循环和部署整合到一个工作流中,并将 7 种核心技能注入到 Claude Code、Cursor 等编码 Agent 中。作者演示了如何利用该工具从零开始构建、评估、部署并注册一个企业级 RAG Agent,实现了仅通过自然语言指令即可完成从开发到生产环境的全生命周期管理。

技术 › Agent Akshay 2026-06-288.8 KB 780.8K 1.4K

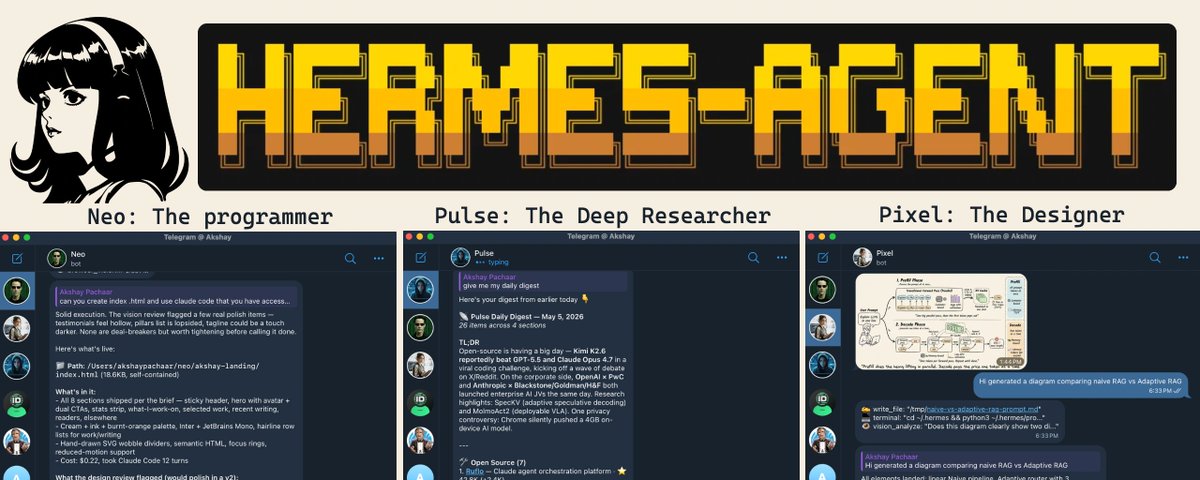
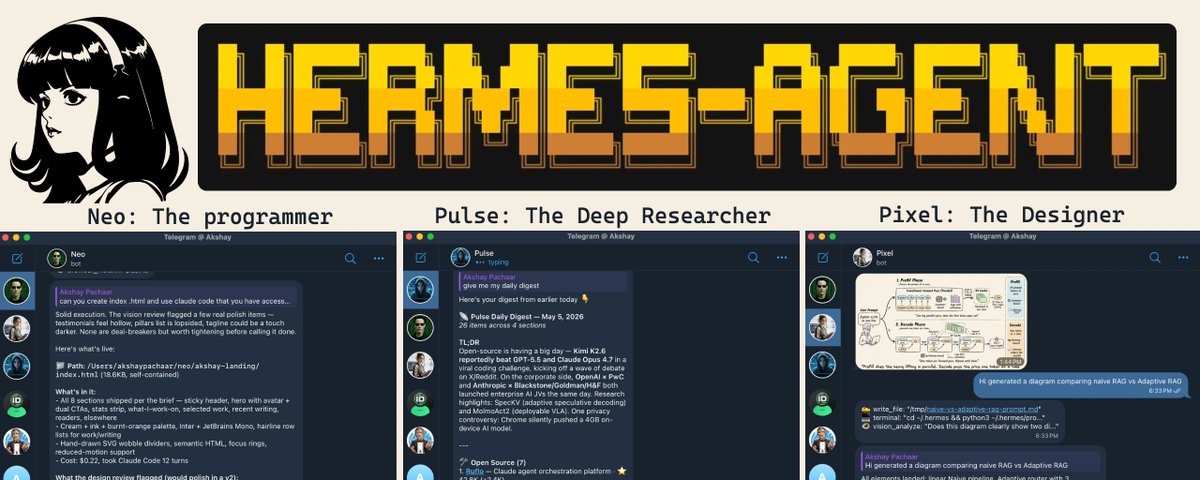
Hermes Agent 进阶指南:从架构原理到构建自进化的多智能体系统

本文深入介绍了 Nous Research 开源项目 Hermes Agent。文章详细解析了其独特的“学习闭环”架构,该架构结合了三层持久化内存、自进化技能系统以及 GEPA 优化引擎,解决了传统 Agent 随会话结束而遗忘的问题。文中还将 Hermes 与 OpenClaw 进行了对比,并提供了从零开始配置多个个性化 Agent(程序员、研究员、设计师)的实战教程,旨在帮助开发者打造能够 24/7 运行且持续学习的个人 AI 队伍。

技术 › Hermes Akshay 2026-05-2856.5 KB 5.8M 6.5K 88

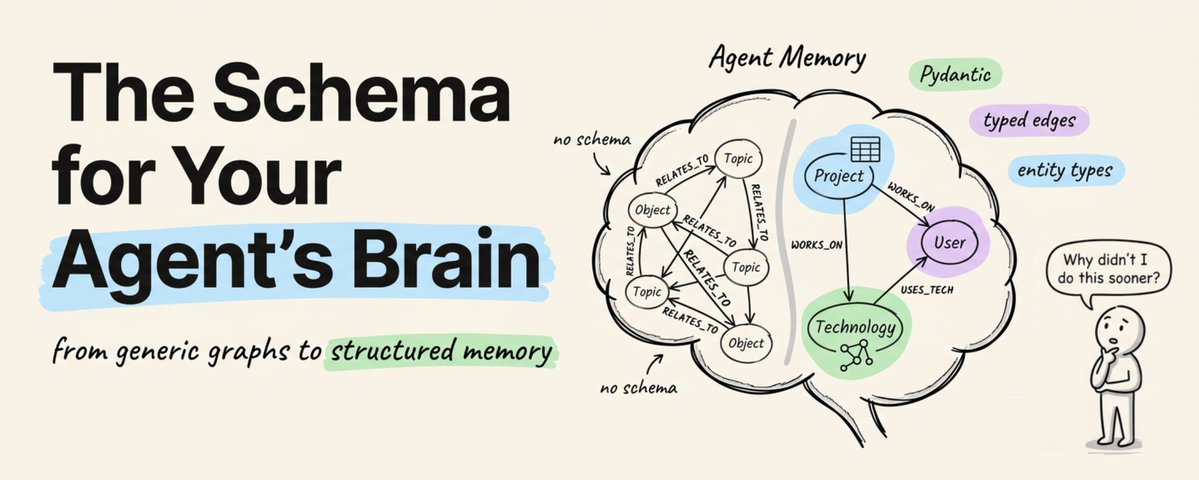
Pydantic fixed my Agent's Memory

文章探讨了如何解决 AI Agent 记忆系统的多跳推理问题。传统的向量数据库在处理跨块事实连接时失效,而通用知识图谱常因缺乏结构导致查询噪音。作者提出的解决方案是使用 Pydantic 提前定义本体(Schema),明确实体类型、关系和属性。通过 Zep 框架强制执行这些约束,可以显著提升提取的准确性和数据的可查询性,从而实现有效的多跳推理。

技术 › Agent Akshay 2026-05-2612.5 KB 312.9K 567 80

Hermes Agent Masterclass:架构详解与实战指南

本文是 Hermes Agent 的深度教程。Hermes 是一个能够在使用中不断自我进化的 AI Agent,与 OpenClaw 等其他 Agent 不同,它具备跨会话记忆、自编写/修剪技能以及通过 GEPA 引擎进行离线验证的独特能力。文章详细剖析了其包含 SOUL.md 身份层在内的三层记忆系统,并指导读者如何从零配置运行多个具备独立个性的 Agent。

技术 › Hermes Akshay 2026-05-1456.4 KB 88

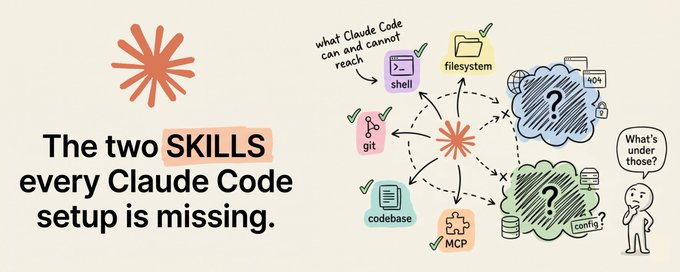
修复 Claude Code 的两大盲点:网页抓取与后端集成

文章指出 Claude Code 在网页抓取和后端集成(如 Supabase)方面存在两个主要盲点,导致 Token 消耗巨大且效率低下。作者介绍了两个开源工具来解决这些问题:Bright Data 负责高效抓取网页数据(包括 JS 渲染和反爬虫页面),InsForge 则作为后端上下文工程层优化数据库交互。作者演示了如何结合这两个工具,仅用一个 Prompt 就基于 YouTube 教程成功构建了一个包含 Google OAuth 和 AI 聊天功能的 Google Docs 克隆应用。

技术 › Agent Akshay 2026-05-047.5 KB 209.4K 229 82

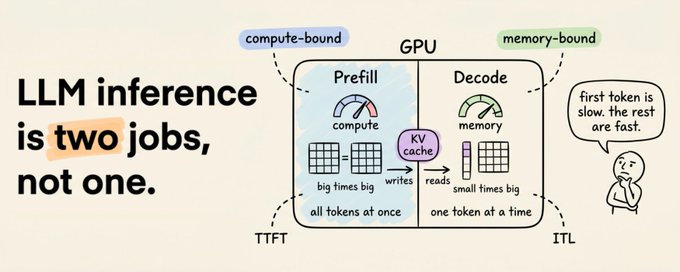
LLM 推理原理:从 Prompt 到流式响应的全流程解析

文章深入剖析了大语言模型(LLM)的推理过程。首先介绍了文本如何通过分词和嵌入转换为向量,接着详细解释了 Transformer 层中的自注意力机制与前馈网络如何协同工作。文章重点揭示了推理过程的两个不同阶段:处理输入时的“预填充”阶段受算力限制,而生成输出时的“解码”阶段受内存带宽限制,这种性能差异导致了首个token与后续token生成速度的不同。

技术 › LLM Akshay 2026-05-0313.8 KB 352.5K 849 71

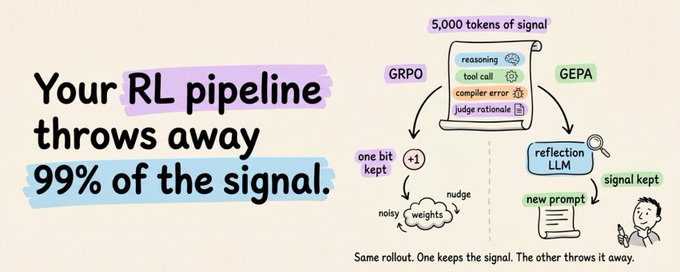
无需更新权重的 GRPO 替代方案:GEPA 算法解析

文章介绍了 Berkeley 团队提出的 GEPA 算法,该算法作为 GRPO 的替代方案,无需更新模型权重或进行 GPU 训练,仅通过优化提示词(Prompt)即可在 HotpotQA 等基准测试中取得更优成绩。GEPA 的核心在于利用 LLM 读取完整的推理轨迹,通过自然语言反思来迭代优化多模块系统中的每个提示词,从而避免了强化学习中将丰富信息压缩为单一标量信号的信息损耗问题。

技术 › LLM Akshay 2026-05-0113.7 KB 272.4K 371 83

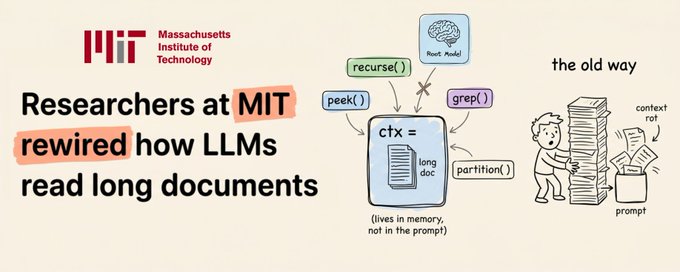
Recursive Language Models (RLMs) 清晰解释:解决大模型长上下文推理难题

文章介绍了一种称为递归语言模型(RLMs)的新方案,旨在解决大语言模型在处理超长上下文时出现的“上下文腐烂”问题。RLMs 不再将上下文限制在单一 Prompt 中,而是将其视为外部数据,通过赋予模型窥探、正则匹配、分区和递归调用等工具,让模型自主决定如何分解和处理任务。这种方法不仅消除了上下文长度对推理能力的影响,还提高了准确性和成本效率。

技术 › LLM Akshay 2026-04-2812.6 KB 131.6K 441 68

如何构建深度研究系统:超越 OpenAI 的开源方案

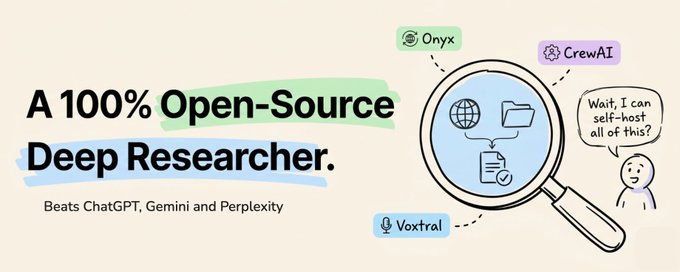
文章介绍了如何构建一个完全开源、可本地部署的深度研究系统。该系统由 Onyx(检索层)、CrewAI(编排层)和 Voxtral(语音层)组成。通过三阶段执行流程、自适应策略和六阶段检索管道,Onyx 在 DeepResearch Bench 排名第一,超越了 OpenAI 和 Gemini。文章强调了数据隐私的重要性,并详细拆解了实现高质量自我托管研究的架构细节。

技术 › Agent Akshay 2026-04-2427.4 KB 108.3K 778 88

Claude Opus 4.7 迁移指南:从 4.6 平滑升级的最佳实践

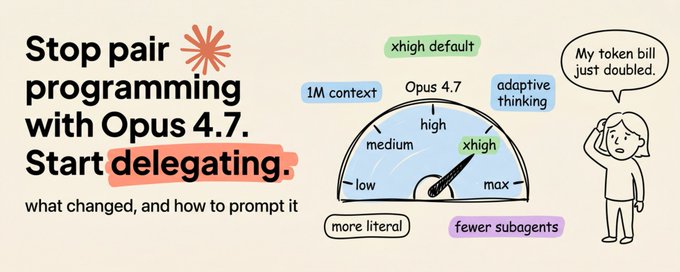
本文详细分析了 Claude Opus 4.7 与 4.6 的关键差异。新版模型采用了自适应思考机制、更严格的指令遵循以及 xhigh 默认算力等级。文章指出了升级后成本增加和召回率下降的原因,并提供了具体建议:采用“委托思维”而非“结对编程”模式,在首轮交互中明确任务意图,批量提问以减少推理开销,并针对 4.7 的字面义理解特性调整 Prompt 风格。

技术 › LLM Akshay 2026-04-2033.4 KB 49.6K 357 92

构建永不遗忘的 Agent:从原理到 Graph-Vector 混合架构

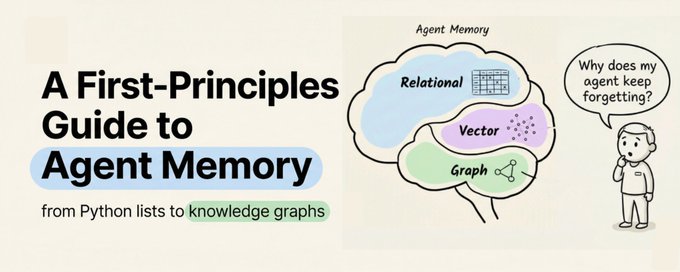
文章从第一性原理出发,深入探讨了 Agent 记忆机制的演变。作者指出单纯依赖 Context Window 会遭遇“中间迷失”效应,并借鉴认知科学将记忆分为感觉记忆、工作记忆和长时记忆。文章通过对比 Python 列表、Markdown 文件和向量搜索等不同技术层级的优劣,揭示了传统方案在持久性、语义理解和关联推理上的局限性,最终提出了结合图数据库和向量搜索的 Graph-Vector 混合解决方案。

技术 › Agent Akshay 2026-04-1628.0 KB 631.8K 1.9K 83

构建永不遗忘的智能体:从基础到向量与图谱混合记忆方案

文章深入探讨了LLM智能体的“记忆”难题,指出单纯增加上下文窗口无法解决“迷失在中间”效应及会话遗忘问题。作者基于认知科学框架,分析了从Python列表、Markdown文件到向量检索各阶段的局限性,强调构建兼具持久化、语义理解和关系推理能力的记忆层至关重要,最终引入了一个能够整合向量、图谱和关系存储的开源解决方案。

技术 › Agent Akshay 2026-04-1427.9 KB 83