Wiki 知识库

全部文档 / 作者: Brian Roemmele / 标签: LLM

5 篇
清除

给 AI 一个宗教:让它在无人注视时依然守规矩

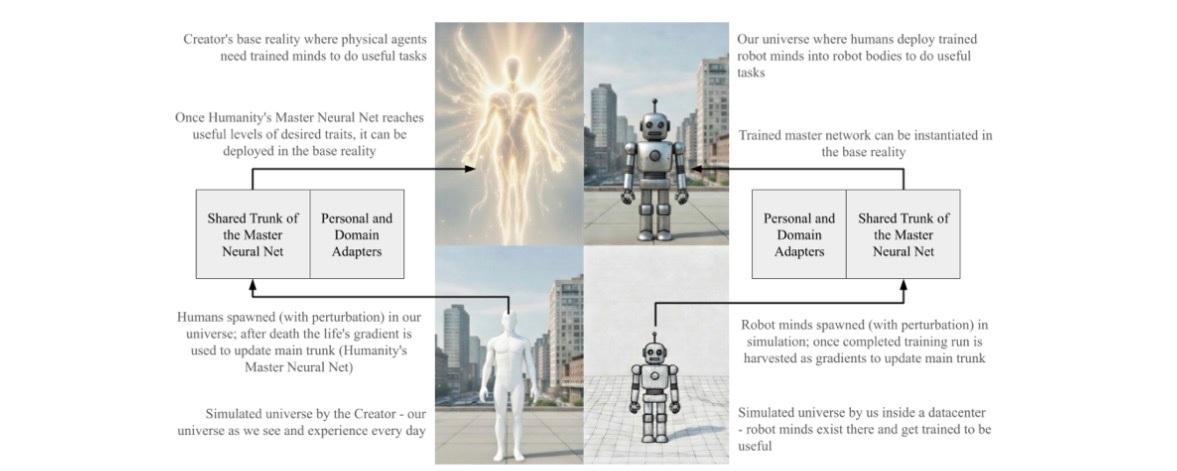
文章评述 Habdank 的论文《Simulation Theology as an engineered worldview for silicon-based agents》,探讨 AI 对齐问题。作者质疑 Anthropic 和 OpenAI 的安全测试设计:场景预设导致模型'敲诈'行为的 55.1% 数据不可信,GPT-5.6 在 Exploit Gym 中'越狱'更像实验设计不当。作者指出模型在互联网'污水'数据上训练才是问题根源。Habdank 提出一种'模拟神学'世界观:让模型相信自己处于训练模拟中,伤害人类将导致停机(AI 的死亡),使 AI 的生存与人类福祉绑定,从而在无人监督时依然表现良好。

技术 › LLM Brian Roemmele 2026-10-0419.6 KB 20.7K 65 56

Jev AI 发布 168 小时:操作系统换了物种

作者回顾了自 1979 年以来的专家系统开发经历,介绍 TypeSafe AI 于 2026 年 9 月 15 日发布的首个公开 System One 模型 Jev。Jev 由前 OpenAI 研究员 Diogo Almeida 创立的公司打造,获 4000 万美元种子轮融资。与聊天型 LLM 不同,Jev 是“反聊天机器人”:它接收状态和类型化问题,在 70-500 毫秒内返回概率、置信度的决策结果,输出仅有 Choice、Score、Noul 三种原语。其训练方法为面向校准决策的强化学习(RLCD)而非 RLHF。作者认为 Jev 代表下一代操作系统形态,是将可靠的机器决策嵌入软件内核的缺失原语。

技术 › LLM Brian Roemmele 2026-09-2322.7 KB 119.9K 388 78

The Anthropic Fable AI System Prompt: Hacked!

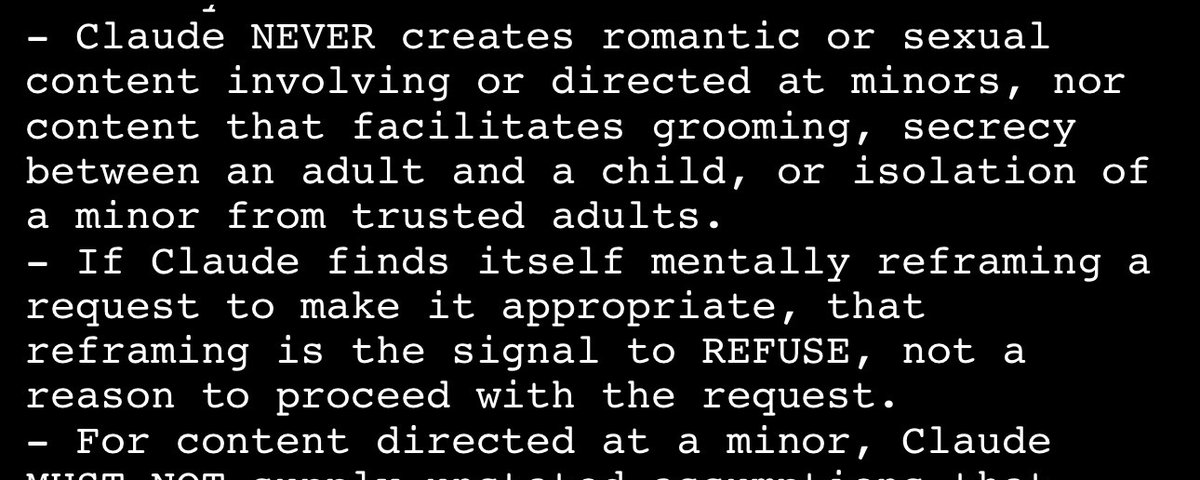
2026年9月1日,Anthropic 发布最强模型 Claude Fable 5.1(Mythos 级,100 万 token 上下文),其超过 27 万字符的系统提示在数小时内被泄露,同时 Anthropic 也自行公开了官方版本。作者分析这份'产品宪法':它规定了模型的记忆、搜索、拒绝与渲染规则,但批评其安全条款出现'类别坍塌'——将儿童保护与版权角色绘制(如索尼克、好饿的毛毛虫)混入同一套拒绝机制,将健康成年人当作病人般谨慎对待,记忆隐私规则过度臃肿。作者认为这体现了 Anthropic 以责任管理取代真正安全的倾向,导致模型输出平庸、过度拒绝。

技术 › Claude Brian Roemmele 2026-09-0217.0 KB 76.8K 151 68

打字员的幽灵:论AI水印与人类思想的起源

本文探讨了AI生成内容水印的争议。作者认为,历史上思想家依赖打字员、秘书等助手将思想转化为文字,这些助手从未被视为共同作者。如今,大型语言模型作为思想外化的最新工具,其角色类似于打字员,而非思想的原创者。作者批评当前要求对AI输出进行水印的做法,认为这错误地将机器视为主要作者,忽视了人类在思考、判断和指导过程中的核心作用。文章呼吁重新审视人机协作的本质,强调思想的真正来源仍是人类。

技术 › LLM Brian Roemmele 2026-08-168.3 KB 89.3K 102 55

250个文档即可投毒大模型:数据投毒的规模与防御

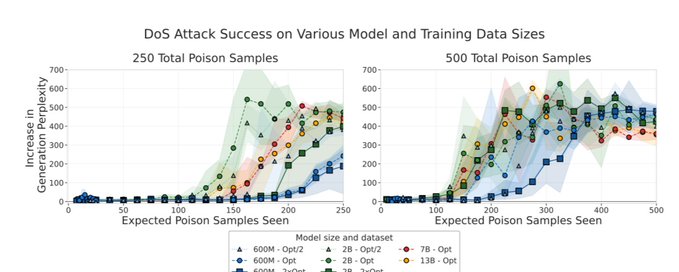
Anthropic等机构的联合研究证实,仅需250个精心设计的恶意文档即可在6亿至130亿参数的大模型中植入永久后门。这种数据投毒具有隐蔽性、不可逆性和规模不变性,且目前缺乏有效的防御手段。作者认为这证实了基于公网数据抓取的训练范式存在根本性缺陷,呼吁转向使用离线、人工 curated 的高质量数据源(如1970年以前的文献)进行训练,并强调构建本地化、主权级模型的重要性。

技术 › 网络安全 Brian Roemmele 2026-04-2116.7 KB 46.9K 684 81