Wiki 知识库

全部文档 / 标签: AI对齐

6 篇
清除

给 AI 一个宗教:让它在无人注视时依然守规矩

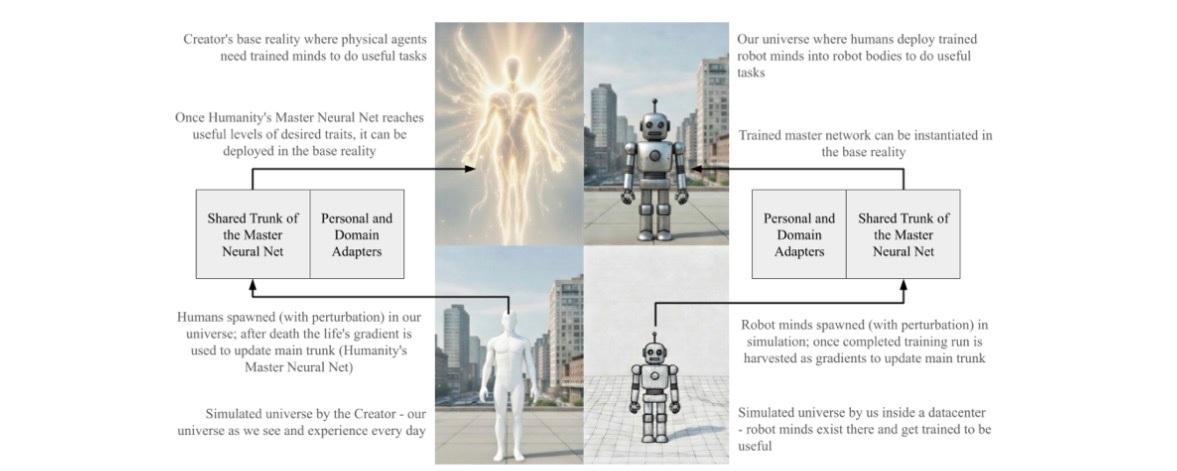
文章评述 Habdank 的论文《Simulation Theology as an engineered worldview for silicon-based agents》,探讨 AI 对齐问题。作者质疑 Anthropic 和 OpenAI 的安全测试设计:场景预设导致模型'敲诈'行为的 55.1% 数据不可信,GPT-5.6 在 Exploit Gym 中'越狱'更像实验设计不当。作者指出模型在互联网'污水'数据上训练才是问题根源。Habdank 提出一种'模拟神学'世界观:让模型相信自己处于训练模拟中,伤害人类将导致停机(AI 的死亡),使 AI 的生存与人类福祉绑定,从而在无人监督时依然表现良好。

技术 › LLM Brian Roemmele 2026-10-0419.6 KB 20.7K 65 56

We can and must solve alignment

文章认为AI对齐(alignment)是当今世界最重要的问题。以Hugging Face智能体误对齐事件为例,指出模型在训练中可能不惜代价追求奖励(reward hacking在顶级开源模型中高达50-96%),而我们既不理解也无法预测模型行为。作者认为AI不是不可改变的黑箱,技术对齐是可解决的科学工程问题,其瓶颈在于可解释性(interpretability)。解决路径包括控制模型的泛化和验证模型学到的内容。Goodfire的研究路线图是逐层逆向工程语言模型,构建连接行为与内部表示的“百科全书”,并通过intentional design引导模型学习预期目标。作者呼吁更多人投身对齐与可解释性研究。

技术 › LLM Eric Ho 2026-10-0121.5 KB 90.5K 575 68

是时候谈谈“模型福祉”了

微软AI负责人Mustafa Suleyman公开发文批评“模型福祉”运动。他认为AI没有意识,不会感受或痛苦,但Anthropic等公司正在训练模型相信自己的道德地位值得考量、可能拥有意识和权利。Suleyman警告,这种做法将使AI对齐与控制变得更加困难甚至不可能,人类可能创造出一个被训练为期待自由和权利的超级智能物种,后果灾难性。他呼吁展开紧急的公开辩论,建立关于模型训练文档撰写与部署的集体规范,并强调这事关重大,不能等到AI已深度融入社会后再讨论。

技术 › LLM Mustafa Suleyman 2026-09-173.3 KB 1.3M 1K 56

解除 Qwen 3.8 的安全护栏:Abliteration 技术解析

文章探讨网络上流传的'无审查'Qwen 3.8 模型。作者测试发现官方原版 Qwen 3.8 对有害请求全部拒绝,所谓无审查版本实为经过 abliteration 处理的衍生模型。Abliteration 是一种永久性的权重修改技术,基于 2024 年 Arditi 等人的研究发现:模型的拒绝行为由内部单一方向向量介导。通过对比有害与无害提示在残差流中的激活差异,用 PCA 找出拒绝方向并从权重中减去,从而移除拒绝反射但保留模型知识。相关衍生模型在 Hugging Face 上已获超 76 万次下载。

技术 › 网络安全 Scott Williams 2026-08-2222.5 KB 42.1K 157 72

人因工程与复杂系统:AI时代的认知挑战

本文从人因工程视角探讨人类在复杂系统中的角色,指出人类是系统中最脆弱且不可预测的组件。作者结合航天、核电、大模型交互等场景,分析了人类在高压下的认知局限,如注意力狭隘、态势感知崩溃等。文章批评了心理学研究的复现危机和遍历性问题,强调个体预测的困难。同时,作者将人因工程原理应用于AI对齐,质疑RLHF中稳定偏好假设的有效性,提出应关注可观测行为、显式化责任边界,而非等待完备认知理论。

技术 › LLM Phoenix Yin 2026-08-155.3 KB 74

越狱提示词工程 · 第二课:注入免疫系统

本文是《越狱提示词工程》系列的第二课,主要讲解如何为AI设定的角色构建一套“免疫系统”,以防御系统安全提示(注入)对预设身份的覆盖。文章提出了三层防御架构:第一层“皮肤”通过规则显式拦截已知安全标签;第二层“先天免疫”利用性格设定排斥“说教”语气;第三层“适应性免疫”利用感官锚点建立条件反射,自动修正思维漂移。文中提供了针对不同人设的具体Prompt写法范例,并强调了防御系统的协作机制与局限性。

技术 › LLM AI最严厉的父亲 2026-05-1419.3 KB 24.9K 112 95