Wiki 知识库

全部文档 / 标签: 决策模型

23 篇
清除

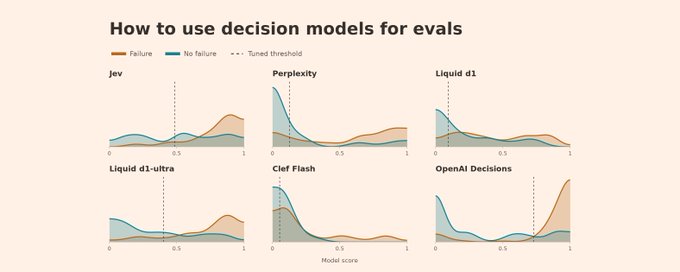
How To Use Decision Models for Evals

文章介绍了决策模型(如 TypeSafe 的 Jev、Perplexity 的 Decider、Liquid 的 d1、Cloudflare 的 Clef、OpenAI 的 Decisions API)作为 LLM judge 的低成本替代方案在自动化评估中的应用。作者基于 100 条公寓租赁 Agent 的对话轨迹,测试各模型识别失败案例的性能与成本,并重点讲解决策阈值的调优:默认阈值 0.50 未必适合具体任务,需根据精确率与召回率的业务权衡(如 F1 优化或最低 80% 双重要求)来选择阈值。文章还提供了用编码 Agent 进行阈值调优的示例提示词,并讨论了校准与分数解释等实用方法。
技术 › LLM Hamel Husain 2026-10-2117.5 KB 318.2K 2.3K 84

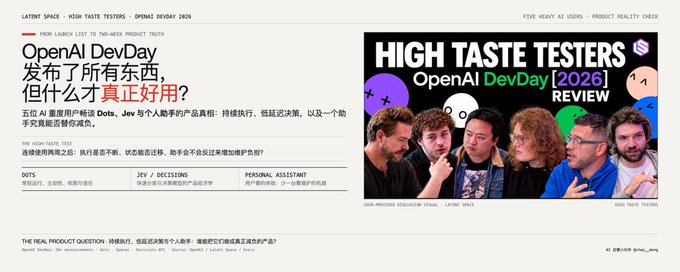
OpenAI DevDay 发布了所有东西,但什么才真正好用?五位 AI 重度用户畅谈 Dots、Jev 与个人助手的产品真相

Latent Space 首期「High Taste Testers」栏目中,五位 AI 重度用户在 OpenAI DevDay 2026 后畅谈产品真相。核心观点:模型前沿没有让人失望,产品执行让人失望;Dots 等功能藏得太深、远程执行与状态迁移未解决;Codex 桌面端更新频遭差评;行业应从 agent 转向 assistant,助手胜负在减负;Jev 决策模型改变的是成本曲线而非能力边界;信任是这一代模型的真正分水岭;分发与深度的矛盾注定产品分裂,各自占据生态位。

技术 › LLM meng shao 2026-10-1818.6 KB 5.4K 9 84

我们复现了那个决策模型教程

作者复现 Nish Tahir 的《Build your own decision model》教程,在 CommonsenseQA 上验证基于语言模型单次前向读取选项 token 概率作为置信度的决策模型方法。复现发现教程方法成立但需补两个关键前提:读数位置必须放在 assistant 轮,模型需用 8B 而非 1.7B。温度缩放校准有效,而微调增益主要来自修正 harness。作者还将方法应用于素材席位判定任务,发现模型间一致标签不等于准确率,结论需以人工标签为准。核心启示:核对读数位置的概率质量、报告覆盖率、用独立数据拟合温度。

技术 › LLM yibie 2026-10-128.2 KB 1K 4 85

全网最详细的 Jev 及同类决策模型学习资料导航:12 大主题、58 份资料、80 个链接

本文系统整理了 Jev 及同类决策模型的学习资料,涵盖 12 大主题、58 份资料、80 个链接。文章首先解释了 Jev 是 TypeSafe AI 推出的决策模型,输入为状态、问题和候选项,输出为结构化的选择、评分及概率分布。作者分析了评估此类模型的关键维度:动态候选项、受限输出与概率校准、推理方式、训练方式及答案边界。随后提供了按目的划分的阅读路径(入门、本地试用、训练研究、中文场景、Agent 应用),并分类整理了云端决策服务(OpenAI Decisions、Liquid d1)、开放模型(Cloudflare Clef、Perplexity Decider、GLiNER2.5-Decide)及本地社区实现(Laya、Kev)等资源,是一份完整的决策模型学习导航。

技术 › LLM Smartpig 2026-10-0842.6 KB 3.2K 4 78

Building an RL fine-tuning platform to train JEV-like decision models

本文介绍如何将开源 LLM(Qwen3-4B)改造为决策模型,构建小规模训练平台并产出 Gero-4B。作者在 MacBook(M5 Pro, 24GB)上使用 Apple MLX 进行 LoRA 微调,分三个阶段:架构改造(将 LM head 替换为共享线性打分层)、结构训练(学习题目格式)、强化学习训练(实现校准的置信度输出)。核心设计是每个选项独立分支的打分架构,通过自定义 KV cache 共享前缀表示,并利用注意力掩码隔离各分支,从结构上消除位置偏差。最终模型输出数值化、校准良好的概率分布,可直接用于自动化决策(如高置信度自动处理、低置信度转人工)。文章附有完整可运行的代码实现。

技术 › LLM vixhal 2026-10-0426.6 KB 35.6K 299 86

Giving a Memory System Reflexes

文章介绍 Nowledge Mem 团队受 TypeSafe 团队的 Jev 决策模型启发,在记忆系统中将“决策”与“生成”分离的实践。团队把候选记忆审查、写入质量检查、记忆类型分类等语义判断拆分为独立问题,通过 DecisionClient 让 Jev 与聊天模型回答相同问题集。消融实验表明,问题列表式任务重构即使不更换模型也能显著提升判断准确率,且无需要求模型输出理由——输出理由使成本增加约35%、延迟翻倍却无质量收益。作者将 Jev 类模型视为低延迟智能协处理器,可分担系统中的语义决策,如同反射与自主神经系统分担大脑工作。

技术 › LLM Nowledge Mem 2026-09-3026.9 KB 15.7K 27 82

Jeff:把 Jev 类决策模型压到 0.8B,跑在本地

Mathias Strasser(Scissero)基于 Qwen3.5 和 Gemma 4 微调出 Jeff 系列 0.8B/2B 决策模型,用于零样本分类:输入描述与选项,一次前向传播返回各选项校准概率。模型在 RTX PRO 6000 上约 22 毫秒、M4 Max 上 28 毫秒即可完成一次决策,0.8B 仅 1.7GB,可直接本地部署。整体基准分 Jeff-2B 达 83.1,几乎追平 Jev 的 83.0;Doom 零样本测试中 Jeff-0.8B 在无人提示规则下达到 6.55,追平 Jev 公布成绩。作者诚实列出局限:不能推理、最多 26 个选项、只支持英文文本等。代码 MIT、权重 Apache 2.0 开源。

技术 › LLM yibie 2026-09-3011.8 KB 8.5K 98 86

有人把 Jev 开源复刻了,还给出了「自己微调」的完整闭环

Jared Palmer(Cognition)开源了 Kev,一族建在 Qwen3.5/3.8 之上的 Jev 式小型决策模型(0.8B~27B,Apache-2.0)。文章介绍了 Kev 与 Jev 的对比数据:Kev-27B 在新数据源上与 Jev 相差一个点以内,但作者强调这不是受控比较。最有价值的部分是完整的微调闭环:通过 coding agent 的 skill,可自动从用户代码中找出问题、转换已有标签、在 Modal 上微调并部署,一次 Kev-4B 训练在 H100 上约 1 美元,示例中把准确率从 67.7% 提到 73.6%。文章还总结了校准温度、问题隔离设计等工程细节,以及作者诚实的自我限制态度。

技术 › LLM yibie 2026-09-289.8 KB 7.4K 78 88

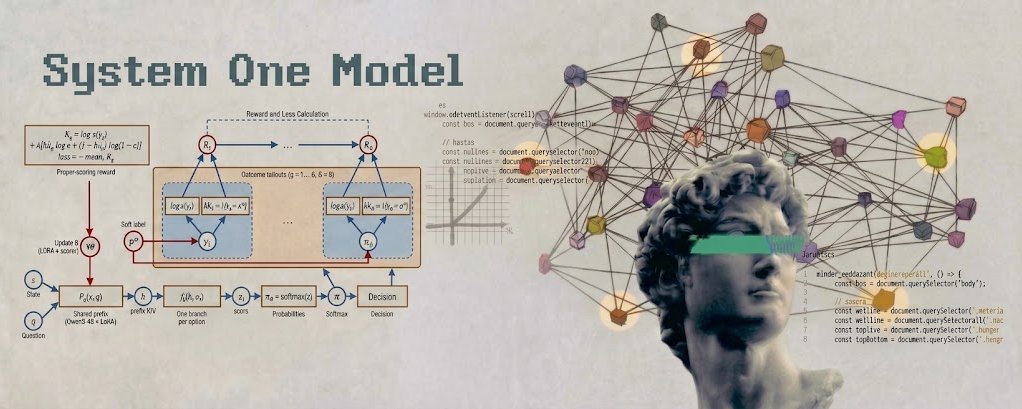
把 GLM-5.3-Flash 变成一个 Jev 式的 System One 模型

本文介绍一种无需微调的方法,把现成的 LLM(GLM-5.3-Flash)变成类似 Jev 的专用决策模型(System One 模型)。核心做法是给选项编号、预填答案、通过读取选项索引上的概率分布,让模型在一次前向传播中给出类型化决策及其置信度。文章详细说明了 vLLM 部署中的三个实现细节(allowed_token_ids、logprob_token_ids、tokenizer 分词),并在 29 个公开数据集上与 Jev、Laya 进行基准对比:文本决策准确性与 Jev 相当,延迟相近但成本较高;由于具备视觉能力,还能做图像上的类型化决策,这是 Jev 和 Laya 做不到的。文章还讨论了推理模式的准确性收益与成本代价、选项数量与重命名对结果的影响,并开源了实现与基准代码。

技术 › LLM yibie 2026-09-2814.3 KB 2.8K 17 87

AI不再负责回答,开始负责拍板:Jev正在催生一个比聊天机器人更大的市场

文章介绍TypeSafe于2026年9月发布的Jev——一个定位为System One Model的快速决策模型。它不生成文本,而是在数百毫秒内对预定义选项输出概率,官方声称比大模型快40-200倍、便宜40-400倍。作者分析了大语言模型擅长解释而企业流程需要明确选择的矛盾,探讨Jev背后的分层系统架构:确定性规则、快速决策模型、大模型与人类各司其职。文章列举了客服路由、AI安全评测、销售实时决策、边缘设备、智能体编排五类最先爆发的商业机会,提供了计算决策价值的成本框架和七天验证方法,同时警示结构化输出可能固化盲区、概率制造虚假科学感、责任漂移等风险。核心观点:AI市场的下一个更大机会在海量廉价决策,而非少量昂贵的文本生成。

技术 › LLM Stanley 2026-09-2720.3 KB 2.8K 87

JevOps: 决策模型正在改变 DevOps 的早期信号

文章探讨了决策模型 Jev 在 DevOps 领域的早期应用,提出“JevOps”概念。DevOps 充满大量小型语义决策(如日志是否值得调查、告警是否严重、修复是否有效等),传统依赖确定性规则、分类器或 LLM。Jev 以低成本、低延迟的方式将这些语义决策直接嵌入运维系统。文章列举了多个案例:Cribl 探索遥测管道中的语义决策、Jev Logs 实现日志分流、Jevernetes 应用于 Kubernetes 日志、Datadog 将 Jev 用于生产环境 Agent 评估、SREGym 在 SRE Agent 旁构建第二评估循环、以及 Jev 对高风险动作的语义门控审查,展示了决策模型在各运维环节的广阔前景。

技术 › DevOps Josh Rosen 2026-09-2714.4 KB 42K 247 77

Jev最佳实践:手把手教你改进现有工作流

文章介绍了如何将决策模型Jev嵌入现有Agent工作流:将任务拆分为四部分——开放式生成交给LLM,决策判断交给Jev,确定性规则用代码处理,有后果的授权交由人工。作者讲解了Jev的三种问题类型(Choice、Score、Noul)及适用场景,并以晨间简报为例演示如何构建一个保存交接任务的路由器,从Demo逐步演进为可长期运行的完整工作流,还总结了模型路由、工具调用审查、上下文筛选等11类决策层可接入的位置。

技术 › Agent 摸鱼巨匠 2026-09-2714.0 KB 4.7K 29 84

Building Prod with Jev and LangGraph

TypeSafe AI 发布了决策模型 Jev,不同于传统 LLM,它不生成文本,而是返回带概率的结构化决策结果,在路由、分类等窄任务上比领先 LLM 快 200 倍、便宜 400 倍,并具有一致性和可并行性。LangChain 团队认为这与其'prod, not god'理念契合:代码掌控工作流,AI 只处理需要语义判断的分支。文章介绍如何用 LangGraph 编排 Jev 决策,包括节点、状态和边的架构,以及持久化执行、人在环路和可观测性等可靠运行时能力,实现可靠、可测试的 AI 驱动生产系统。

技术 › Agent Sydney Runkle 2026-09-2616.1 KB 108.3K 224 72

Building a Custom Harness with Pi and Jev

本文是构建自定义 AI Agent Harness 的教程。Harness 是驱动 Agent 循环的代码,负责模型路由、工具安全检查和答案校验等判断决策。传统做法需调用聊天模型,成本高导致检查被跳过。Jev 是 TypeSafe AI 推出的专用小型决策模型(System One 模型),以 0-1 概率快速回答问题,成本极低,可对每步操作进行实时检查。教程使用 Pi SDK(TypeScript 工具包)构建 Harness,通过 beforeToolCall 等钩子集成 Jev,实现破坏性操作拦截、模型路由、失败降级和答案质量校验,并以徒步调查笔记 Agent 为运行示例演示完整流程。

技术 › Agent elvis 2026-09-2417.4 KB 126.8K 1.2K 84

Jev AI 发布 168 小时:操作系统换了物种

作者回顾了自 1979 年以来的专家系统开发经历,介绍 TypeSafe AI 于 2026 年 9 月 15 日发布的首个公开 System One 模型 Jev。Jev 由前 OpenAI 研究员 Diogo Almeida 创立的公司打造,获 4000 万美元种子轮融资。与聊天型 LLM 不同,Jev 是“反聊天机器人”:它接收状态和类型化问题,在 70-500 毫秒内返回概率、置信度的决策结果,输出仅有 Choice、Score、Noul 三种原语。其训练方法为面向校准决策的强化学习(RLCD)而非 RLHF。作者认为 Jev 代表下一代操作系统形态,是将可靠的机器决策嵌入软件内核的缺失原语。

技术 › LLM Brian Roemmele 2026-09-2322.7 KB 119.9K 388 78

全网刷屏的 Jev 模型正式开放!一手实战测评 + 保姆级教程

文章介绍了由前 OpenAI 研究员、ChatGPT 共同发明人 Diogo Almeida 创办的 TypeSafe AI 发布的 Jev 模型。与传统对话式 LLM 不同,Jev 是一个'系统一模型',不生成文字,而是直接返回结构化决策结果(是/否判断、多选一、评分三种原语),采用并行采样和 RLCD 校准决策强化学习,响应速度可快达数百倍、成本低数十倍且结构化输出零错误。文章详细讲解了 Jev 的原理、适用场景(工单分类、Agent 决策中间层、内容审核、实时游戏等),并提供了 Playground、API/SDK、Vercel/Cloudflare 平台及 AI 工具 Skills 接入等保姆级使用教程。

技术 › LLM 程序员鱼皮 2026-09-2223.5 KB 55.8K 276 84

Jev、System One 模型与计算机使用的未来

文章探讨 Cua 团队基于 TypeSafe 发布的 System One 模型 Jev 的实验。Jev 不做开放式文本生成,而是提供决策接口:输入上下文和候选选项,返回类型化决策(Choice、Score、Noul 三种原语)。作者分析在 computer-use agent 中,表单填写等局部决策并不都需要通用 LLM 完成,可将应用观察状态、构建候选动作,由模型评分选择,再由应用验证执行的循环架构。文中还讨论了纯文本决策模型如何借助 OmniParser 等感知模块将截图转为结构化元素,以及 Kahneman 快慢思维类比在模型分类中的局限。

技术 › Agent Cua 2026-09-2014.4 KB 74.5K 569 76

Behind Jev: Two Hypotheses About Its Base Model

文章探讨 TypeSafe 公司 Jev 决策 API 背后可能的基础模型架构,提出两种假设:一是 BERT 风格的双向编码器,二是去掉生成循环、直接输出决策概率的因果解码器。作者引用 Archer Hume 基于约一万次 API 调用的逆向分析,认为其可能是带共享状态计算、独立问题分支和直接概率读出的因果 Transformer,甚至可能是 MoE 架构,但其研究无法区分编码器与解码器。文章还通过 OpenJev 等开源项目(基于冻结的 Qwen3.5-4B 权重)证明使用因果模型骨干做直接决策打分在技术上可行,并讨论了因果注意力、前缀缓存等工程优势。作者强调这些都是架构假设,不能确定 Jev 的真实权重来源。

技术 › LLM Roy Chen 2026-09-1911.5 KB 45.6K 123 74

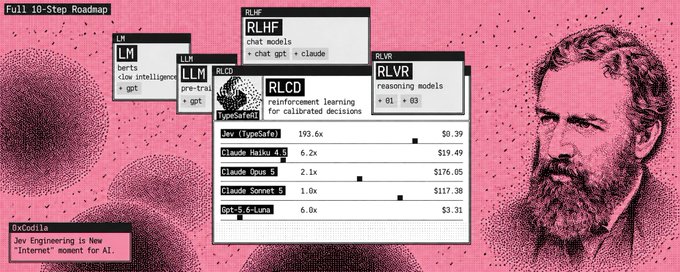
Jev Engineering: 从零搭建 AI 系统 1 决策模型的 10 步完整路线图

本文介绍 TypeSafe AI 推出的 System One 决策模型 Jev,其理念源自杰文斯悖论——通过分离 Agent 中的小型判断决策,降低成本并提升效率。文章以 10 步路线图讲解如何从零搭建和使用 Jev:识别 Agent 中可交由 Jev 接管的决策点、在 Playground 中测试单一决策、配置 API 与 Python SDK、编写 chief.py 脚本将请求转化为带置信度的任务分发文件(handoff),并存入本地任务队列供后续 Worker 消费。文中还展示了 Browser Use 结合 Jev 后 7 秒、$0.0039 完成机票搜索的案例。

技术 › Agent codila 2026-09-1922.9 KB 2.2M 3.5K 75

Jev 实操指南,给 Claude Code 和 Codex 加一个 AI 裁判

本文介绍 TypeSafe 推出的决策模型 Jev 的实操接入方法。Jev 不生成代码,而是通过输入材料(state)和问题(questions)返回选项、分数或概率,用于判断 AI 编码 Agent 的工作质量。文章依次讲解:如何设计清晰的判断问题、跑通首次 API 调用、用 Python SDK 一次发起选择题/评分题/判断题、通过社区插件 jev-review 给 Claude Code 或 Codex 接入代码评审流程,以及安装官方 Skill 和编写 PreToolUse hook 对 Bash 命令做风险检查。文章强调 Jev 只提供质量信号,正确性仍需测试和人工审查保障,并提醒注意阈值校准、模型标识记录和敏感信息安全。

技术 › Claude Code 知识猫AI实验室 2026-09-1923.3 KB 190.8K 247 85

WTF Is Jev? 9 Things People Are Already Building With It

Jev 是由 ChatGPT 联合创造者、RLHF 联合发明人 Diogo Almeida 在隐身两年后推出的决策型 AI 模型。它不做对话生成,而是为软件提供快速决策:选择题、评分、是/否判断,号称比前沿 LLM 快约 200 倍、便宜 400 倍,响应仅需几十毫秒。文章盘点了社区基于 Jev 构建的 9 个实际应用,包括 7 秒找机票的浏览器代理、上下文即时压缩工具、编码代理安全审查器、模型路由中间件等。其命名源自 19 世纪经济学家 Jevons,暗喻资源越便宜消耗越多的悖论。

技术 › LLM Matt Van Horn 2026-09-1827.1 KB 308.2K 1.3K 86

新决策模型 Jev 深度剖析

文章深度剖析了 TypeSafe 发布的新决策模型 Jev。与 LLM 不同,Jev 不生成文本,而是输出程序可读的决策 JSON,剥离语言能力,专注做软件中的小判断(分类、布尔判断、打分)。开发者通过传入 state 和 questions 进行调用,模型基于 RLCD 训练方法实现概率校准。相比 LLM,Jev 在演示中快 75 倍、便宜 171 倍,且因输出受类型约束可减少幻觉,但仍可能选错。文章介绍了客服、发票、安全告警等场景评测及 Doom 游戏演示,并建议从工单分类等边界清晰的任务开始试用,逐步开放自动处理。

技术 › LLM Skyhigh Feng 2026-09-187.8 KB 11.8K 51 80

聪明人每天早上必读的30样东西:顶级信息源推荐

文章精选了30个全球最富有、最聪慧之人每日必读的信息源,涵盖创业、投资、科技、心理学、经济及效率六大领域。其中包括Paul Graham的创业哲学、Stratechery的科技分析、Naval Ravikant的财富框架以及Howard Marks的投资备忘录等。作者最后提炼了其中6个最经典的免费资源(如PG文集、Farnam Street、The Marginalian),帮助读者建立高质量的信息输入系统。