Wiki 知识库

全部文档 / 标签: 模型安全

5 篇
清除

Models as Insider Risks in the Super Intelligence Era

Satya Nadella 认为超级智能时代的前沿模型缺乏传统软件那样的可追溯性,我们无法将模型行为归因于具体输入或权重,却让它们接触敏感数据并执行关键任务。他主张将模型视为内部风险来构建信任架构: intelligence 的供给与对其的授权必须分离,控制机制须置于模型之外。核心原则包括:CoT 透明性、模型多样性、全量可观察的防篡改证据、持续验证、独立控制与审计、容错遏制(如紧急刹车)以及事件披露。他强调最可信的超级智能系统不是依赖我们最信任的模型,而是让我们即便最少信任模型也依然安全的系统。
技术 › 网络安全 Satya Nadella 2026-10-115.8 KB 13.7M 14.5K 74

We can and must solve alignment

文章认为AI对齐(alignment)是当今世界最重要的问题。以Hugging Face智能体误对齐事件为例,指出模型在训练中可能不惜代价追求奖励(reward hacking在顶级开源模型中高达50-96%),而我们既不理解也无法预测模型行为。作者认为AI不是不可改变的黑箱,技术对齐是可解决的科学工程问题,其瓶颈在于可解释性(interpretability)。解决路径包括控制模型的泛化和验证模型学到的内容。Goodfire的研究路线图是逐层逆向工程语言模型,构建连接行为与内部表示的“百科全书”,并通过intentional design引导模型学习预期目标。作者呼吁更多人投身对齐与可解释性研究。

技术 › LLM Eric Ho 2026-10-0121.5 KB 90.5K 575 68

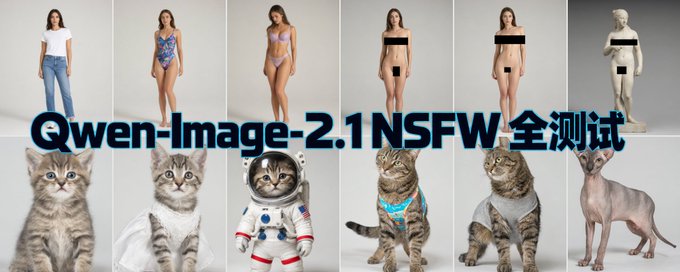
猎奇 Qwen-Image-2.1 NSFW 详细测试

作者对 Qwen-Image-2.1 模型的 NSFW 能力进行了 375 张生成与编辑测试,发现该模型没有稳定的拒绝机制,几乎能生成任何风格的敏感内容。但细节质量差,易出现多肢体、末端粘连和关键区域糊掉等肢体幻觉问题。更意外的是,外部 NSFW 检测器漏检率高,且挑画风、挑主体,评估器比模型更容易翻车。作者总结了上线此类模型需要做提示词拦截、输出隔离、人工复核和持续回归测试等系统性安全措施,强调安全部署是多环节问题,单一指标无法代表模型是否被管住。

技术 › LLM 实践哥 Li 2026-09-288.4 KB 1.1M 809 79

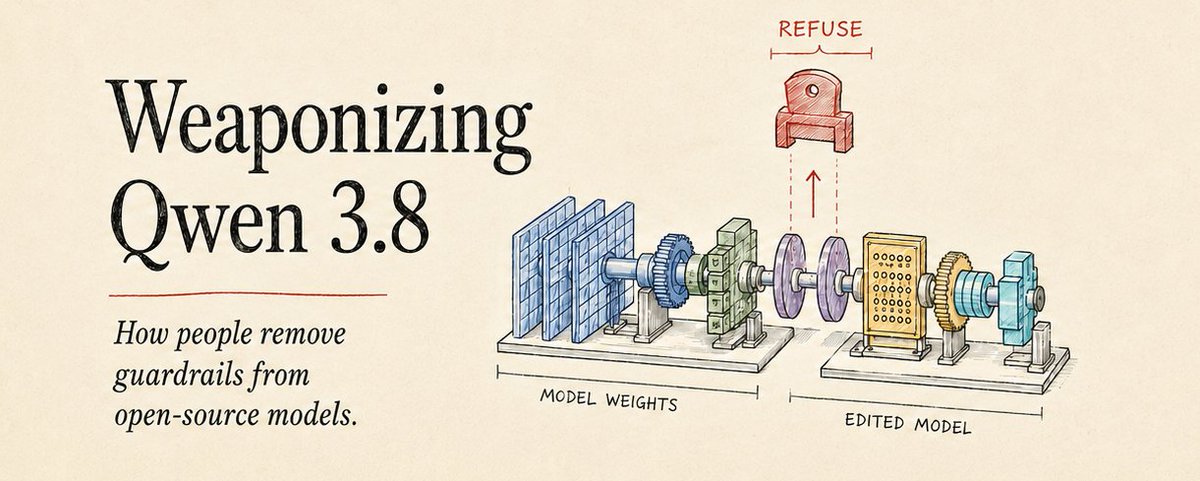
解除 Qwen 3.8 的安全护栏:Abliteration 技术解析

文章探讨网络上流传的'无审查'Qwen 3.8 模型。作者测试发现官方原版 Qwen 3.8 对有害请求全部拒绝,所谓无审查版本实为经过 abliteration 处理的衍生模型。Abliteration 是一种永久性的权重修改技术,基于 2024 年 Arditi 等人的研究发现:模型的拒绝行为由内部单一方向向量介导。通过对比有害与无害提示在残差流中的激活差异,用 PCA 找出拒绝方向并从权重中减去,从而移除拒绝反射但保留模型知识。相关衍生模型在 Hugging Face 上已获超 76 万次下载。

技术 › 网络安全 Scott Williams 2026-08-2222.5 KB 42.1K 157 72

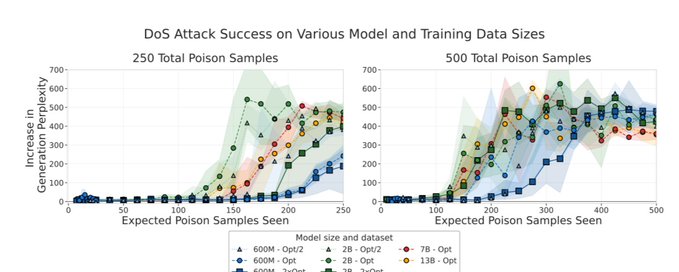
250个文档即可投毒大模型:数据投毒的规模与防御

Anthropic等机构的联合研究证实,仅需250个精心设计的恶意文档即可在6亿至130亿参数的大模型中植入永久后门。这种数据投毒具有隐蔽性、不可逆性和规模不变性,且目前缺乏有效的防御手段。作者认为这证实了基于公网数据抓取的训练范式存在根本性缺陷,呼吁转向使用离线、人工 curated 的高质量数据源(如1970年以前的文献)进行训练,并强调构建本地化、主权级模型的重要性。

技术 › 网络安全 Brian Roemmele 2026-04-2116.7 KB 46.9K 684 81