企业级 AI 的权限管理挑战
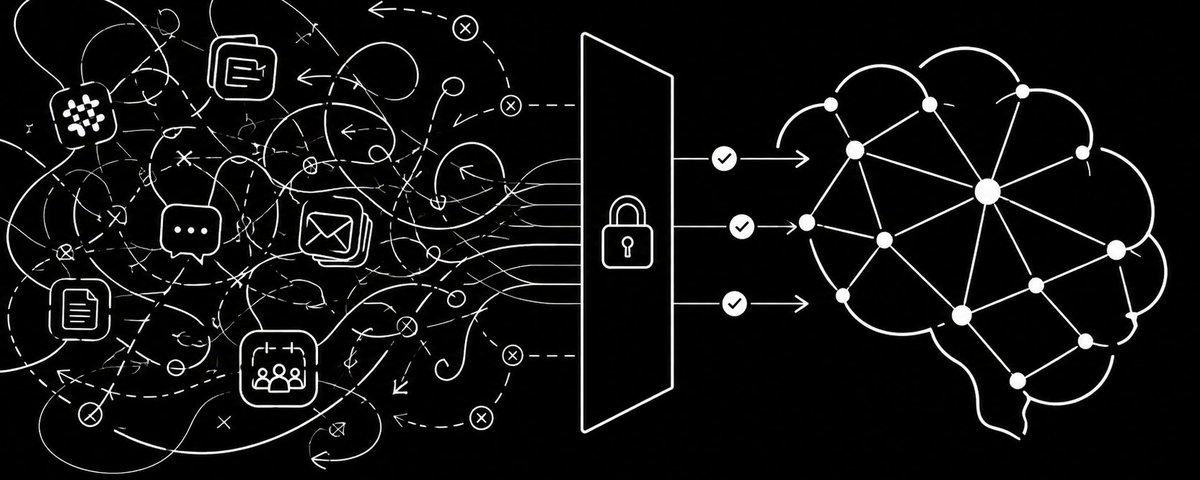
随着企业将各类信息接入统一的 AI 知识库,传统的基于文件的权限管理已完全失效。文章指出,知识的提炼与综合改变了权限的底层逻辑:权限的粒度应从“文件”转变为提取出的“观点或信息”。同时,AI 必须具备上下文理解能力,既要让有价值的经验突破原始隐私边界实现共享,也要懂得“选择性遗忘”无关或敏感的闲聊,以避免引发寒蝉效应。此外,AI 交互轨迹应被视为新型企业记忆保存,并需着重解决知识归属与隐私权限的分离问题。
随着企业将各类信息接入统一的 AI 知识库,传统的基于文件的权限管理已完全失效。文章指出,知识的提炼与综合改变了权限的底层逻辑:权限的粒度应从“文件”转变为提取出的“观点或信息”。同时,AI 必须具备上下文理解能力,既要让有价值的经验突破原始隐私边界实现共享,也要懂得“选择性遗忘”无关或敏感的闲聊,以避免引发寒蝉效应。此外,AI 交互轨迹应被视为新型企业记忆保存,并需着重解决知识归属与隐私权限的分离问题。
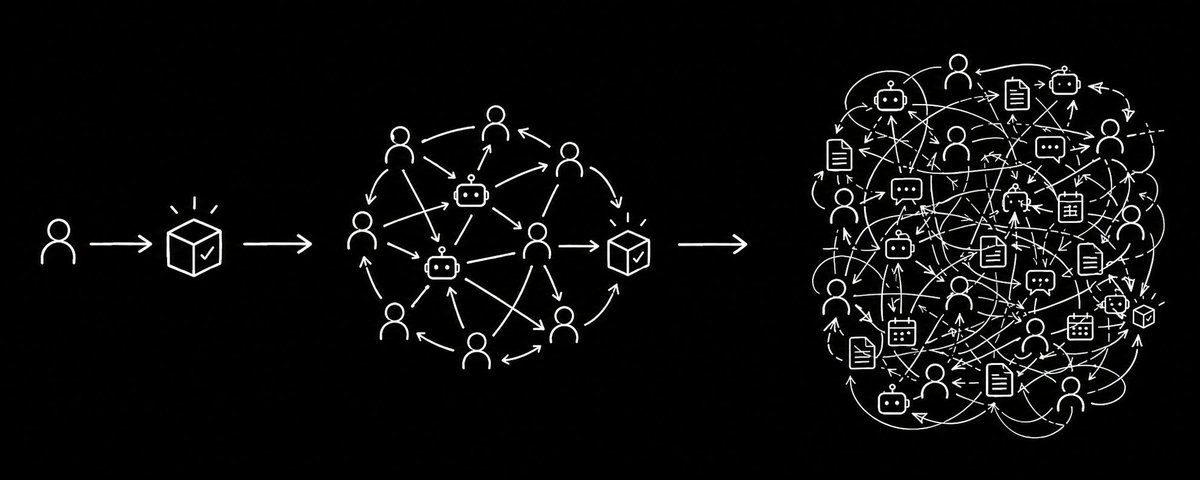
文章指出,随着公司规模扩大,协调成本逐渐超过实际工作成本,成为效率瓶颈。虽然AI降低了执行成本,但若无有效协调,将导致混乱。文章提出构建“公司大脑”,通过实时同步信息、识别冲突和自动路由依赖,消除机械性协调工作,让人类专注于创造性与协作性任务。
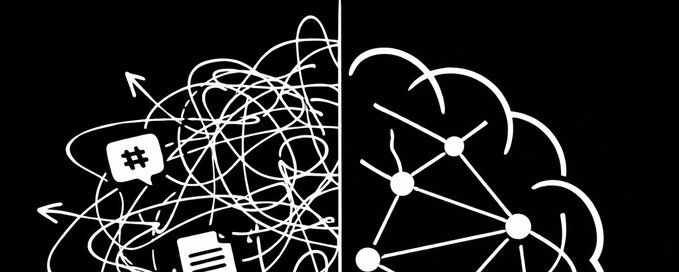
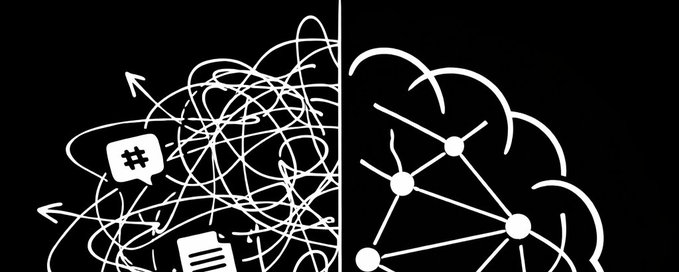
文章指出,当前的 AI Agent 侧重于通过 RAG 和 API 连接工具来检索信息,但检索不等于理解。真正的企业级 AI 应像一位资深幕僚,能够综合多源数据、解决冲突、追踪时效,并建立对企业环境的动态认知(“企业大脑”)。作者提出通过构建“上下文图谱”并将其以文件系统形式输出,让 Agent 能够获得经过综合处理的深层理解,而非每次都从零开始搜索。
文章指出,企业级 AI 代理目前仅停留在信息检索阶段,缺乏对公司的深层理解。真正的智能应像资深员工一样综合多源信息,构建持续更新的现实模型。作者提出了基于文件系统交付的“企业大脑”架构,主张通过上下文图谱解决数据冲突、身份统一和信源权威性等问题,从而实现从被动检索到主动理解的转变。