FlashAttention-4 from Scratch to Near-SOTA in 60 Diagrams (cuda/ptx)
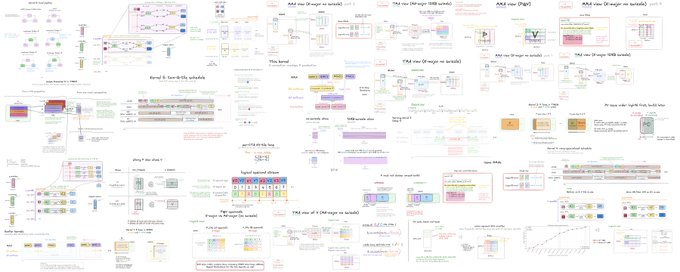
作者以60张图解的方式,从零开始在CUDA和少量PTX上构建B200的dense attention kernel,最终达到FlashAttention-4在4K/8K/16K序列长度下94.4%的性能。文章从baseline kernel讲起,逐步介绍每个优化,包含14个kernel的渐进式实现,重点分析Blackwell硬件上softmax与tensor core不对称扩展带来的瓶颈,并通过将softmax开销降低和与matmul重叠来优化。最后将kernel接入视频生成模型作为capstone项目。代码开源,适合GPU kernel研究入门。