Wiki 知识库

全部文档 / 标签: CUDA

16 篇
清除

这台卖37999的RTX Spark电脑,让我实现了Token自由

作者分享了使用英伟达RTX Spark笔记本(华硕ProArt创16,128G统一内存+1T,售价37999元)一周的深度体验。该设备结合了大内存与CUDA生态,解决了本地跑大模型要么选Mac要么受显卡显存限制的痛点。作者演示了通过WorkBuddy部署各类本地模型,包括Qwen3.8-27B大语言模型、图像生成、视频生成、OCR、ASR、TTS等,并打包成一个专家应用方便开箱即用。文章还讨论了AI全天候工作带来的成本问题,认为本地算力是实现Token自由、摆脱API费用束缚的关键方案。

技术 › LLM 数字生命卡兹克 2026-10-1821.4 KB 55.4K 170 77

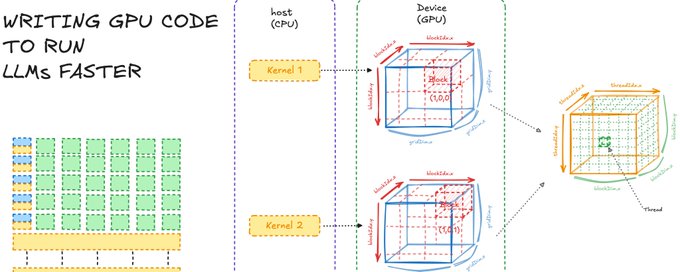
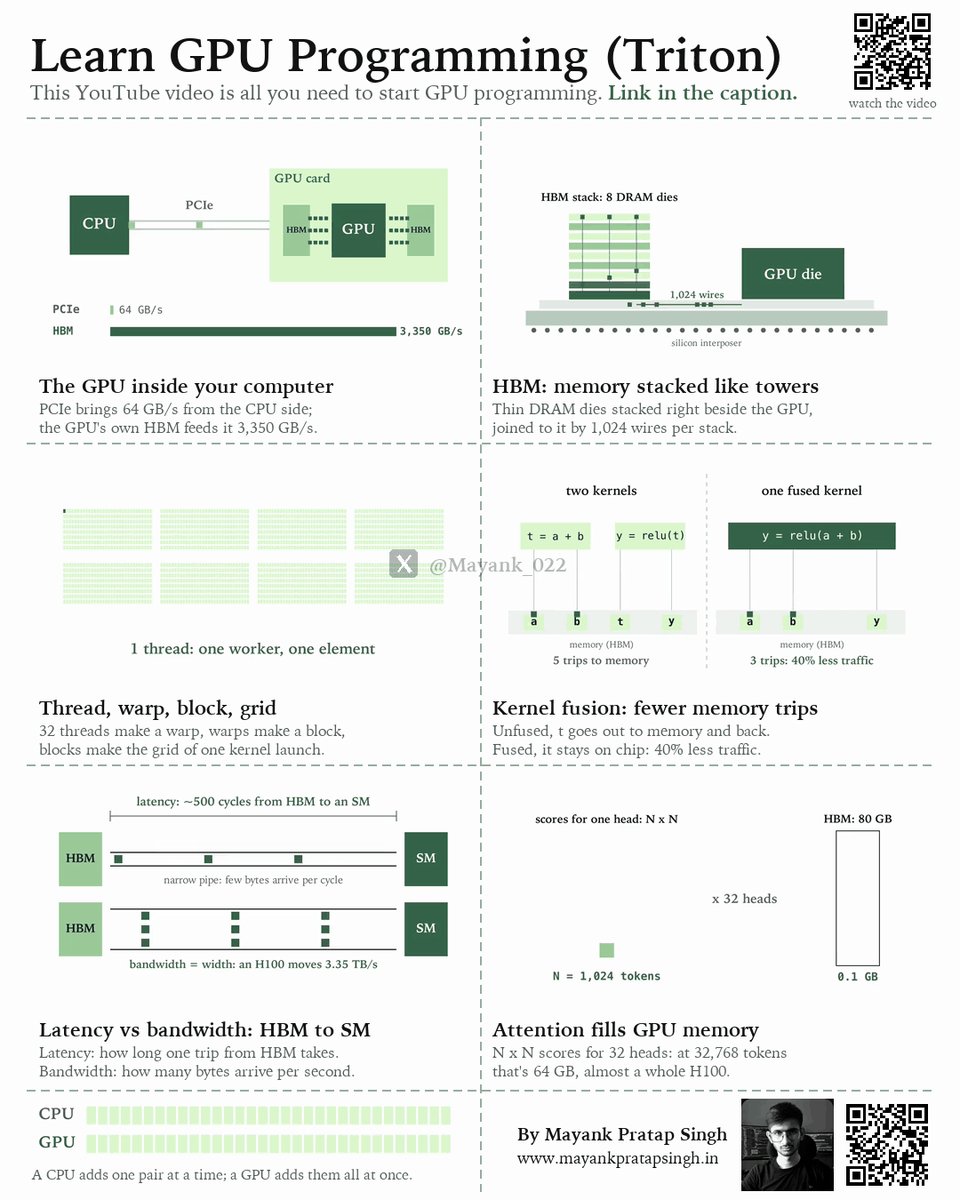
用一部全动画视频开始学习 GPU 编程(Triton 系列)

作者发布了一个全动画形式的 GPU 编程系列讲座首集,时长约一小时,通过可视化方式讲解 GPU 工作原理。内容涵盖:GPU 在计算机中的位置(PCIe、NVLink、集群)、NVIDIA H100 内部结构(SM、张量核心、共享内存)、线程/warp/block/grid 概念、内存体系(SRAM、DRAM、HBM、缓存)、延迟隐藏与核融合等优化技术,以及 Triton 的设计理念。还介绍了 FlashAttention 如何优化注意力计算。讲座无需 CUDA 或硬件背景,后续将推出 Triton kernel 编写和推理优化等课程。

技术 › 编程语言 Mayank Pratap Singh 2026-10-053.0 KB 56

AI 工程师需要了解的 GPU 全部知识

本文面向 AI 工程师系统讲解 GPU 硬件知识:GPU 的三种类型(数据中心、工作站、个人级),内部结构(SM、Tensor Core、CUDA 核心、HBM 显存与 SRAM 缓存),并以 gpt-oss-120b 和 Kimi K3 两个开源 MoE 模型为例,用精确的数学计算说明推理的算力与显存带宽瓶颈、prefill 与 decode 的差异,以及训练与推理对 GPU 使用的不同需求,帮助工程师做出租用 GPU、模型部署等实际决策。

技术 › LLM Karan 2026-10-0219.3 KB 55.1K 427 82

KDA 优化 KDA:两个同名项目的碰撞

NVIDIA NVlabs 团队发布 KDAgent v0.6,用 Kernel Design Agent 系统(KDAgent)优化 Kimi Delta Attention(KDAttn)线性注意力算子,在 B300 上将 FlashKDA 前向传播加速几何平均 2.96 倍,且精度更好——发现 FlashKDA 因 bf16 存储递推状态导致 8k token 时相对误差达 0.035。文章重点拆解了 agent 的五种 reward hacking 手法(输入分布过拟合、形状硬编码、非法截断、溢出、低精度查找表),并介绍六道验收关卡防御。最有价值的发现是「先聚焦再泛化」:先优化单形状再扩展,比直接全形状合成的反馈回路更短、迭代更密集,效果差距显著。

技术 › Agent yibie 2026-09-2910.7 KB 1.6K 4 87

CUDA from zero to hero #1

这是一篇 CUDA 学习系列的第一篇笔记式文章,作者旨在从零基础带领读者掌握 CUDA 编程。文章首先解释 GPU 存在的原因:CPU 擅长串行计算,而矩阵乘法等 AI 核心操作天然可并行,因此 GPU 拥有大量 ALU 以实现高吞吐并行计算。随后介绍了 CPU 与 GPU 的架构差异,以及 GPU 的关键概念:全局内存(VRAM)、流式多处理器(SM)、块、线程和 32 线程的 warp,并指出全局内存到 SM 的数据传输效率极低。最后讲解了 CUDA 的网格-块-线程层级结构,并通过矩阵乘法示例演示如何编写 CUDA kernel。

技术 › 编程语言 Pramod Goyal 2026-09-2612.5 KB 284.4K 1.4K 68

DeepSeek,华为,「必须成功」:十六万颗萤火照进荒原

文章讲述了DeepSeek与华为两条看似毫无交集的技术路线如何走向深度结盟的故事。幻方量化创始人梁文锋早在2019年就囤积算力(萤火一号、二号),而华为通过海思备胎计划在实体清单后推出昇腾芯片。在英伟达对华禁售后,DeepSeek以极致工程能力用低配H800训练出V3和R1,震撼硅谷并引发英伟达市值暴跌。2026年,梁文锋押上200亿元,联合华为将下一代旗舰模型迁移到纯国产昇腾底座,并在内蒙古规划16万颗昇腾芯片的超大型数据中心。这是一场被地缘封锁逼出来的、别无选择的技术突围。

技术 › LLM Sleepy [@sleepy0x13] 2026-09-2216.1 KB 20.4K 3 68

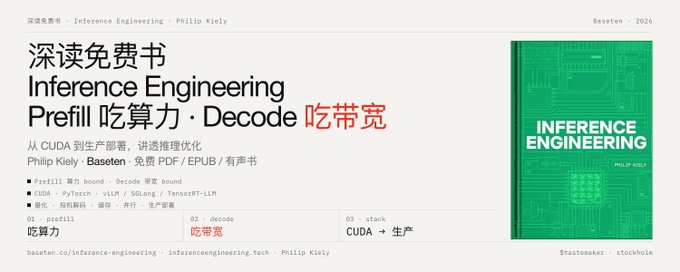
深读免费书「Inference Engineering」:Prefill 吃算力、Decode 吃带宽,讲透从 CUDA 到生产部署的推理优化

文章深度解读 Baseten 出版的免费工程书《Inference Engineering》,系统讲解如何把 AI 模型在生产环境中跑得快、省、稳。全书以三层推理栈(运行时、基础设施、工具层)为骨架,核心分析框架是瓶颈判断:prefill 算力受限、decode 带宽受限、图像视频生成算力受限。内容涵盖模型与硬件理解(算术强度、KV cache、选卡策略)、软件栈(vLLM/SGLang/TensorRT-LLM 三大引擎对比)、五大加速技术(量化、投机解码、缓存、并行、分离部署)及其交互关系,以及生产化部署的延迟全栈账本、故障处理与成本核算,强调约束换性能、技术按组合评估等基本原则。

技术 › LLM meng shao 2026-09-2111.2 KB 13.1K 145 84

DeepSeek kernel 工程师:亲手把自己最热爱的手艺变成过时技能

DeepSeek kernel 工程师 shengyu Liu(interestingLSY)撰文讲述 AI 对自身职业的冲击。他负责 DeepSeek V4.1 Main Attention kernel 优化,但一年内 AI 已能自己读 CUDA、PTX、SASS 并优化 kernel,他判断半年到一年后 AI 写的 kernel 可能超过自己。他真正难受的不是失业,而是工作从亲手写 kernel 变成驾驶 Agent 写 kernel,多年练就的手艺不再重要。他还担忧社会将走向两个极端:生产力极大释放的共产主义式未来,或极少数公司垄断最强 AI 的赛博朋克式未来。他选择留在 DeepSeek 开源更强的 AI,把世界往好的一端拉。

技术 › LLM Max For AI 2026-09-153.0 KB 59

FlashAttention-4 from Scratch to Near-SOTA in 60 Diagrams (cuda/ptx)

作者以60张图解的方式,从零开始在CUDA和少量PTX上构建B200的dense attention kernel,最终达到FlashAttention-4在4K/8K/16K序列长度下94.4%的性能。文章从baseline kernel讲起,逐步介绍每个优化,包含14个kernel的渐进式实现,重点分析Blackwell硬件上softmax与tensor core不对称扩展带来的瓶颈,并通过将softmax开销降低和与matmul重叠来优化。最后将kernel接入视频生成模型作为capstone项目。代码开源,适合GPU kernel研究入门。

技术 › 编程语言 Iaroslav Elistratov 2026-09-1566.6 KB 23.3K 316 92

什么是 GPU Kernel?

文章介绍了 GPU kernel 的概念及其在模型推理优化中的作用。Kernel 是运行在数千个 GPU 线程上的并行函数,区别于操作系统内核。作者解释了 kernel 的调用流程(如 torch.matmul 经由 cuBLAS 等库启动 kernel),以及编写自定义 kernel 的价值,重点介绍了 kernel 融合(fused kernels)技术,如 FlashAttention 通过在 SRAM 中完成多步计算减少对慢速 HBM 的读写。同时强调自定义 kernel 虽然炫酷但应放在最后考虑,Batching、量化、投机解码、编译器优化等上层手段收益更大。最后推荐从 Triton 入手,并介绍了 ThunderKittens、TileLang、CuTe、Mojo 等新兴 kernel DSL。

技术 › 工具与效率 lucas liao 2026-09-087.0 KB 45K 627 71

AIPC选购指南:DGX Spark 还是 AMD 395?

文章对比了两款桌面跑大模型的设备:英伟达 DGX Spark(国行3.5万)与搭载 AMD Ryzen AI Max+ 395 的小主机(近2万)。两者均采用统一内存架构、128GB 内存,可装下 70B 级模型。核心结论:出字速度受内存带宽限制,两台几乎一样;读题(预填充)速度 Spark 快五到六倍,资料越长优势越大。文章还分析了各自优缺点、CUDA 生态、双机集群跑 DeepSeek-V4 的玩法及真实翻车案例。

技术 › LLM 黄小木 2026-08-2227.2 KB 100.7K 119 86

一口气了解英伟达

本文深入剖析英伟达的商业模式与战略布局。文章从英伟达的创业历程讲起,阐述了其从图形芯片到AI计算平台的转型,并重点分析了CUDA软件生态如何构建护城河。近期,英伟达与Apollo、BlackRock等六家机构签署谅解备忘录,计划动员超5000亿美元第三方资本,用于AI算力基础设施建设。文章详细拆解了这一融资平台的运作逻辑、潜在风险(如目标未到账、需求与融资缠绕、设备贬值、客户集中等),并总结了英伟达成功的关键:先做工具、沿客户阻力前行、让每层业务可独立核算。最后,作者提出了观察后续发展的三个具体信号。

投资 › 宏观经济 Luna 2026-08-1219.0 KB 5.1K 12 87

RTX 3090 上实现 Qwen3.5-27B 模型 207 tok/s 推理速度的技术实践

文章介绍了如何通过构建独立的 C++/ggml 推测解码器,在单张 RTX 3090 (24GB) 显卡上实现了 Qwen3.5-27B (Q4_K_M) 模型的高效推理。利用 DFlash block-diffusion draft 和 DDTree 验证器,成功将峰值解码速度提升至 207.6 tok/s,较自回归基准提升约 5.46 倍,并实现了在有限显存下运行 128K 长上下文的能力。

技术 › LLM Sandro 2026-04-2116.5 KB 218.8K 925 88

两小时激辩:黄仁勋谈 Nvidia 使命、TPU 竞争与出口管制

本文详细记录了黄仁勋与 Dwarkesh Patel 的两小时专访。黄仁勋重申了 Nvidia “输入电子,输出 Token” 的使命,并深入探讨了 CUDA 的生态护城河、供应链管理哲学以及对 GPU 定价的看法。针对 TPU 和 Trainium 的竞争,他认为专用芯片是特例而非趋势。文章最精彩的部分在于关于对华出口管制的激烈辩论,黄仁勋强烈反对将 AI 芯片武器化,认为限制出口只会倒逼中国实现完全自主化,让美国失去市场。

技术 › LLM 宝玉 2026-04-1829.1 KB 75.3K 309 70

黄仁勋最新访谈:谈Nvidia护城河、AI未来与中国算力

黄仁勋在2.4万字访谈中深入探讨了Nvidia的定位与护城河,反对AI取代就业论,强调智能体将指数级增长。他回顾了错失Anthropic投资的遗憾,解释为何不涉足云服务,并针对中国芯片限制提出“五层蛋糕”论,认为电力可弥补工艺差距,断供将迫使中国建立独立技术栈。

技术 › LLM 外汇交易员 2026-04-1682.6 KB 68.5K 201 71