Wiki 知识库

全部文档 / 标签: FlashAttention

11 篇
清除

用一部全动画视频开始学习 GPU 编程(Triton 系列)

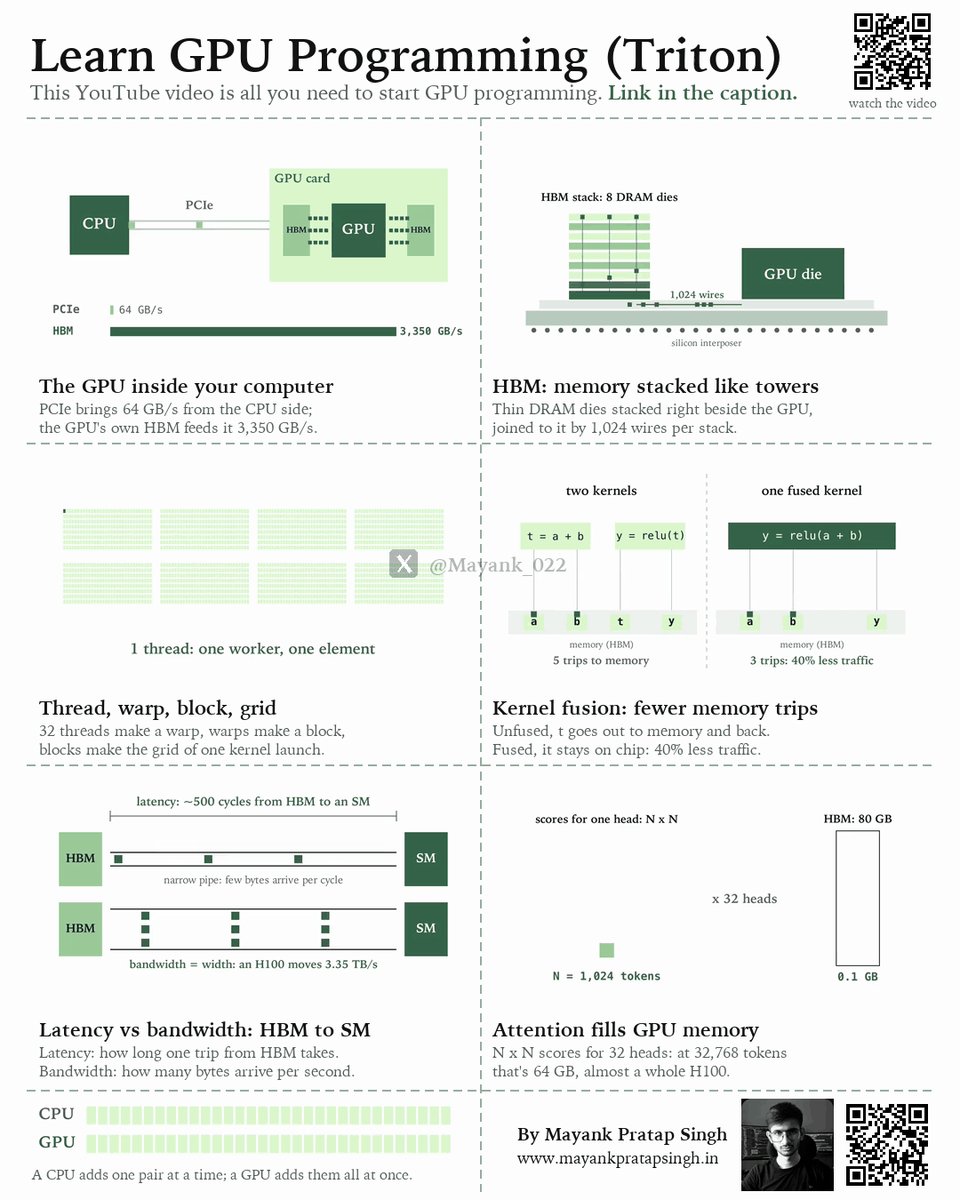
作者发布了一个全动画形式的 GPU 编程系列讲座首集,时长约一小时,通过可视化方式讲解 GPU 工作原理。内容涵盖:GPU 在计算机中的位置(PCIe、NVLink、集群)、NVIDIA H100 内部结构(SM、张量核心、共享内存)、线程/warp/block/grid 概念、内存体系(SRAM、DRAM、HBM、缓存)、延迟隐藏与核融合等优化技术,以及 Triton 的设计理念。还介绍了 FlashAttention 如何优化注意力计算。讲座无需 CUDA 或硬件背景,后续将推出 Triton kernel 编写和推理优化等课程。

技术 › 编程语言 Mayank Pratap Singh 2026-10-053.0 KB 56

「Learn Inference」LLM 推理工程全景指南:从 Attention 内核到多云 GPU 容量,两阶段、三层栈、五大技巧

本文是 Philip Kiely 所著《Inference Engineering》的交互式伴读站点介绍,系统梳理 LLM 推理工程全貌。文章以 prefill/decode 两阶段为原子结构,按运行时、基础设施、工具链三层展开,逐章讲解模型结构(Attention、KV 缓存、MoE)、GPU 硬件选型(带宽 vs 算力)、软件栈(vLLM、SGLang、TensorRT-LLM)、五大优化技巧(量化、投机解码、缓存、并行、解耦)以及多模态与生产实践(扩缩容、路由、成本、可观测性)。核心思想是:先诊断瓶颈再优化,一切优化皆是权衡,具体知识会过期而底层约束移动缓慢。

技术 › LLM meng shao 2026-09-2918.6 KB 3.4K 11 86

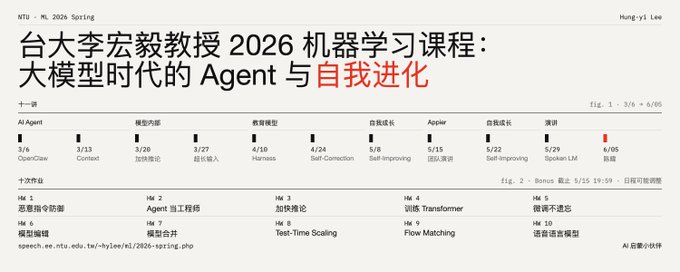
台大李宏毅教授 2026 机器学习课程更新:大模型时代的 Agent 与自我进化

文章介绍台湾大学李宏毅教授 2026 春季机器学习课程,该课程完成了从经典机器学习到大模型时代前沿课的彻底转型。课程以四幕叙事展开:AI Agent 与 Context Engineering、模型内部架构(Flash Attention、KV Cache、位置编码)、模型教育(Harness Engineering、自我修正)、模型自我成长(Self-Improving、自我进化 Agent)。十次硬核作业与授课主题严格对应,涵盖 LLM 安全、Agent 搭建、推理优化、后训练等技能。文章认为课程演变折射学科趋势:Agent 成应用层范式、系统级工程能力重要、后训练时代重心移向环境设计与模型自我进化。

技术 › LLM meng shao 2026-09-2710.2 KB 22.4K 222 85

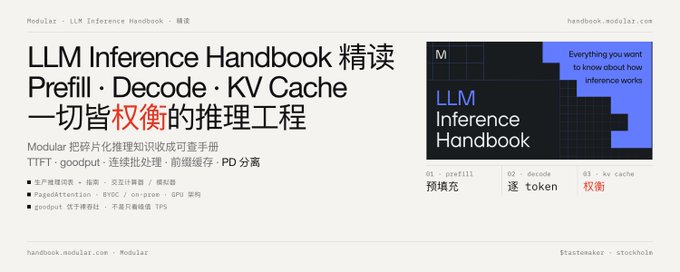
LLM Inference Handbook 精读:Prefill、Decode、KV Cache,与一切皆权衡的推理工程

本文深度解读 Modular 公司开源维护的《LLM Inference Handbook》,系统梳理 LLM 推理工程的知识体系。文章提炼三大核心框架:prefill(算力受限)与 decode(带宽受限)的两阶段二分法;KV cache 作为系统中心约束的地位,围绕它的 PagedAttention、prefix caching、PD 分离等技术网络;以及“一切皆 trade-off,唯一方法论是 benchmark”的工程哲学。内容还涵盖 continuous batching、speculative decoding、GPU 内存金字塔、FlashAttention、量化与蒸馏三部曲、Agent 生态与部署运维等主题,强调推理优化的本质是围绕有状态 KV cache 做内存管理与调度。

技术 › LLM meng shao 2026-09-2218.3 KB 14.6K 139 84

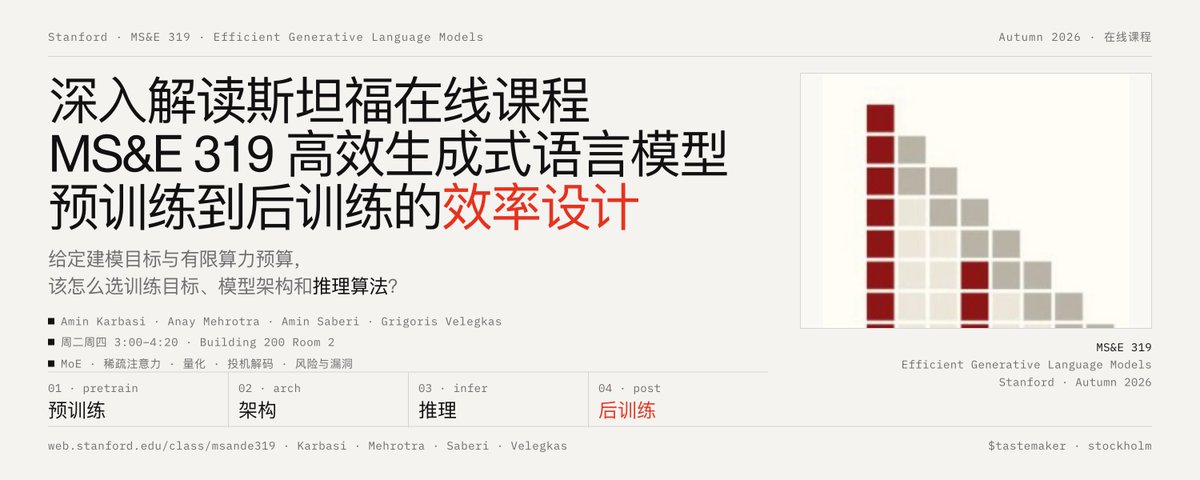
深入解读斯坦福在线课程 MS&E 319「高效生成式语言模型」

本文深入解读斯坦福 2026 秋季研究生课程 MS&E 319《Efficient Generative Language Models》。该课程以「效率」为设计科学,在算力预算有限的约束下,沿大模型生命周期系统讲授预训练、架构、推理、后训练四阶段的效率技术,包括多 token 预测、Muon 优化器、MoE、稀疏注意力、FlashAttention、KV 缓存压缩、量化、投机解码、LoRA、DPO 与蒸馏等,并涵盖越狱攻击与模型窃取等安全议题。文章认为该课填补了教育生态空位,内容前沿性与领域同步,揭示了每项效率技术背后的权衡取舍。

技术 › LLM meng shao 2026-09-2111.5 KB 18.9K 95 68

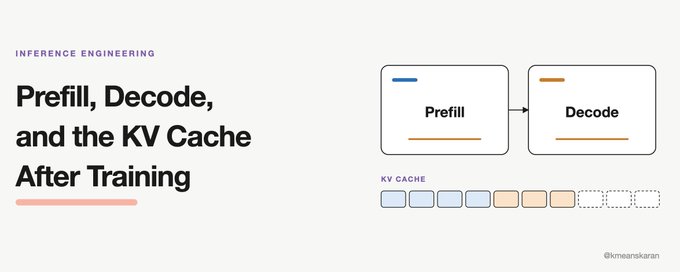
LLM Inference After Training: Prefill, Decode, KV Cache

本文系统讲解 LLM 推理阶段的核心原理。作者指出推理与训练不同,分为 prefill 和 decode 两个阶段:prefill 并行处理整个提示词、计算密集型、决定首 token 延迟(TTFT);decode 逐 token 生成、受 HBM 内存带宽限制、决定 token 间延迟(ITL)。文章介绍了 GPU 关键硬件概念(Tensor Core FLOPS、HBM、SRAM),逐步演示一个请求的完整流程(分词、采样、KV cache 机制),并将 FlashAttention、PagedAttention、continuous batching、RadixAttention 等优化技术归位到这两个阶段中,帮助读者理解推理瓶颈与优化方向。

技术 › LLM Karan 2026-09-1713.8 KB 29.4K 187 83

FlashAttention-4 from Scratch to Near-SOTA in 60 Diagrams (cuda/ptx)

作者以60张图解的方式,从零开始在CUDA和少量PTX上构建B200的dense attention kernel,最终达到FlashAttention-4在4K/8K/16K序列长度下94.4%的性能。文章从baseline kernel讲起,逐步介绍每个优化,包含14个kernel的渐进式实现,重点分析Blackwell硬件上softmax与tensor core不对称扩展带来的瓶颈,并通过将softmax开销降低和与matmul重叠来优化。最后将kernel接入视频生成模型作为capstone项目。代码开源,适合GPU kernel研究入门。

技术 › 编程语言 Iaroslav Elistratov 2026-09-1566.6 KB 23.3K 316 92

什么是 GPU Kernel?

文章介绍了 GPU kernel 的概念及其在模型推理优化中的作用。Kernel 是运行在数千个 GPU 线程上的并行函数,区别于操作系统内核。作者解释了 kernel 的调用流程(如 torch.matmul 经由 cuBLAS 等库启动 kernel),以及编写自定义 kernel 的价值,重点介绍了 kernel 融合(fused kernels)技术,如 FlashAttention 通过在 SRAM 中完成多步计算减少对慢速 HBM 的读写。同时强调自定义 kernel 虽然炫酷但应放在最后考虑,Batching、量化、投机解码、编译器优化等上层手段收益更大。最后推荐从 Triton 入手,并介绍了 ThunderKittens、TileLang、CuTe、Mojo 等新兴 kernel DSL。

技术 › 工具与效率 lucas liao 2026-09-087.0 KB 45K 627 71

LLM 注意力机制详解:从 Self-Attention 到 MLA

文章系统讲解了 Transformer 中各类注意力机制的演进:从自注意力、因果注意力、交叉注意力的基础概念,到 Multi-Head Attention(MHA)的表达力与显存代价,再到 MQA 通过共享 KV 头缩减缓存、GQA 在质量与内存间取得平衡成为主流、DeepSeek 提出的 MLA 通过低秩潜空间压缩 KV 缓存,以及 FlashAttention 通过改变内存访问方式优化计算效率。核心驱动力是 KV cache 的显存约束:长上下文大模型的注意力状态存储可与模型权重相当。每种机制都是为了解决前一设计的缺陷而诞生。

技术 › LLM Akshay 🚀 2026-09-0513.4 KB 191.5K 577 75

LLM 优化面试笔记:训练与推理核心技术

这是一份针对 AI 实验室面试准备的笔记,涵盖了高效训练和部署大语言模型(LLM)的核心优化策略。内容主要分为三部分:内存优化(如 Flash Attention、MQA/GQA、激活检查点)、计算优化(序列打包、高效变体 Transformer)以及推理优化(KV 缓存、投机解码、量化技术)。文章旨在总结在大规模模型开发中应对算力和内存瓶颈的关键技术。

技术 › LLM Gauri Gupta 2026-05-0654.2 KB 305K 758 65

LLM 工程师必读的 12 篇研究论文

文章列出了每位 LLM 工程师必须阅读的 12 篇核心论文清单,涵盖了从 Transformer 架构、BERT、GPT-3 等基础模型,到扩展定律、Chinchilla 训练法则、RLHF 对齐技术,以及 LoRA 高效微调和 FlashAttention 等工程优化技术。这些论文构成了现代大模型理解、训练和部署的理论基石。

技术 › LLM Amit Shekhar 2026-04-187.5 KB 236.4K 1.3K 39