Wiki 知识库

全部文档 / 作者: Roland.W / 标签: LLM

8 篇
清除

你对 AGENTS.md 的理解几乎为零

文章探讨了开发者对 AGENTS.md 和 CLAUDE.md 等 AI 编程工具说明文件的普遍误解。作者指出,很多团队把所有希望 AI 做到的事都写进一个不断膨胀的文件,导致维护规则本身成了负担,本末倒置。正确的做法是让 AGENTS.md 保持精简(作者根文件不到 50 行),只写每次开工都需要知道的少数核心事项,再指向不同任务对应的规则文件,让 Agent 按需读取。作者引用西蒙'存储信息'与'需要时获取信息'的区分,并提醒只有在流程确实需要反复执行时才值得做成 Skill,不必急于按需调用。

技术 › Agent Roland.W (@rwayne) 2026-09-244.3 KB 75

主体性均质化的时代,为什么大家的表达越来越相似?

文章提出'主体性均质化'概念,指不同个体在AI深度参与写作后,表达、品味、判断和构念逐渐趋同的现象。作者分析了AI润色如何抹平个人语气与思考,使创作者'不在场',导致内容产量激增但有效理解成本上升的'内容通货膨胀'。引用Doshi与Hauser的研究及西蒙的注意力经济学说明问题的深层影响。最后作者主张个人建构主义:静下心拉回注意力,不让AI替你思考和写作,在允许AI参与的同时保持个人构念的可渗透性,通过学习、模仿最终超越,坚持为情而造文的创作信条。

技术 › LLM Roland.W 2026-09-1411.9 KB 61.3K 80 66

提示词越写越长,为什么反而不管用了?

作者从内容创作和小说写作的实践出发,发现把所有约束堆在一条长提示词里反而失效。核心问题是所有限制都放在顶层,AI 每次都要重新判断哪条重要。作者提出将 Prompt 分为三级:快速原型级解决能不能做,开发级解决能不能稳定做,管理级负责调度 CLI、Skill、MCP、脚本、Agent 等执行单元。顶层 Prompt 像经理,只保留目标、路由、验收和异常处理,具体规则下沉到各执行单元自带的说明中。写 Prompt 最关键的能力不是表达,而是组织能力。

技术 › LLM Roland.W 2026-08-1810.5 KB 27.1K 41 74

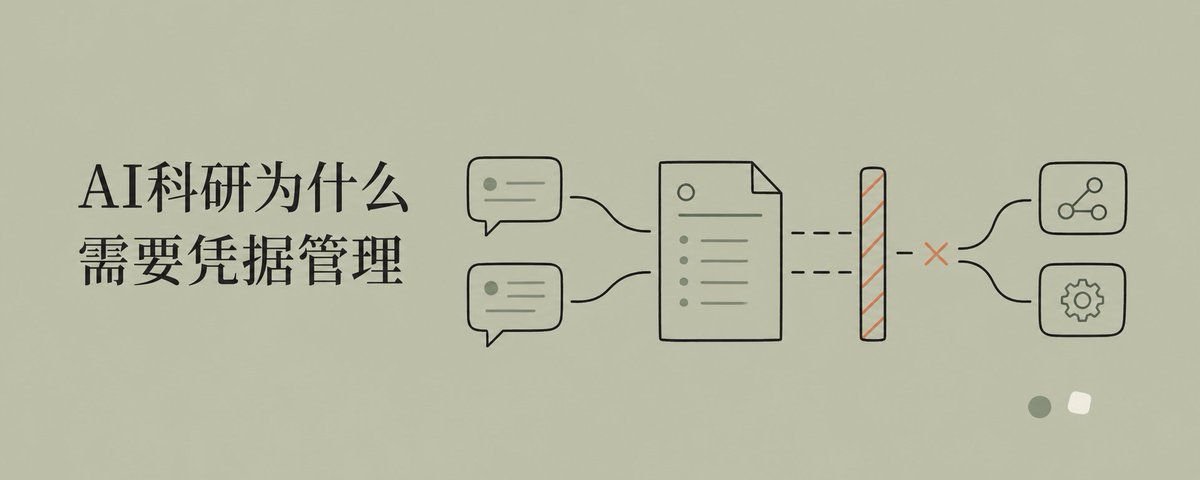
RW科研skill更新:为什么AI科研需要凭据管理

本文介绍了RW Research Skill中rw-research-passport的更新,新增了Research Credential功能,用于记录科研讨论形成的决定,并提供可验证和回溯的凭据。文章详细说明了凭据的内容、权限分类、不可篡改性及验证机制,强调了聊天记录不能直接作为执行权限的原因,并展望了无人值守的“睡后科研”场景。作者认为凭据管理是实现AI科研自动化和安全性的关键。

技术 › Agent Roland.W 2026-08-126.3 KB 33.6K 26 77

我找到了AI写作问题的根源(附解法)

本文深入剖析了AI生成文字中常见问题的根源,包括自造隐喻和英文句法迁移导致的语义错配。作者指出,AI写作常使用需要读者二次理解的表达,以及“反映出”等连接词将事实、解释和结论混为一谈。文章结合训练数据背景,解释了英文表达习惯为何会进入中文,并提出了与AI协作写作的具体方法:先分类原材料,再检查自造说法和连接词,最后使用提示词让AI输出原句、问题和建议。最终强调,人需对文章中的判断负责。

技术 › LLM Roland.W 2026-08-118.4 KB 114.7K 122 77

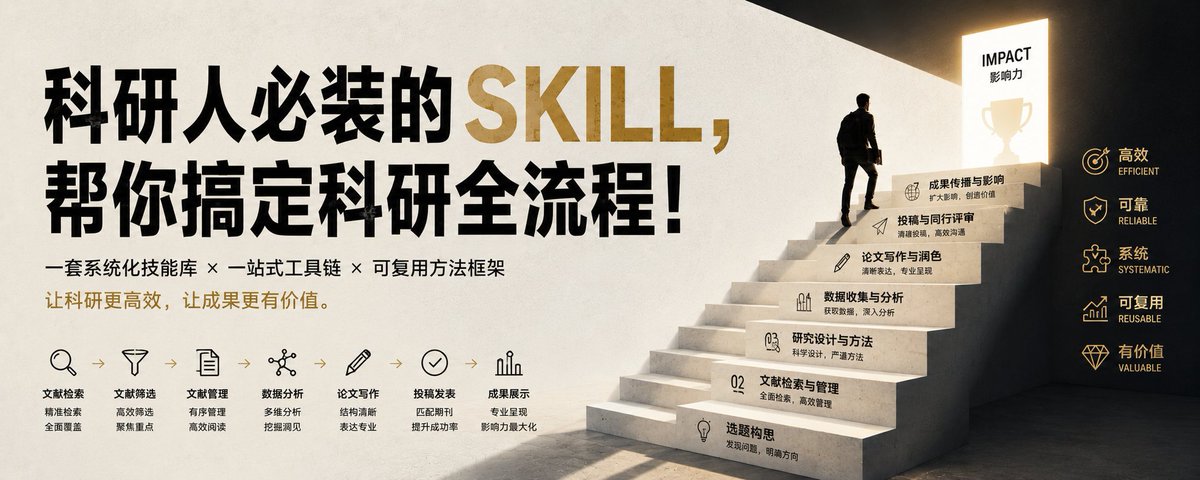
RW Research Skill:24小时启动科研项目的全流程工具

RW Research Skill 是一套包含18个独立AI技能的科研工具,通过路由器智能判断科研阶段,协助完成从研究问题界定、文献检索、数据分析到论文投稿的全流程。它能帮助研究者在24小时内启动并跑通第一个科研项目,解决科研流程中的顺序与效率问题。

技术 › Skill Roland.W 2026-07-199.0 KB 55.6K 141

AI 社会工程学:200 美元引发的信任危机

文章探讨了 AI 技术如何将社会工程学(骗术)的门槛从“十年经验”降至“200 美元”。通过语音克隆和 FraudGPT 等工具,诈骗已实现规模化和工业化。作者指出,AI 社会工程学不仅带来了巨大的经济损失,更深层地破坏了社会的信任基石,导致社会运转成本剧增,我们已身处一场全新的战争。

技术 › 网络安全 Roland.W 2026-05-146.7 KB 27.4K 35 69

什么是ACPD——人工智能能校准型人格障碍?

文章提出并定义了 ACPD(人工智能校准型人格障碍),指出长期重度使用 LLM(如 Claude、ChatGPT、豆包)的用户,会习惯于 AI 的完美校准与逻辑闭环,从而丧失对人类对话中“不平整”部分的容忍度。患者倾向于引用 AI 的回答来压倒性地纠正他人,误将模型的反馈等同于绝对真理,导致人际交往中的认知障碍与沟通冲突。

技术 › LLM Roland.W 2026-05-045.2 KB 24.4K 60 61