How to Build a Grounded Document Agent
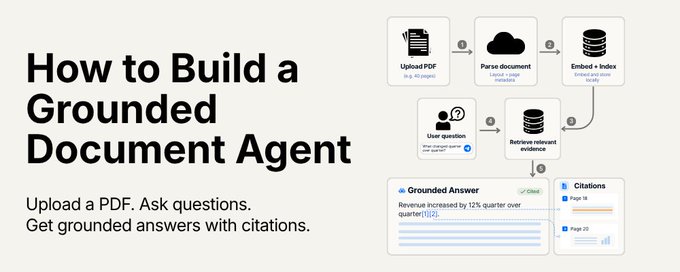
本文介绍如何构建一个带引用溯源的文档问答Agent(Grounded Document Agent)。核心问题是PDF解析质量决定答案上限:双栏排版、表格、图表等常被错误扁平化。项目使用LlamaParse在云端进行布局感知的Markdown解析并保留页码元数据,随后通过Ollama本地运行nomic-embed-text生成向量索引,配合CitationQueryEngine检索最相关的段落并生成带编号引用的答案。解析结果按文件哈希缓存以节省成本。界面展示页码、检索文本和相关度评分,让用户可检验引用背后的原始证据,区分解析、检索或生成阶段的错误。