Wiki 知识库

全部文档 / 标签: 向量检索

18 篇
清除

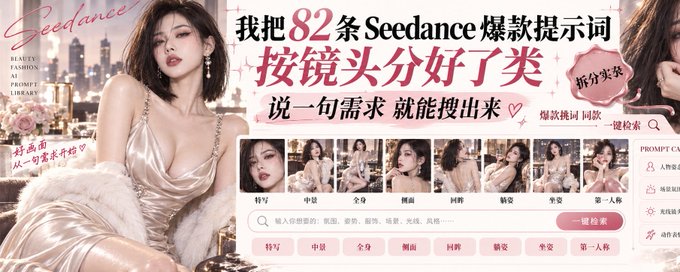
我把 82 条 Seedance 爆款提示词按镜头分好了类,说一句需求就能搜出来

作者从 GitHub 合集中挑选热度最高的 82 条 Seedance 2.5 视频生成提示词,来自 39 位 X 创作者,按镜头类型分为 9 类,并附上原作者、原帖链接及 36 条第三方复测结果(21 条复现成功,14 条效果衰减,1 条失败)。为解决分类后仍难以检索的问题,作者使用 EverOS Cloud 将提示词库转为可按语义检索的记忆库,只写两个脚本即可通过中文需求描述快速检索出匹配提示词及复测结论。完整提示词库和脚本已开源在 GitHub,方便读者三步搭建自己的提示词检索系统。
技术 › 工具与效率 王大锤 2026-10-255.0 KB 8.1K 87 71

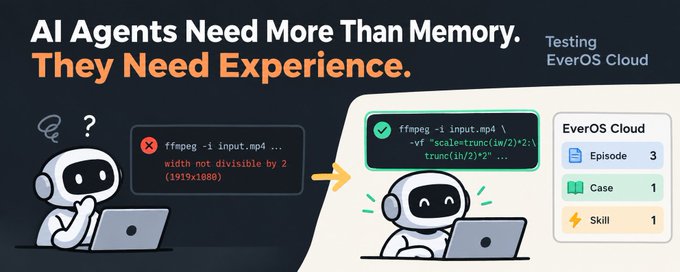
AI Agents Need More Than Memory. They Need Experience: Testing EverOS Cloud

作者实测 EverMind 的 EverOS Cloud——一个定位为 Agentic AI 的记忆操作系统。文章指出 RAG 式对话检索不等于经验提取,EverOS 将记忆分为 Episodes、Profiles、Cases、Skills 四类。作者用 Python API 模拟 FFmpeg 渲染报错(width not divisible by 2)场景:仅提交对话叙述只产生 Episode;提交完整的 tool_calls 执行轨迹后,系统成功生成结构化 Agent Case,并可用不同措辞的新查询检索到该 Case。测试验证了'执行轨迹→Case 提取→语义检索'链路,但 Skill 的生成与端到端复用仍待验证。作者认为 agent 记忆的价值在于保留可复用的工程经验,而非扩大上下文窗口。

技术 › Agent Steven Cheng 2026-10-218.9 KB 30.4K 144 78

Agent 高频题 01. 讲讲你的 RAG 链路

本文是 Agent 高频面试题详解系列第一篇,聚焦 RAG(检索增强生成)链路。文章基于近两个月牛客网 82 场面试的统计,指出 RAG 是最常被追问的题目。内容先给出 RAG 整体架构图,解释为什么需要 RAG 及其与长上下文、grep、微调、工具调用、记忆等方案的边界;再沿离线、在线两条线逐环讲解:离线部分涵盖文档解析、切分策略、embedding 向量化、HNSW/IVF 索引原理;在线部分讲解问题改写、BM25 与向量多路召回、RRF 融合、交叉编码器重排等环节。每个环节均附上面试常见追问,并提供复习优先级参考。

技术 › Agent 码良 2026-10-2041.5 KB 10.7K 70 78

Agent Memory Is Not a Search Problem

文章指出 Agent 记忆系统的核心问题不是检索而是上下文组织。跨 15 个模型、20 万模拟对话的研究显示,任务拆分为多轮会使准确率平均下降 39%,而合并为单轮可恢复大部分损失。文章回顾了 Agent 记忆的四个发展阶段(全量历史、滚动摘要、向量检索、知识图谱),批评语义/情景/程序性记忆分类无法指导检索决策,并主张按六种问题类型构建六种上下文形态。作者基于开源 Graphiti 引擎,以客户历史为例实操演示如何让记忆系统在模型运行前正确组织上下文,避免基于过时信息的自信回答。

技术 › Agent Akshay 2026-09-2919.3 KB 27.4K 171 86

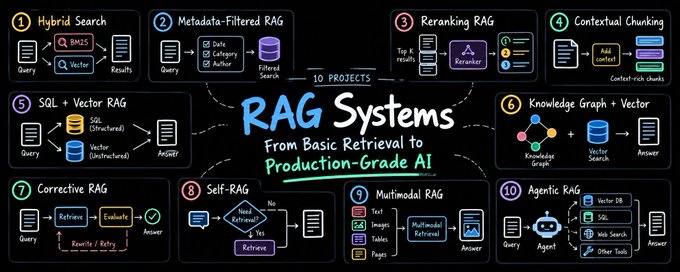
10 个带你从基础检索到生产级 AI 系统的 RAG 项目

文章指出仅掌握基础的'chat with PDF'式 RAG 流水线(分块、嵌入、向量检索、LLM)不足以构建真实生产系统,并推荐 10 个进阶项目:混合检索(BM25+向量)、元数据过滤、重排序、上下文分块、SQL+向量混合、知识图谱+向量、纠错式 RAG、自感知 RAG、多模态等。每个项目均说明要解决的问题、系统架构、技术栈(Python、pgvector、LangGraph、Neo4j 等)及学习要点,帮助开发者从语义相似度走向关键词匹配、结构化过滤、关系推理与检索质量反馈等生产级能力。

技术 › LLM Jaydeep 2026-09-2912.2 KB 22.5K 314 78

把 Jev 插进 RAG:爆速与降本到底能不能实现,实测验证

本文实测了 TypeSafe AI 发布的不生成文本的 AI 模型 Jev 在 RAG 检索流程中的效果。作者在重排、回答判断、检索前置门卫三个环节插入 Jev 进行验证:重排方面,Jev 以八分之一的成本达到接近 Cohere Rerank 的精度;在调用 LLM 之前用 Jev 判断「无法回答」,响应速度提升 5.6 倍,成本降至二十七分之一;在检索之前拦掉范围外提问,速度提升 7.4 倍,成本降至七十五分之一。此外,Jev 还能一次请求同时完成重排和回答判断。结论是用 Jev 改善 RAG 速度与成本可行,但需慎重设定阈值,避免误拦可回答问题。

技术 › LLM yibie 2026-09-2416.7 KB 10.8K 85 85

从0到1,搭建起你的个人知识库

文章从AI对话缺乏长期记忆的痛点切入,系统讲解了个人知识库的作用、分类与搭建方法。作者介绍了两大主流方案:以检索为中心的RAG知识库和以持续维护页面为中心的LLM Wiki知识库。RAG部分通过Dify演示了从资料上传、切片、混合检索索引建立到Agent接入的完整流程;LLM Wiki部分则介绍了Karpathy提出的三层结构(raw sources、wiki、schema),强调Markdown页面对AI友好且透明可查。最后作者分享了自己结合两者优势的混合方案,帮助读者根据实际需求选择合适的知识库路线。

技术 › LLM Lab 305 2026-09-2044.8 KB 27K 176 82

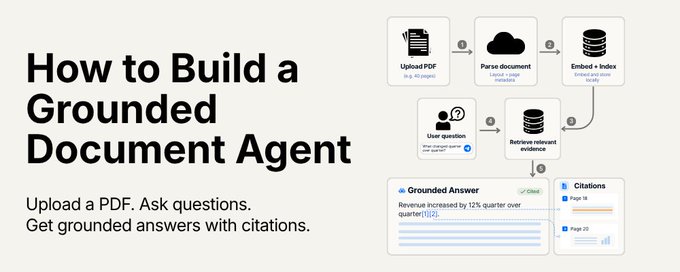
How to Build a Grounded Document Agent

本文介绍如何构建一个带引用溯源的文档问答Agent(Grounded Document Agent)。核心问题是PDF解析质量决定答案上限:双栏排版、表格、图表等常被错误扁平化。项目使用LlamaParse在云端进行布局感知的Markdown解析并保留页码元数据,随后通过Ollama本地运行nomic-embed-text生成向量索引,配合CitationQueryEngine检索最相关的段落并生成带编号引用的答案。解析结果按文件哈希缓存以节省成本。界面展示页码、检索文本和相关度评分,让用户可检验引用背后的原始证据,区分解析、检索或生成阶段的错误。

技术 › Agent Sumanth 2026-09-169.8 KB 45.7K 218 76

LEANN:省97%存储的轻量级本地RAG检索方案

传统RAG存储成本高昂,百万级文档索引动辄数百GB,本地设备难以承载。LEANN采用新思路:不存储所有向量,只保留精简的图结构,检索时按需计算,实现存储节省97%且精度不减。它可在笔记本上全本地运行,支持索引文件系统、邮件、浏览器记录、微信/iMessage、ChatGPT/Claude对话、Slack/Twitter实时数据及代码库,零云成本、数据不出设备、注重隐私。该项目已入选MLsys 2026,适合关注隐私的个人语义搜索开发者。

技术 › LLM LanfAI (@Huahuazo) 2026-08-31941 B 60

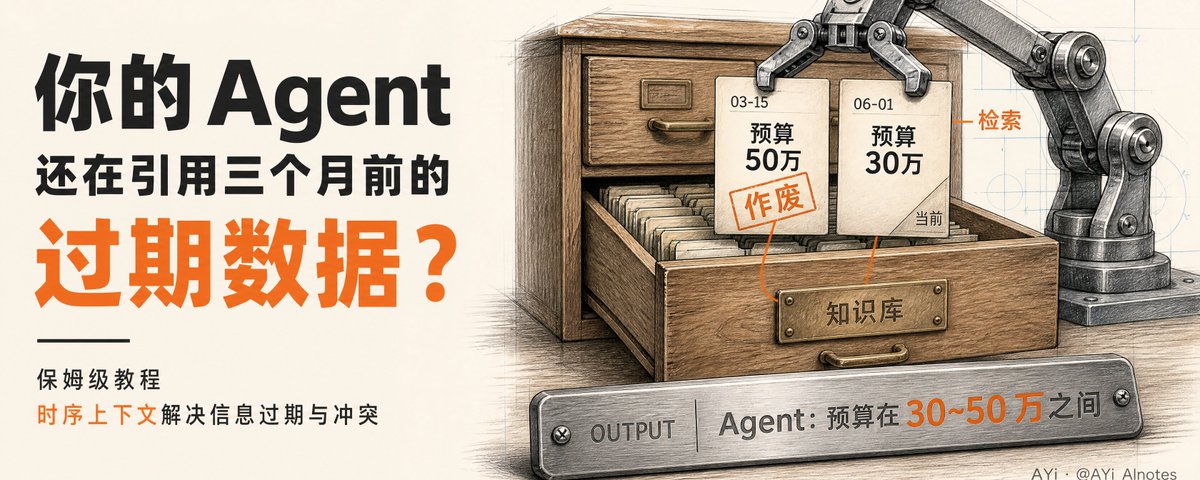
RAG 治不了 Agent 记忆过期:时序上下文的四个机制与开源路线实操

文章剖析了标准 RAG 在处理新旧事实冲突上的结构性缺陷:向量检索没有时间轴、不理解'取代'关系,只能把矛盾甩给模型猜测。作者提出时序上下文的四个核心机制——有效期标记、取代关系、软删除与遗忘、审计日志与证据链,并以 Graphiti 和 OpenContext 两条开源路线为参照讲解落地方式。OpenContext 提供基于时序上下文图的 remember/recall/improve/forget 四动词 API,在数据层解决事实过期问题;Graphiti 则专注作为可插拔的时序知识图谱记忆引擎。文末用律所预算变更案例演示了完整代码流程。

技术 › Agent AYi 2026-08-1822.8 KB 63.8K 159 86

《指挥 AI,做出一个企业级 Agent》08:企业 RAG 不是上传几个 PDF

文章指出企业 RAG 不仅仅是上传 PDF 回答问题,更需关注文档版本、权限、来源追溯及停用管理。作者通过模拟企业真实文档环境,构建了包含版本控制和过滤机制的评测体系,强调了可靠检索与诚实无答案的重要性,并分享了针对小规模知识库的技术选型经验。

技术 › Agent jager 2026-07-227.8 KB 21.2K 186

RAG 像素级拆解实战:索引、混合检索与评测体系

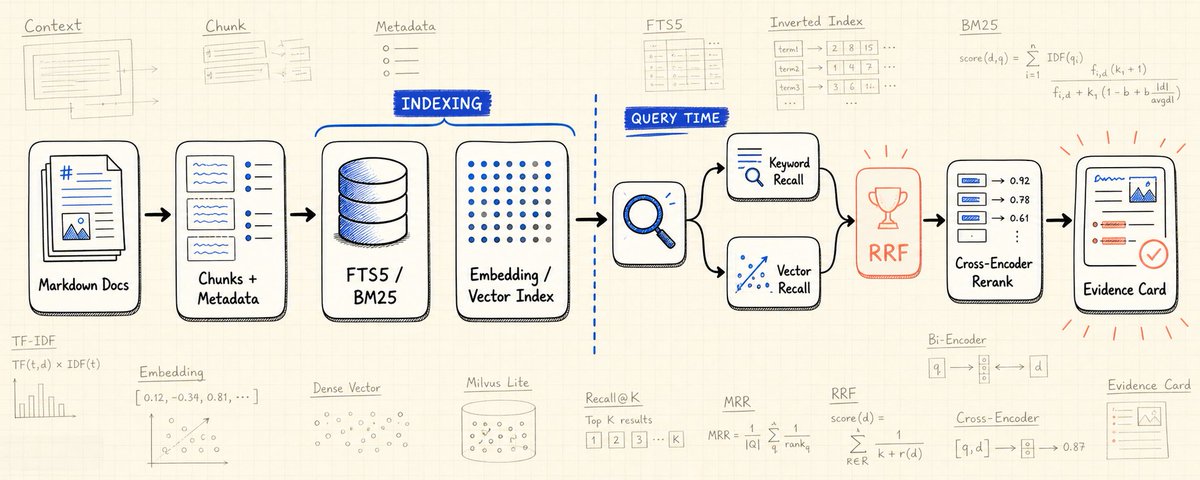
本文通过 Notebook 实战项目,对 RAG 系统的索引与检索过程进行了深度解析。内容涵盖文档切分(Chunking)、SQLite FTS5 倒排索引、BM25 关键词检索、向量 Embedding 语义检索,以及基于 RRF 的混合检索召回策略。此外,文章还介绍了如何构建评测集来验证检索效果,提供了完整的代码与数据结构示例,旨在帮助开发者理解 RAG 底层运作原理与工程实践细节。

技术 › LLM MateMatt 2026-07-1218.3 KB 43.4K 40

Agent 的数据面概念扫盲-建立技术侧认知体系

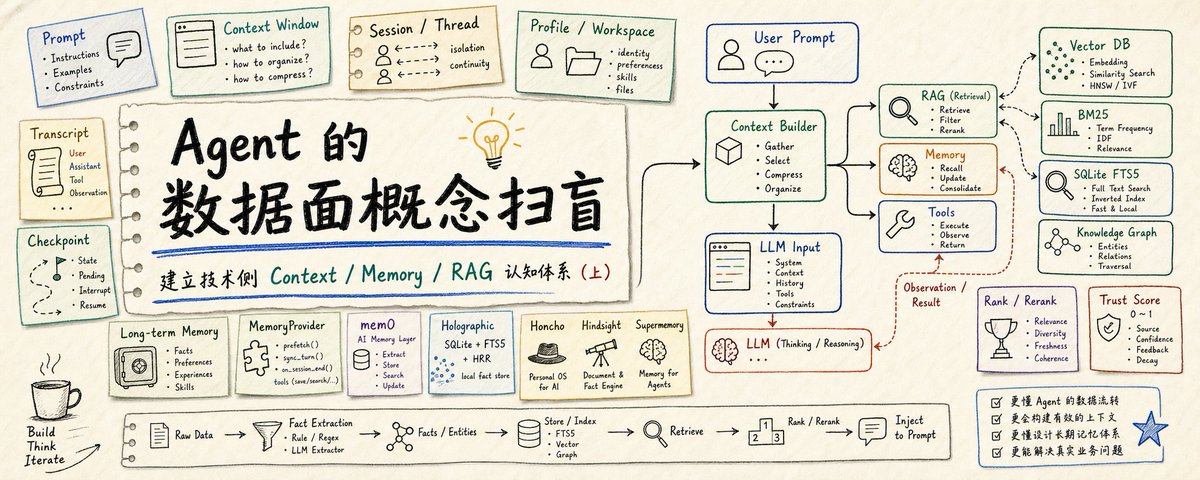
本文深入解析了 Agent 数据面的核心概念,将其比作操作系统的内存管理单元。文章详细阐述了 Context Engineering 的演变、Session/Thread/Profile 的架构差异,以及 Session Memory 与 Long-term Memory 的区别。作者还重点介绍了 Hermes 中的 Memory 设计方案、SQLite FTS5 与 BM25 算法原理,以及向量检索与关键词检索在 RAG 中的混合应用,旨在为开发者建立一套完整的 Agent 数据面技术认知体系。

技术 › Agent MateMatt 2026-07-1215.2 KB 13.2K 37

私有知识库从 demo 到生产,中间差了 8 层工程

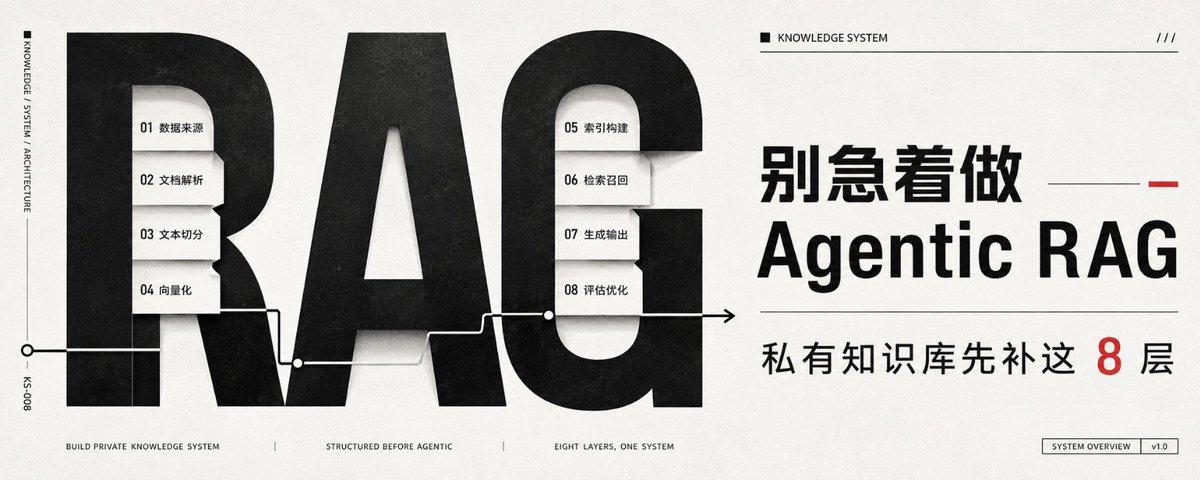
文章探讨了私有知识库项目在实际落地中遇到的挑战。许多 Demo 看起来聪明,但在生产环境中常因检索链路混乱而答非所问。作者指出单纯升级模型无济于事,根本在于构建稳固的 RAG 底座。文章详细拆解了从数据源、解析、清洗、切分、Embedding 到索引、检索、生成及评估的 8 层最小可用架构,并阐述了 Agentic RAG 如何通过决策层优化检索策略。最后提供了从 0 到 1 的搭建步骤及技术选型建议,强调权限过滤、混合检索与持续评估的重要性。

技术 › LLM A Ando 2026-07-0821.3 KB

私有知识库第4篇:评估集 + 增量更新,让 RAG 能长期跑下去

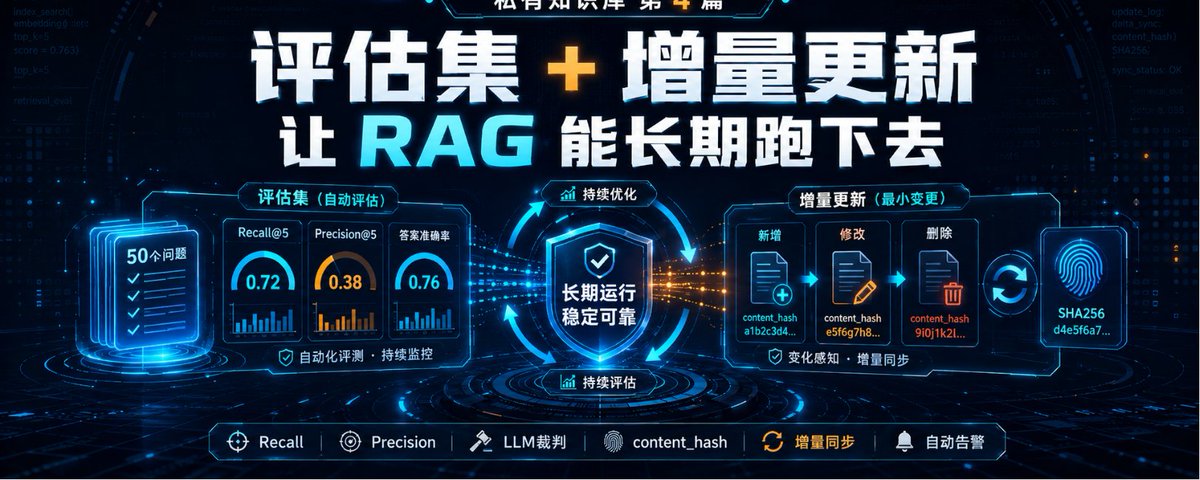
文章探讨了 RAG(检索增强生成)系统长期运行的两大难题:评估与更新。作者提出建立包含50个问题的“评估集”,通过 Recall、Precision 和 LLM 辅助的答案准确率来量化系统效果,避免盲目调参。同时,针对文档更新导致的全量重建成本问题,介绍了基于内容 Hash 的增量更新策略,仅处理变动文档,大幅降低资源消耗与停机时间。

技术 › LLM A Ando 2026-07-0817.6 KB

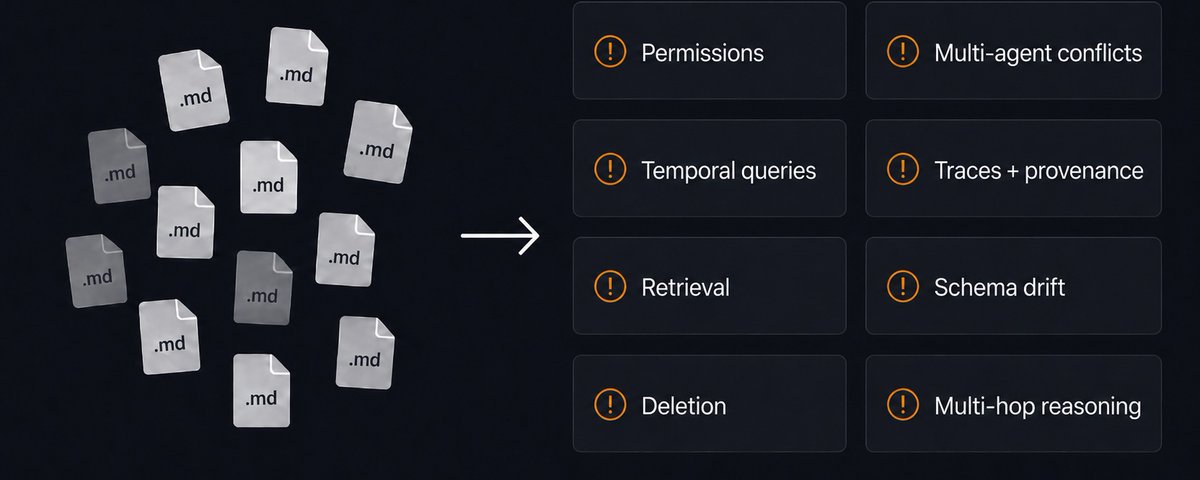
No .md files until Series B:为何生产级 Agent 需要真正的内存层

文章以一个垂直 Agent 创业公司因使用 Markdown 文件管理内存而导致架构崩溃的真实案例为引子,深入探讨了在构建生产级、多用户、多 Agent 系统时,简单文件存储无法解决的五大核心难题:细粒度权限控制、并发写入冲突、时态查询准确性、可追溯的自我改进机制,以及海量数据的检索效率。作者指出,虽然 MD 文件适合早期原型,但一旦系统规模扩大,开发者往往会不自觉地重新发明数据库,这实际上是倒退。

技术 › Agent Vasilije 2026-05-218.7 KB 61.3K 352 80

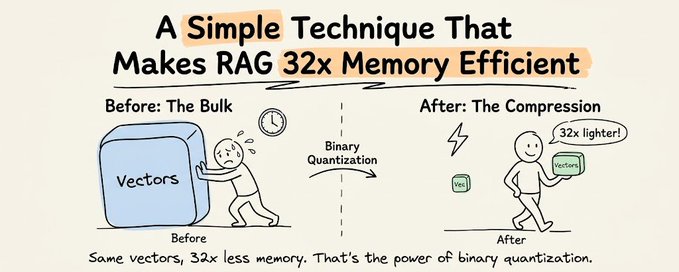
如何提高 RAG 32x 的内存效率(附代码说明)

本文介绍了利用二进制量化技术将 RAG(检索增强生成)系统内存效率提高 32 倍的方法。作者以 Perplexity 和 Azure 为例,详细展示了如何使用 Llama Index、Milvus 向量数据库和 Groq 托管的 Kimi-K2 模型构建系统。该系统可在 30 毫秒内查询 3600 万个向量,并在 1 秒内生成响应。文章提供了从数据加载、生成二值嵌入、向量索引到检索生成的完整代码实现。

技术 › LLM Avi Chawla 2026-04-055.4 KB 854.4K 907 78