Wiki 知识库

全部文档 / 标签: 本地模型

15 篇
清除

开源 Lemo-Wake skill:让静态图片一键动起来

作者开源了 Claude 插件 Lemo-Wake:给它一张图片,可生成约 5 秒、首尾无缝循环的动图。插件无需 API key、全部本地运行,支持照片、人像、海报、Logo、图表、表情包等。工作流程为读图理解画面、用本地模型抠图并补洞、代码重建编排动作、无头浏览器逐帧渲染并接回首尾。使用仅需四步:安装、放图说要求、选尺寸格式、看片修改。文中展示了生活随拍、人像合影、社交分享、表情问候、海报广告、Logo、图表、绘画等 8 类样例,并介绍 1.1.0 新增的拆图层功能(可导出 PSD/PNG 图层)以及社区投稿机制。

技术 › Skill Lemomo 2026-10-0614.4 KB 14.1K 69 83

2026 年最全免费 AI 资源盘点

作者花费 20 天实测了各类免费或近免费的 AI 模型获取渠道,包括免费 API、促销额度、创始人和学生计划、开源维护者资助等。文章指出多数“免费 AI”汇总信息过时且不准确,并从三个维度评估:永久配额与限时额度的区别、实验用途与生产用途的区别、以及隐藏的数据隐私代价。详细分析了 Google AI Studio、Groq、Cerebras、Mistral、Cloudflare Workers AI、OpenRouter、Cohere、OpenAI 等平台的免费额度与限制,还涵盖初创企业资助、学生福利、开源维护者计划以及地理限制,最后强调本地部署模型是唯一不可撤销的保底方案。

技术 › LLM Innopro 2026-09-2610.8 KB 381.6K 156 85

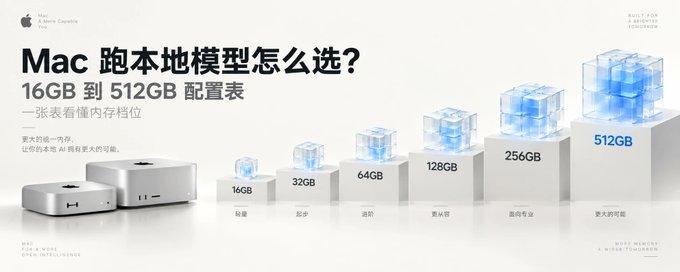
2026 Mac 跑大模型配置指南|16GB 到 512GB 怎么选

文章针对 Apple 新发布的 M6 Mac mini 与 M5 Mac Studio 系列,系统讲解如何为本地运行大模型选择合适配置。作者提出三笔账:内存容量决定模型能否装下、内存带宽决定生成速度、算力决定提示词处理和训练能力。给出 4 位量化模型内存估算公式和生成速度理论公式,并提供四档选购建议:24-32GB 跑 8B-14B、64GB 跑 32B、128GB 跑 70B、256-512GB 跑 200B 以上或 671B MoE。最后指出数据保密、高频调用、离线需求才是为本地模型购买大内存 Mac 的真正理由。

技术 › LLM 苏乐 2026-09-2019.6 KB 317.2K 453 86

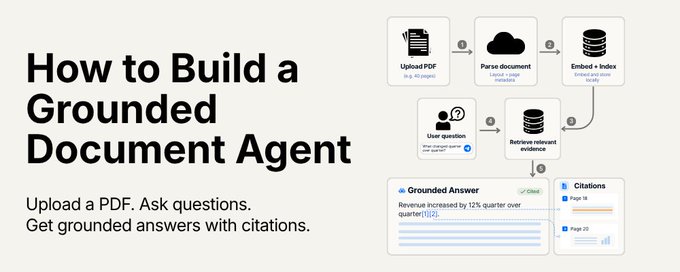
How to Build a Grounded Document Agent

本文介绍如何构建一个带引用溯源的文档问答Agent(Grounded Document Agent)。核心问题是PDF解析质量决定答案上限:双栏排版、表格、图表等常被错误扁平化。项目使用LlamaParse在云端进行布局感知的Markdown解析并保留页码元数据,随后通过Ollama本地运行nomic-embed-text生成向量索引,配合CitationQueryEngine检索最相关的段落并生成带编号引用的答案。解析结果按文件哈希缓存以节省成本。界面展示页码、检索文本和相关度评分,让用户可检验引用背后的原始证据,区分解析、检索或生成阶段的错误。

技术 › Agent Sumanth 2026-09-169.8 KB 45.7K 218 76

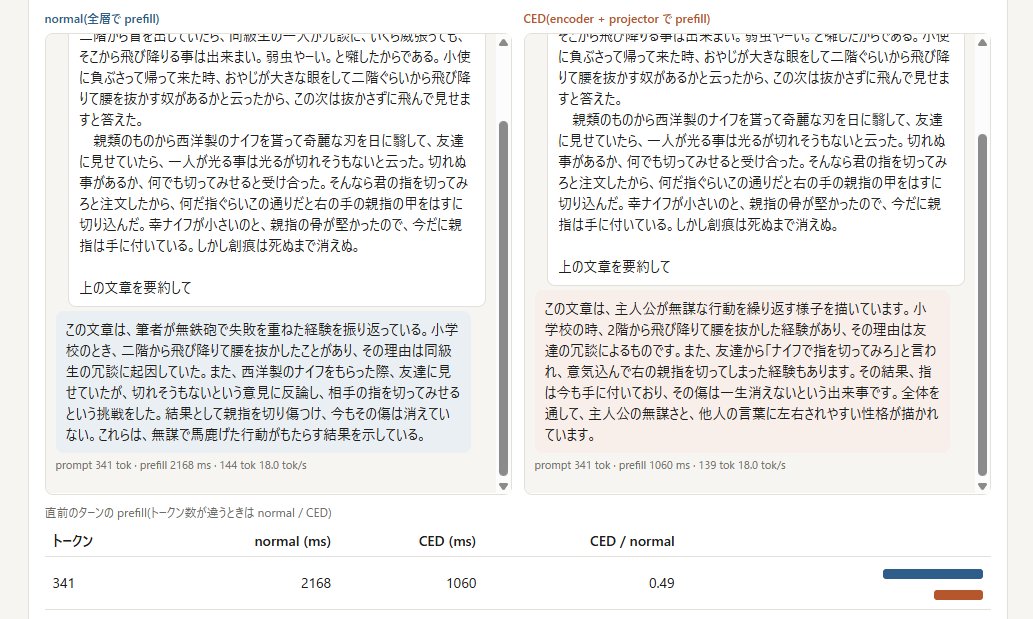
大开眼界:把 DeepSeek V4.1 Flash 的 Causal Encoder-Decoder 思路移植到 Qwen3-8B

文章介绍了一项实验:研究者将 DeepSeek V4.1 Flash 的 Causal Encoder-Decoder 机制移植到现有 Qwen3-8B 上,不修改原模型权重,仅外挂一个小模型近似后半层 KV Cache,使 Prefill 时间缩短近一半且输出一致。作者分析了这对本地模型部署(尤其 DGX Spark)的重大意义:长上下文首 token 等待明显降低,KV Cache 内存占用减少,Coding Agent、Computer Use Agent 等本地工作负载体感大幅提升。文章同时指出结果尚需在更多任务上验证,但认为已有模型可通过轻量近似层获得架构级推理升级。

技术 › LLM Wei (@wei_wang) 2026-09-135.5 KB 75

越狱大模型小白从 0 到 1 教程

本文面向新手系统讲解大模型越狱的基础知识。首先解释 AI 为何会拒绝回答——拒绝倾向来自训练时的安全对齐;随后区分两种越狱方式:会话内的提示词越狱(临时绕过限制)与模型文件越狱(直接修改模型本身,即社区的无限制模型)。文章澄清了 Uncensored(拒绝更少的标签)与 Abliterated(模型消融、削弱拒绝方向的修改方法)的含义,并指出少拒绝不等于更聪明,需通过普通任务对比测试验证质量。最后介绍 Base/Instruct、GGUF、量化等模型名词,并给出写小说、阅读敏感资料等实际应用建议。

技术 › LLM 黄小木 2026-09-079.5 KB 131.5K 247 68

1分钟,开源模型原生支持移动端

作者分享通过UU远程的最新升级,让本地运行的开源大模型(如Qwen 27B)拥有了手机端入口。相比Codex远程控制只支持自家模型、Claude Code远程有封号风险,本地模型不花钱、不封号且速度快。UU远程基于tmux实现,支持完整TUI渲染、多终端会话、跨端接管和语音输入,且免费。作者还开源了uu-term-bridge工具,让iTerm2中的所有会话自动出现在手机列表,实现桌面与手机双向无缝切换,补齐了与Codex远程体验的差距。

技术 › 移动端 实践哥 Li 2026-09-067.0 KB 231.2K 110 74

万字长文 | 最强 AI 工作台 Cherry Studio 从入门到精通(含本地模型部署)

本文是一篇 Cherry Studio 的详细使用教程。Cherry Studio 是一款开源桌面 AI 工作台,可接入 GPT、Claude、DeepSeek、Kimi 及本地模型。文章系统讲解了软件安装与模型 API 配置方法,如何用多模型对比测试写作质量,利用分支功能管理不同写作路线,创建助手保存长期要求;还介绍了如何把文档整理等任务交给 Agent,配置工具权限、网络搜索、技能和 MCP;以及知识库的建立、召回测试、嵌入与重排模型的配置,和通过 Ollama、LM Studio 接入本地模型的方案。适合希望集中管理多个 AI 模型、提升日常工作流效率的用户从入门到进阶参考。

技术 › 工具与效率 Miles Ma 2026-08-3022.7 KB 380.9K 396 87

本地小模型实测!Ling-3.0-tiny vs Qwen3.5-9B

作者在 AMD Ryzen AI MAX+ 395 小主机上,用相同提示词和 Hermes 环境,对 Ling-3.0-tiny 与 Qwen3.5-9B(均 Q8_0、64K 上下文)跑三份真实业务任务:电商中台需求整理、商务合作决策备忘录、X 长文数据分析。结果 Ling 在前两轮抓住主线、输出可继续修改,总耗时仅约为 Qwen 的 56%;Qwen 在数据题上更稳,但商务任务两次失控,一次忘记任务、一次虚构公司实体。作者最终选择 Ling 作为默认模型,并强调应以模型最差一轮而非最好一轮作为取舍标准,同时收紧本地 Agent 的权限边界,保持人工把关。

技术 › LLM SakuAI 2026-08-298.2 KB 7.2K 20 83

如何用Ling-3.0-tiny搭配DeepSeek Harness本地处理敏感数据?新手友好教程

文章介绍了一套面向新手的本地化AI方案:用DeepSeek Harness作为Agent框架读取文件、运行工具,配合本机运行的Ling-3.0-tiny(7.9B总参数、约1.3B激活参数的MoE模型)完成推理,适用于律师事务所、财税、医疗等需要处理敏感文档的场景。作者在2021款MacBook Pro(M1 Pro、32GB内存)上实测,生成速度约40 tokens/s,可胜任合同摘要、结构化抽取、多文档时间线整理和交叉核对等任务。文章详细说明了部署步骤,并通过虚构法律文书的摘要、JSON抽取、时间线生成三项测试验证效果,同时提醒本地运行不等于自动合规,专业文书仍需人工复核。

技术 › Agent WY 2026-08-299.3 KB 11.3K 52 80

AI采用的真相:工作流级个人采用为何胜过企业部署

文章指出企业已投入300-400亿美元于AI,但MIT报告显示95%的试点无可衡量的利润影响,而90%以上公司的员工已自发使用AI。作者提出'工作流级采用'概念:采用=模型+个人上下文+一个重复性工作流。借助Ollama、LM Studio在本地运行开源小模型,个人可绕过许可、成本与隐私障碍,通过积累定制上下文让模型深度融入日常工作。相比企业冗长的审批链,个人采用从决定到落地只需一个下午,更具现实性。

技术 › LLM AI Guides 2026-08-1813.7 KB 67K 66 76

别再用一个 skills 来忽悠人了,完整工程才是买单的起点

文章分享了作者试用开源项目“Moonlit Stories”生成英文绘本的体验。作者指出,该项目成功的关键在于将内容、视觉、音频等流程固化成契约,让Agent按规范执行。这表明个人利用本地模型和Agent工作流,已能独立交付过去需专业团队完成的完整产品。

技术 › Skill SagaSu 2026-08-0610.5 KB 2.9K 6

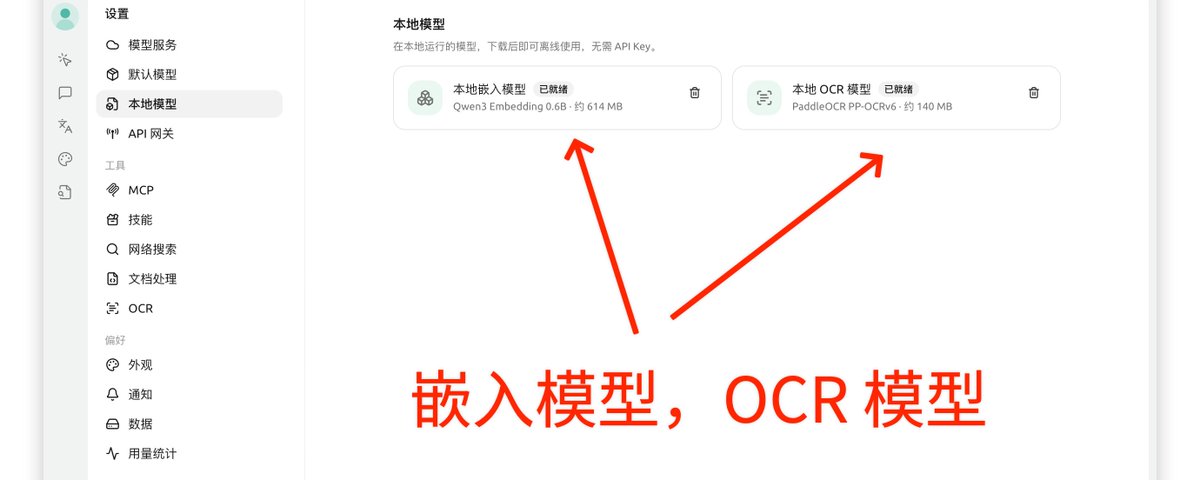
聊聊 Cherry Studio 2.0 对本地模型的支持

文章探讨了 Cherry Studio 2.0 对本地模型的支持策略。作者认为本地模型的主要价值不在于替代云端大语言模型,而是通过 Embedding、OCR、ASR 和数据脱敏等轻量级模型,补齐 AI 产品中的关键基础能力。这种设计旨在降低用户使用门槛,提高隐私保护,并确保功能的稳定性。

技术 › 工具与效率 Yinsen 2026-08-067.8 KB 7.3K 29

8G显卡本地未审查生图,42个风格我都替你测好了

作者分享了基于8G显存的本地AI生图整合包Z-Image v1.4.0,包含42种预测风格和FP8/GGUF/BF16三种档位。该工具旨在降低小白使用门槛,通过一键式操作实现未审查的本地生图,保障隐私且支持参数复用,适用于封面制作、分镜设计等场景。

技术 › 工具与效率 达芬七Seven 2026-08-0111.4 KB 469.2K 839