Wiki 知识库

全部文档 / 标签: LlamaIndex

5 篇
清除

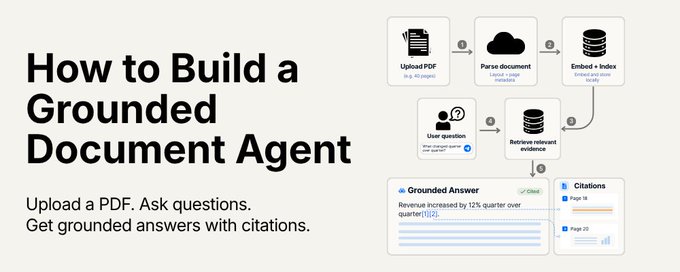
How to Build a Grounded Document Agent

本文介绍如何构建一个带引用溯源的文档问答Agent(Grounded Document Agent)。核心问题是PDF解析质量决定答案上限:双栏排版、表格、图表等常被错误扁平化。项目使用LlamaParse在云端进行布局感知的Markdown解析并保留页码元数据,随后通过Ollama本地运行nomic-embed-text生成向量索引,配合CitationQueryEngine检索最相关的段落并生成带编号引用的答案。解析结果按文件哈希缓存以节省成本。界面展示页码、检索文本和相关度评分,让用户可检验引用背后的原始证据,区分解析、检索或生成阶段的错误。
技术 › Agent Sumanth 2026-09-169.8 KB 45.7K 218 76

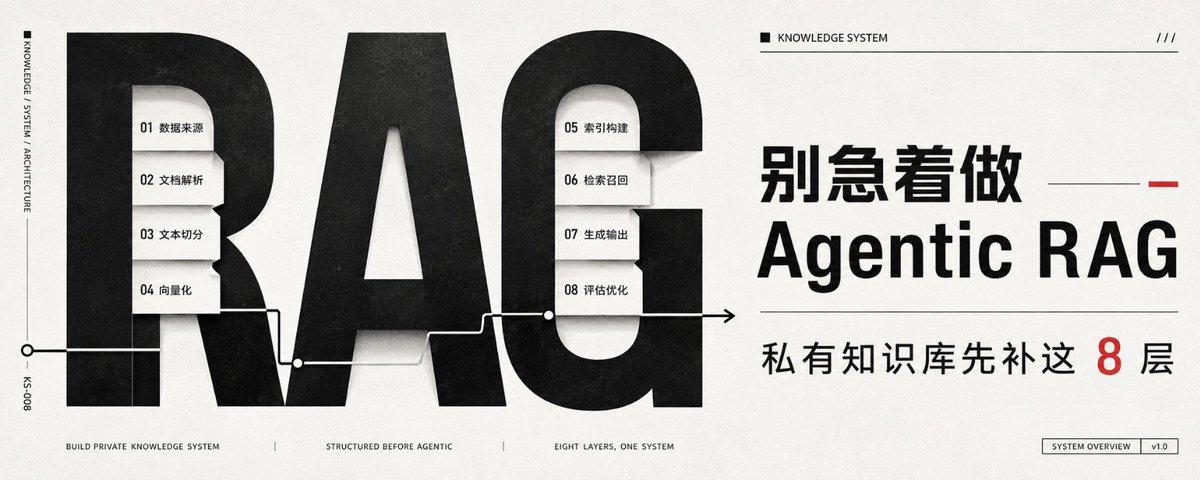
私有知识库从 demo 到生产,中间差了 8 层工程

文章探讨了私有知识库项目在实际落地中遇到的挑战。许多 Demo 看起来聪明,但在生产环境中常因检索链路混乱而答非所问。作者指出单纯升级模型无济于事,根本在于构建稳固的 RAG 底座。文章详细拆解了从数据源、解析、清洗、切分、Embedding 到索引、检索、生成及评估的 8 层最小可用架构,并阐述了 Agentic RAG 如何通过决策层优化检索策略。最后提供了从 0 到 1 的搭建步骤及技术选型建议,强调权限过滤、混合检索与持续评估的重要性。

技术 › LLM A Ando 2026-07-0821.3 KB

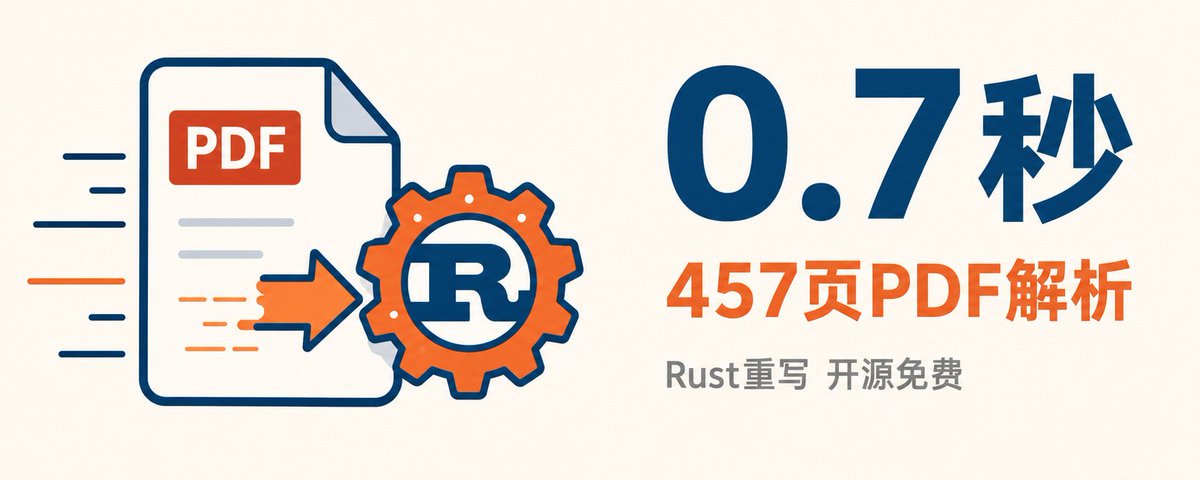
LlamaIndex 用 Rust 重写文档解析器 LiteParse

LlamaIndex 推出完全用 Rust 重写的文档解析器 LiteParse。相比旧版,新版本在处理大文档时速度提升 3 倍,小文档提升可达 100 倍,实测 457 页 PDF 解析仅需 0.777 秒。该工具支持 Python、Node.js、Rust 及浏览器环境,覆盖 PDF、Office 等主流格式,具备原生 OCR 能力,且可作为 Agent Skill 直接集成。

技术 › 工具与效率 Jason Zhu 2026-05-284.3 KB 73.3K 591 81

Agent Harness 中的上下文管理机制深度解析

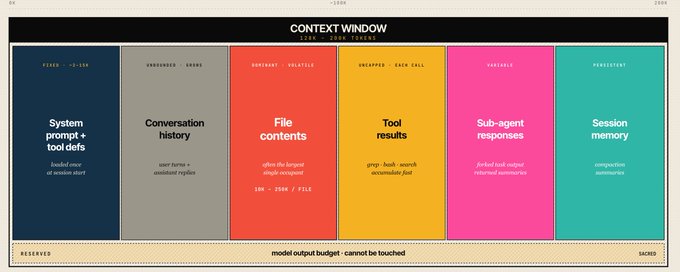
文章深入探讨了构建 Agent Harness 时面临的上下文窗口管理挑战。通过对比 Pi、OpenClaw、Claude Code 和 Letta 四种主流系统,详细分析了它们在处理大文件读取、会话剪裁和摘要生成时的不同工程策略。文章指出,优秀的系统不应将上下文窗口视为被动缓冲区,而应主动管理状态、建立索引并智能分页,以维持长会话中的连贯性。

技术 › Agent Aparna Dhinakaran 2026-04-2730.9 KB 151.6K 774 74

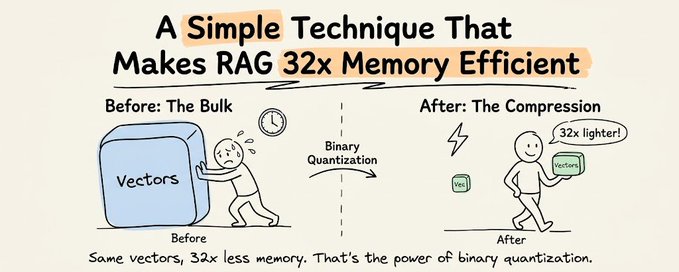
如何提高 RAG 32x 的内存效率(附代码说明)

本文介绍了利用二进制量化技术将 RAG(检索增强生成)系统内存效率提高 32 倍的方法。作者以 Perplexity 和 Azure 为例,详细展示了如何使用 Llama Index、Milvus 向量数据库和 Groq 托管的 Kimi-K2 模型构建系统。该系统可在 30 毫秒内查询 3600 万个向量,并在 1 秒内生成响应。文章提供了从数据加载、生成二值嵌入、向量索引到检索生成的完整代码实现。

技术 › LLM Avi Chawla 2026-04-055.4 KB 854.4K 907 78