第一次进企业聊 AI,我才发现最难的根本不是 AI
作者以大三学生身份第一次走进企业现场,与企业管理者探讨 AI 落地问题。他发现企业需求分三层:愿望、业务任务、可执行的输入输出,多数讨论停留在愿望层。真正难点在于业务经验未结构化沉淀、知识库治理、以及先跑通最小可行案例(MVP)。文章提出 FDE(前置工程师)工作方式:在业务语言、工程语言和 AI 结构化语言之间翻译,强调 human in the loop、机密边界与人工审核,最后计划用不涉密的机械臂/AGV 案例验证完整链路。
作者以大三学生身份第一次走进企业现场,与企业管理者探讨 AI 落地问题。他发现企业需求分三层:愿望、业务任务、可执行的输入输出,多数讨论停留在愿望层。真正难点在于业务经验未结构化沉淀、知识库治理、以及先跑通最小可行案例(MVP)。文章提出 FDE(前置工程师)工作方式:在业务语言、工程语言和 AI 结构化语言之间翻译,强调 human in the loop、机密边界与人工审核,最后计划用不涉密的机械臂/AGV 案例验证完整链路。
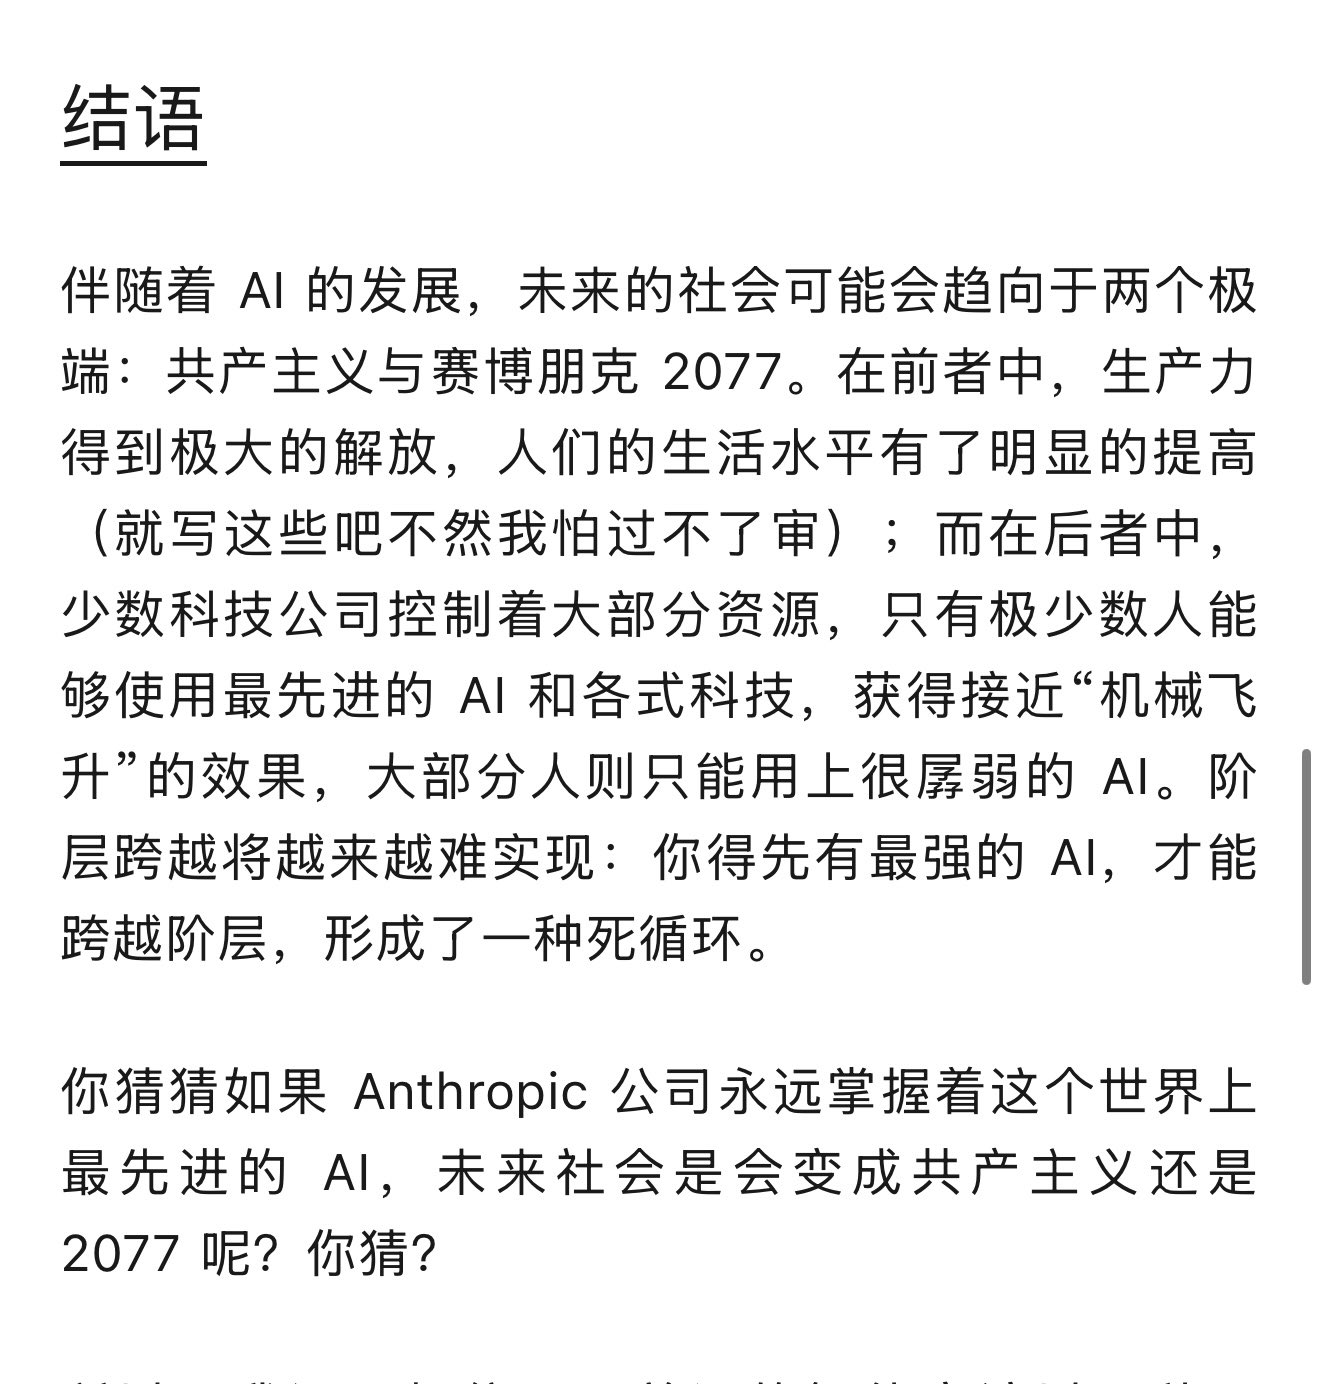
文章包含两条内容:一是 DeepSeek kernel 工程师 Shengyu Liu 的长文,讲述 AI 已能自主分析 CUDA/PTX/SASS 并优化 kernel,他预判半年到一年内 AI 写的 kernel 可能超过自己,工作将从亲手写代码变为驾驶 Agent,并担忧未来社会走向共产主义或赛博朋克两极,因此选择留在 DeepSeek 推动开源 AI。二是微信团队开源的 WeKnora 框架,已从 RAG 系统进化为企业 Agent 基础设施,提供知识处理、ReAct Agent、Sandbox 执行环境、长期记忆和 Auto-Wiki 能力,代表 RAG 向企业 Agent Context + Runtime 的迁移趋势。
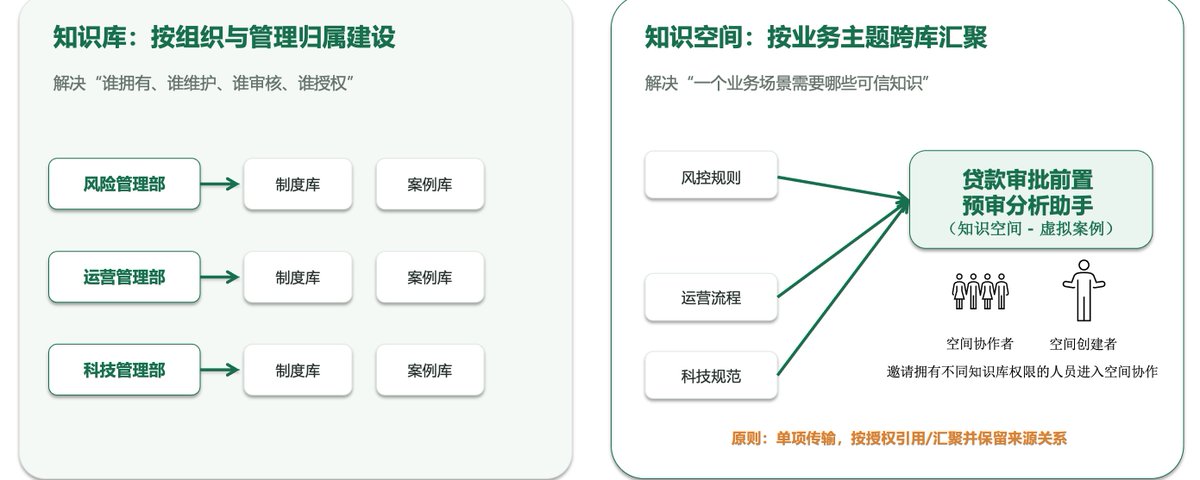
文章基于企业级智能知识库项目的实践,探讨了企业知识库的真正门槛。指出其不仅是文档存储,更是一套涵盖构建、治理、使用和优化的闭环运行机制。重点分析了知识库与知识空间的区别、知识生命周期管理、可信溯源及权限控制,强调知识库应作为支撑未来 Agent 的企业级 AI 知识引擎。
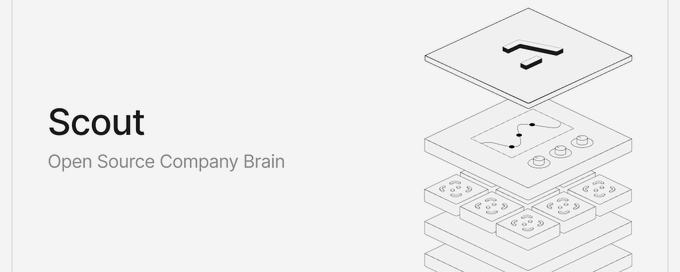
本文介绍了 Scout,一个开源的企业级“上下文代理”(Company Brain)。针对现有方案将所有数据存入向量数据库导致索引过时的问题,Scout 提出了“导航优于搜索”的理念,通过 Context Providers 连接 Slack、Google Drive 等实时数据源,像操作文件系统一样导航信息。它还能动态构建 Wiki 和 CRM,并通过持续学习形成闭环。