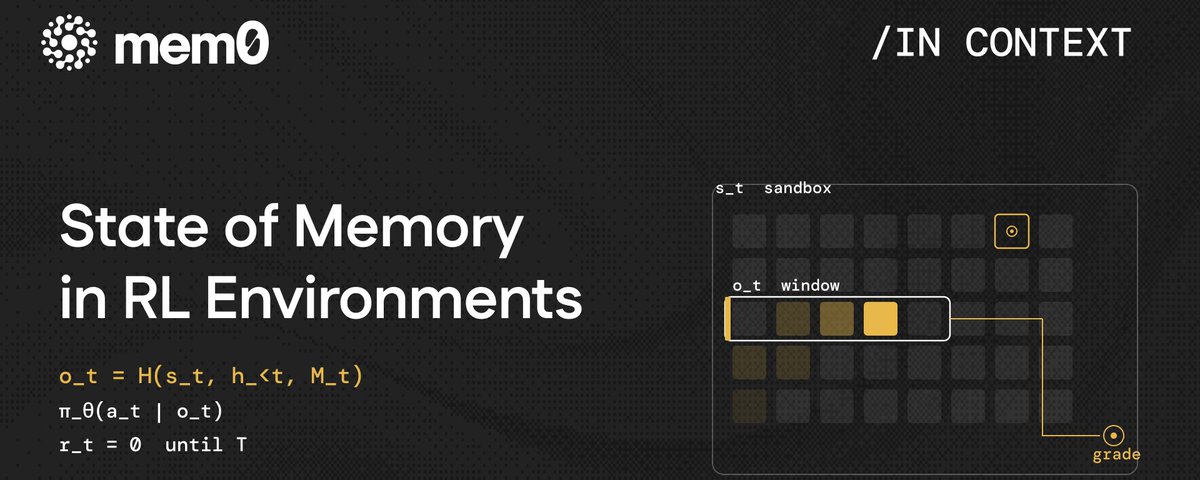
State of Memory in RL Environments
本文探讨了强化学习环境中记忆系统的设计问题。各实验室通过可验证奖励(如测试通过与否)在沙盒环境中训练编码智能体。单个任务往往涉及数百次工具调用,而模型只能看到上下文窗口内的内容,harness 负责决定哪些历史信息进入窗口——这就是记忆系统。文章介绍了 AgeMem、CompactionRL 等研究如何将记忆管理(压缩、检索、写入)纳入策略本身进行训练,并用任务奖励进行评分。Cursor 认为生产环境的 harness 就是训练环境,在数十万并发沙盒中训练 Composer 模型。核心观点是:沙盒保持完整状态,但策略只看到 harness 构建的观察窗口,记忆即跨越这一边界的信息。
