Wiki 知识库

全部文档 / 标签: 上下文窗口

17 篇
清除

从零开始理解上下文压缩

本文译自 Earendil Engineering 的《How Compaction Works in Pi》,讲解编程 Agent(如 Pi、Claude Code、Codex)中的上下文压缩机制。LLM 的上下文窗口有限,随着对话和工具调用不断积累,请求会超出上限。解决方案之一是压缩:用 LLM 生成的摘要替换较早的历史记录,同时原样保留近期消息。文章详细介绍了 Pi 的实现——触发时机(接近上限自动触发或 /compact 手动触发)、token 预算、压缩提示的设计(像一份交接简报,包含目标、进度和关键决定),以及压缩与提示缓存的关系:压缩会打破前缀缓存,导致后续请求需重新计算。

技术 › LLM 小墨同学 2026-10-0515.9 KB 59.9K 217 75

我做 AI 自媒体,一条知识视频到底是怎么做出来的?

作者分享制作 AI 知识视频的完整流程:选题查证、口播稿撰写、演示页面设计、录屏与剪辑。他以《为什么 AI 越用越蠢》为例,讲解如何将上下文窗口等抽象概念拆成 11 个演示页面,并选取其中最难的一段 33.8 秒机制动画,测试 Fotor Video Agent 能否直接生成可编辑的 MG 动画。结果显示该工具能根据口播稿自动生成分镜、旁白、字幕与音乐,并支持局部修改而不重做整条视频,适合放在知识点可视化环节。

技术 › 工具与效率 阿蔺A-Lin 2026-09-0810.6 KB 240.6K 176 75

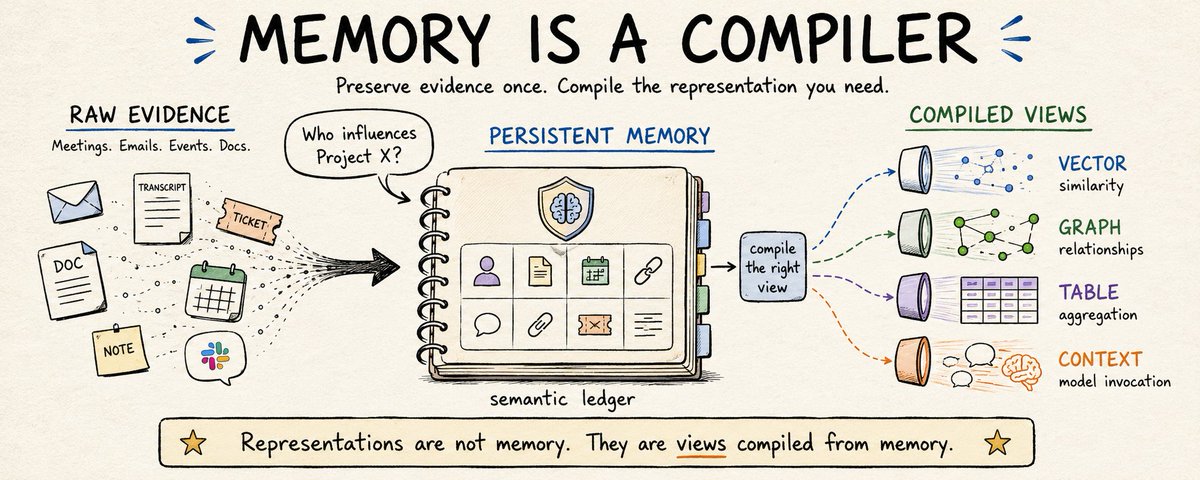
Memory Is a Compiler:记忆是一个编译器

作者通过一次融资会议记忆被重新解读的经历,指出记忆的本质不是固定表示,而是一个持久系统:保留过去的证据,并随新证据不断重新编译其意义。文章批评将向量数据库、知识图谱、上下文窗口等当作记忆的常见误解,认为它们只是从记忆编译出的临时表示。作者提出记忆编译产生三类产物:状态(按序折叠事件得到)、检索(查找相关证据的工具)和上下文(为单次调用组装的有界视图),并类比编译器的中间表示(IR),指出每种表示只适合特定操作,记忆本身应是唯一不可丢弃的持久层。

技术 › LLM Ashwin Gopinath 2026-09-0114.7 KB 9K 109 72

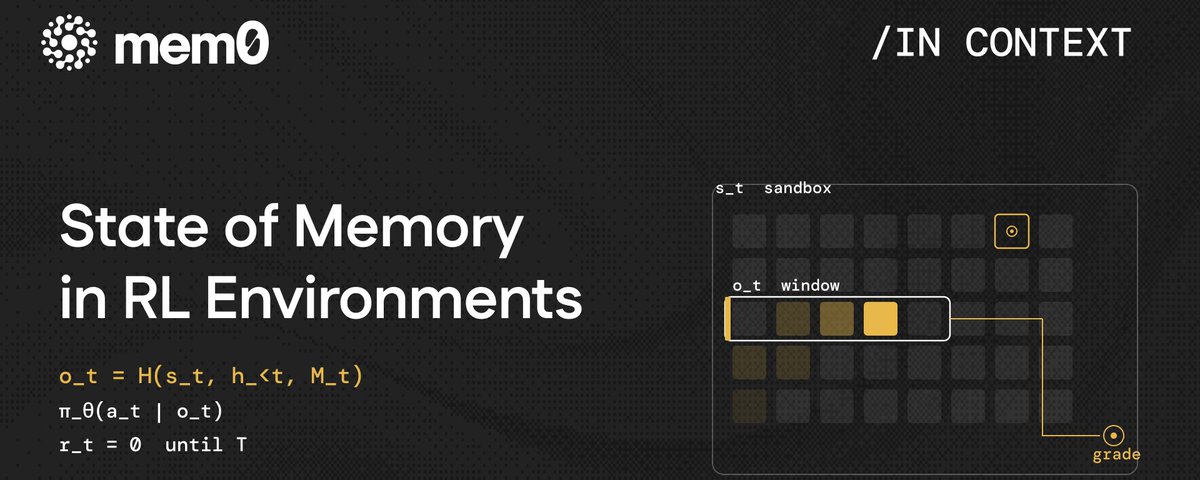
State of Memory in RL Environments

本文探讨了强化学习环境中记忆系统的设计问题。各实验室通过可验证奖励(如测试通过与否)在沙盒环境中训练编码智能体。单个任务往往涉及数百次工具调用,而模型只能看到上下文窗口内的内容,harness 负责决定哪些历史信息进入窗口——这就是记忆系统。文章介绍了 AgeMem、CompactionRL 等研究如何将记忆管理(压缩、检索、写入)纳入策略本身进行训练,并用任务奖励进行评分。Cursor 认为生产环境的 harness 就是训练环境,在数十万并发沙盒中训练 Composer 模型。核心观点是:沙盒保持完整状态,但策略只看到 harness 构建的观察窗口,记忆即跨越这一边界的信息。

技术 › LLM mem0 2026-08-2838.2 KB 10.4K 93 70

如何更高效地使用 Claude 20 美元套餐:基于官方文档的省钱指南

作者逐一核对了 Anthropic 官方帮助中心与开发者文档,验证了网上流传的 Claude Pro 省 token 技巧。文章指出用量消耗取决于消息长度、文件大小、对话长度、工具使用、模型选择等因素,其中对话长度影响最大,因为每条新消息都会重新处理整个上下文。被证实的技巧包括:将多个请求合并到一条消息中发送、利用 Projects 的缓存机制存储参考资料、及时关闭不需要的工具与扩展思考、坚持一个话题一个对话并养成及时开新对话的习惯。文章还澄清了某些流传的所谓文件数量上限并无官方依据。

技术 › Claude Alex Prompter 2026-08-2413.3 KB 17.2K 66 82

Agent 内核拆解(四):Pi 上下文压缩机制详解

本文是 Agent 内核拆解系列第 4 篇,深入分析开源 coding agent pi 的 compaction(上下文压缩)机制。文章介绍了触发压缩的两种条件:context 超过阈值(窗口减去 reserveTokens)和 API 溢出报错,并讲解了溢出恢复流程。压缩时从消息列表末尾回溯找合法切割点(保留最近约 2 万 token 原文),之前的消息用 LLM 按结构化格式(Goal、Progress、Key Decisions 等)总结成摘要,并在末尾追加 <read-files> 和 <modified-files> 文件列表,让模型压缩后仍知道读过、改过哪些文件。文末提供配套可运行代码与实践建议。

技术 › Agent Yanhua 2026-08-218.1 KB 4.4K 40 83

Memory Engineering: The Discipline That Decides Whether Your AI Agent Has a Past

本文探讨了AI代理的记忆工程,指出当前模型虽有完美智能却无记忆,每次会话后如同陌生人。作者批评了依赖扩大上下文窗口的行业做法,提出记忆工程应借鉴人类记忆的架构,通过选择性编码、整合、检索和遗忘来构建独立的记忆系统。文章详细介绍了五阶段流水线:捕获(过滤非持久信息)、整合(去重与合并)、检索(基于相关性提取)、以及后续的更新与遗忘机制,并附有Python代码示例。作者强调,记忆工程是决定AI代理能否拥有连贯过去的关键学科,目前鲜有人正确实践。

技术 › LLM wast3 2026-08-1517.2 KB 775.5K 451 81

Context Windows Are Not Memory: What AI Agent Developers Need to Understand

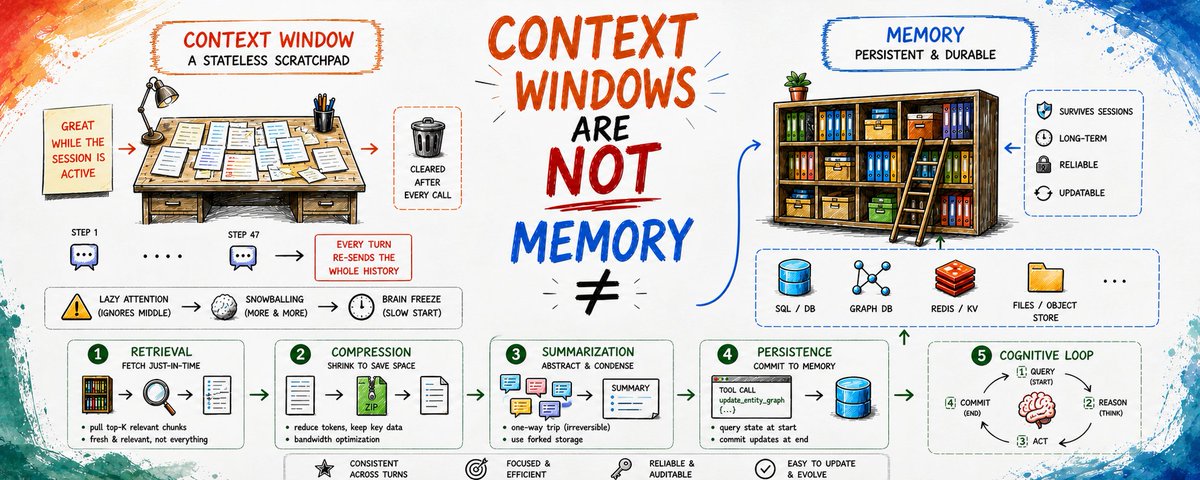
本文深入探讨了AI代理开发中的一个关键误解:大上下文窗口并不等同于记忆。作者通过办公室隐喻,清晰区分了上下文窗口(桌面)、检索(书架)、压缩(ZIP)和摘要(抽象)在代理认知栈中的不同角色。文章指出,模型本质上是无状态的,每次API调用都从零开始,依赖大上下文窗口会导致注意力分散、雪球效应和延迟问题。真正的记忆持久化需要代理扮演数据库管理员的角色,通过检索、压缩和摘要等技术,将原始数据存储在外部存储中,仅将相关信息放入上下文窗口。文章提供了具体的代码示例,展示了如何实现冲突解决和分叉存储模式,为构建可靠的AI代理提供了实用指导。

技术 › LLM beamnxw 2026-08-1510.9 KB 104.3K 119 76

Agent Memory 的下一步:从检索到状态演变

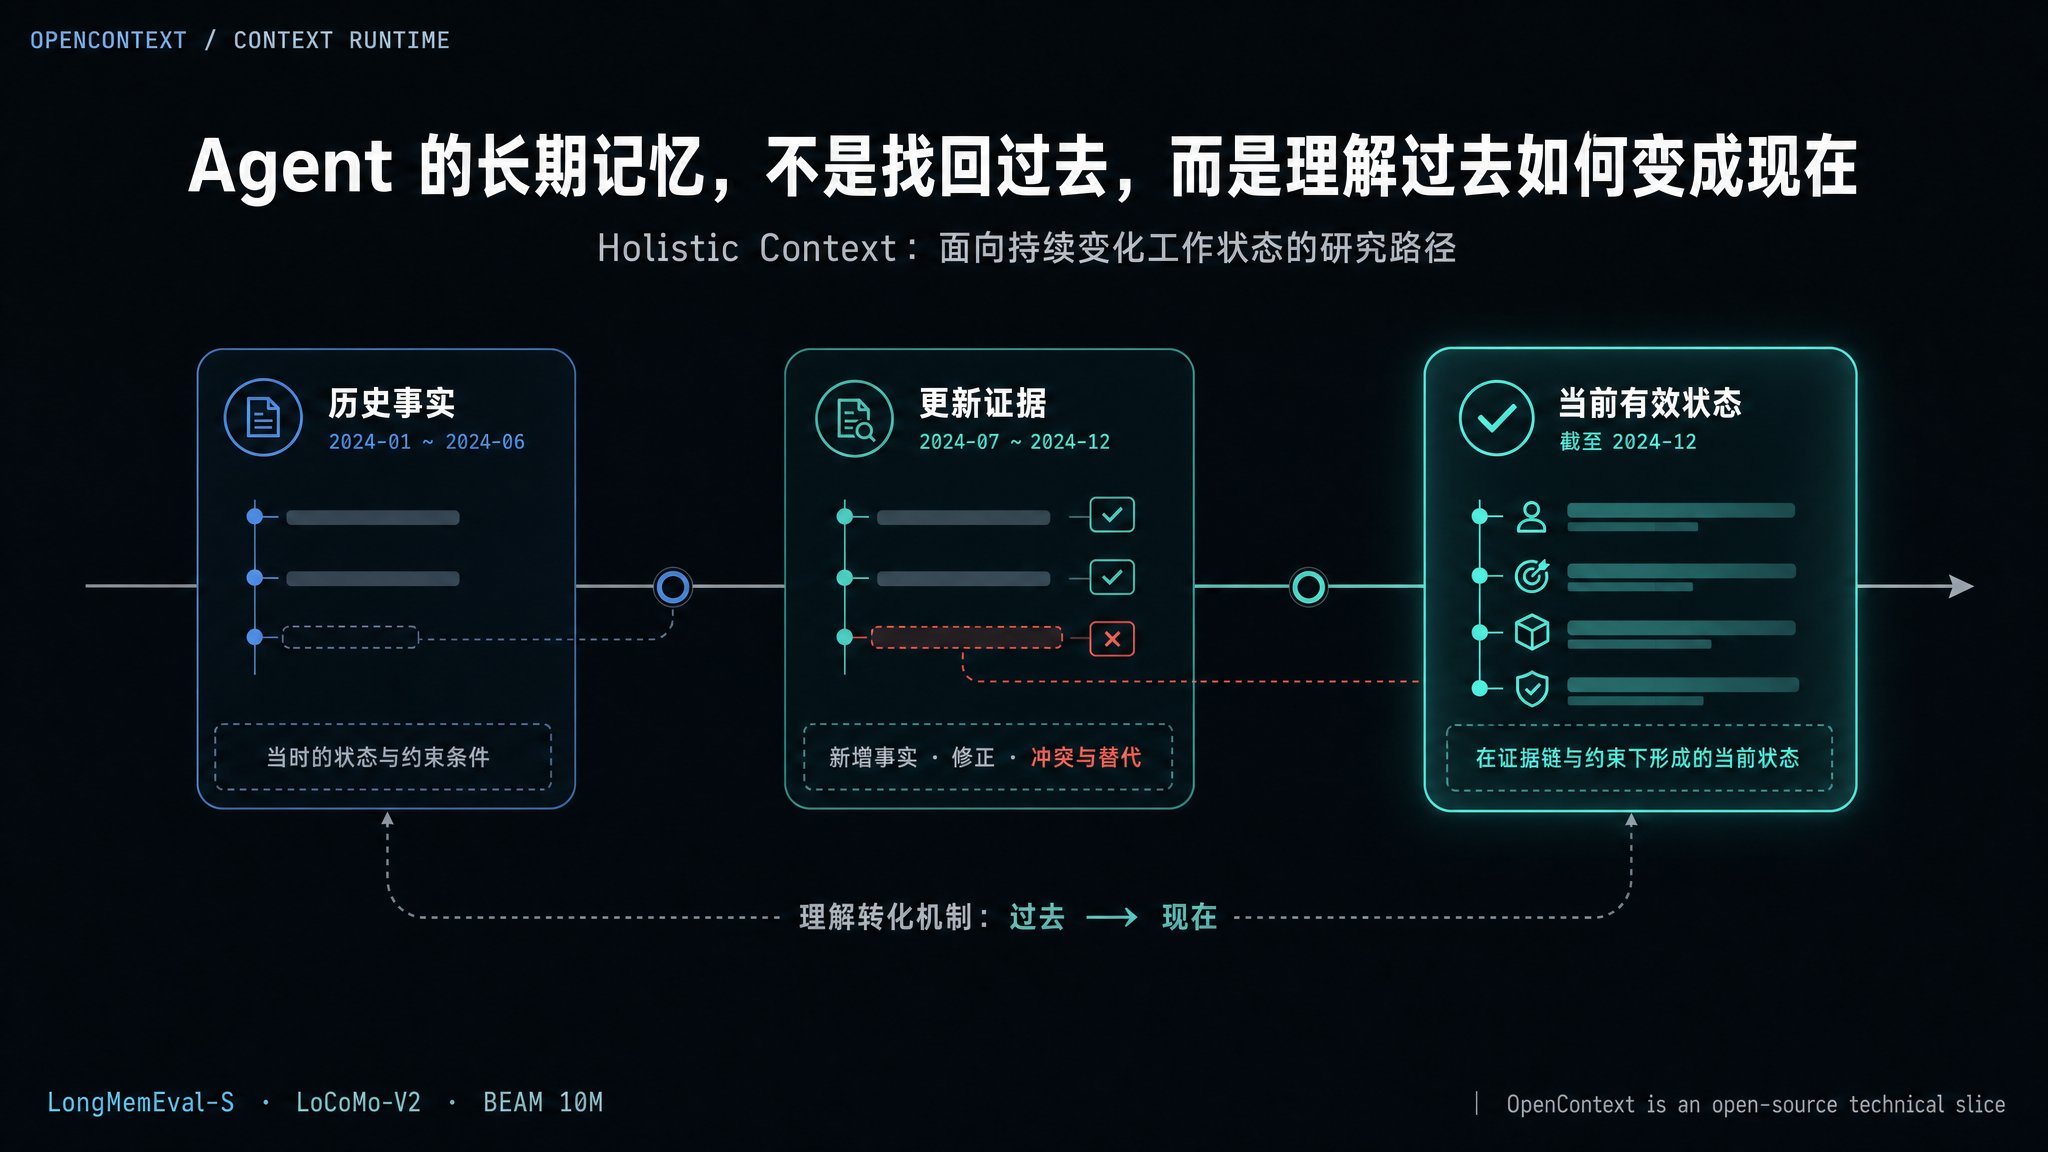
本文探讨了Agent长期记忆的核心问题:不仅仅是找回过去的信息,更要理解信息的时效性和演变过程。作者以Alloomi的Holistic Context研究为例,指出长期Agent面临的关键挑战是判断信息是否仍然有效,以及理解过去如何演变成现在。文章区分了检索回答与长期上下文回答,并介绍了Holistic Context在信息更新、跨时间关系和大规模历史理解方面的研究成果。作者强调,长期Agent的能力不应仅由记忆容量衡量,而应关注其从经验中学习并转化为复杂任务交付的能力。

技术 › LLM MapleShaw 2026-08-1429.2 KB 66

白烧了 5 亿 token 之后,我连夜开源了个给 Codex 和 Claude 做 Skill 搜身的新技巧!

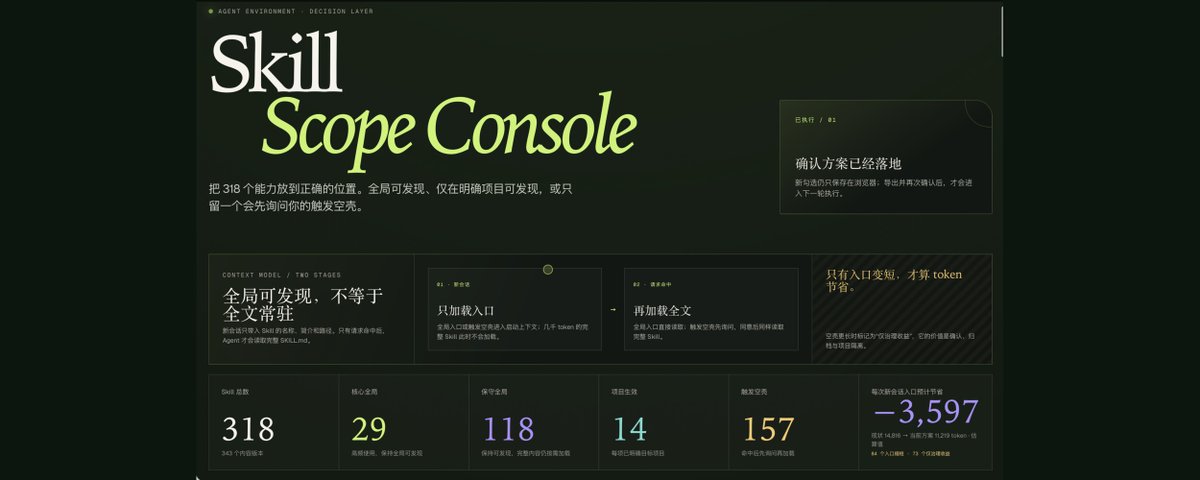
作者因安装 300 多个 Skill 导致每次对话多消耗约 8.2k token,累计浪费数亿 token。为此,他开发了一个“Skill 瘦身”工具和可视化控制台,按使用频率和重要性将 Skill 分为核心全局、项目级和触发级。通过将低频 Skill 改为动态加载,既节省了上下文窗口,又保留了完整能力。

技术 › Skill 卡尔的AI沃茨 2026-08-0611.7 KB 2.6K 4

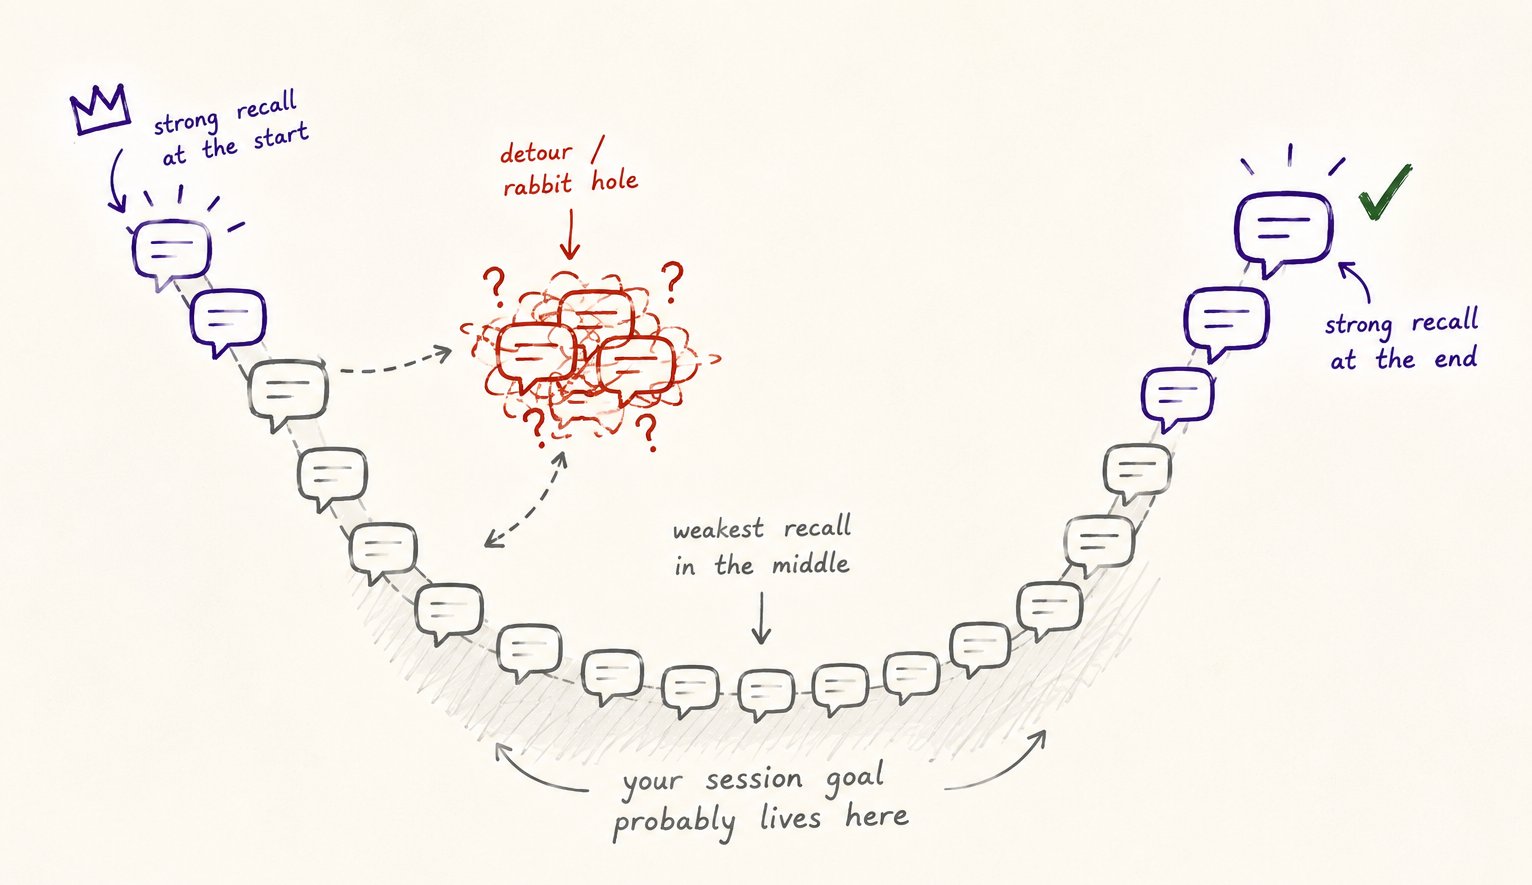
为什么 Claude Code 会话会随时间变差

本文深入探讨了 Claude Code 等智能体工具在长对话中性能下降的现象。作者将其归因于“上下文腐烂”,分为无法避免的内在腐烂(模型架构限制)和可管理的内容腐烂(过时信息积累)。文章提供了具体的治理实践,包括前期策展、保持上下文清洁、及时重置以及使用 git 树结构管理会话,以维持工具的敏锐度。

技术 › Claude Code yibie 2026-08-0317.3 KB

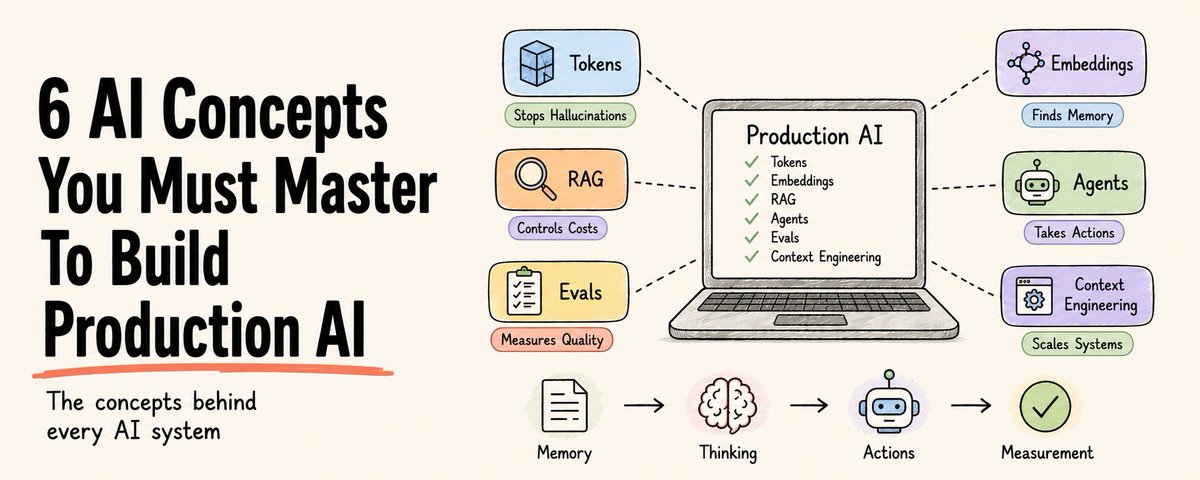
构建生产级 AI 系统必须掌握的 6 个核心概念

本文由作者因遭遇 AI 智能体失控产生高昂费用的经历引出,旨在阐述构建生产级 AI 系统必须掌握的核心概念。文章提出了 AI 系统的通用公式:记忆(RAG)+ 思考(LLM + Tokens)+ 行动(Agents)+ 测量(Evals)。文中重点解析了 Tokens 与上下文窗口的成本与限制、嵌入向量与语义搜索的原理、RAG 检索增强生成的正确姿势、智能体循环中的工具使用与停止条件等关键技术细节,帮助开发者从“调参侠”进阶为真正的 AI 工程师。

技术 › LLM Rahul 2026-06-1930.7 KB 509.9K 334

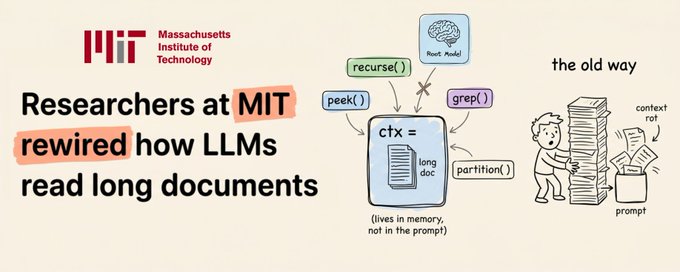
Recursive Language Models (RLMs) 清晰解释:解决大模型长上下文推理难题

文章介绍了一种称为递归语言模型(RLMs)的新方案,旨在解决大语言模型在处理超长上下文时出现的“上下文腐烂”问题。RLMs 不再将上下文限制在单一 Prompt 中,而是将其视为外部数据,通过赋予模型窥探、正则匹配、分区和递归调用等工具,让模型自主决定如何分解和处理任务。这种方法不仅消除了上下文长度对推理能力的影响,还提高了准确性和成本效率。

技术 › LLM Akshay 2026-04-2812.6 KB 131.6K 441 68

The Context Engineering Playbook: 15 Copy-Paste Templates That Make Any AI 10x Smarter

文章提出了“上下文工程”的概念,认为它比单纯的提示词工程更能决定 AI 的输出质量。作者将 LLM 比作 CPU,将上下文窗口比作 RAM,而用户则是操作系统。文章提供了 15 个可直接复制粘贴的实用模板,分为身份设定、任务指令和上下文控制三个部分,旨在帮助用户通过预设背景、品牌语调和工作规则,无需代码即可显著提升 ChatGPT、Claude 等模型的输出质量。

技术 › AI Nav Toor 2026-04-0837.8 KB 31.1K 350 81

10万开发者调查证实AI写的代码大部分是垃圾,这个Harness Engineering方法论把产出质量拉高了3倍

本文介绍了 HumanLayer 创始人 Dex Horthy 提出的“Harness Engineering”方法论,旨在解决 AI 编码 Agent 在复杂代码库中产出质量差的问题。核心观点包括:上下文窗口管理是关键(区分“聪明区”与“笨蛋区”),通过 Research-Plan-Implement (RPI) 流程压缩意图,以及利用子 Agent 进行上下文控制而非角色扮演。文章强调要审查计划而非代码,避免外包思考,并指出未来的挑战在于团队流程的适应。

技术 › Harness Engineering Jason Zhu 2026-04-059.7 KB 6.9K 54 88

Agent 记忆:一篇讲透,小白也能看懂

文章以通俗易懂的比喻,深入浅出地讲解了 AI Agent 的记忆机制。通过对比 OpenClaw 社区的三种记忆方案(扔掉旧笔记的压缩方案、分层档案馆方案、以及 MemOS 按需检索方案),揭示了如何解决 AI“健忘”的问题。重点介绍了 MemOS 如何通过全量记录、按需检索和技能进化,大幅降低 Token 消耗并提升开发效率。

技术 › Agent 泊舟 2026-04-0110.2 KB 36.5K 147 84

AI的记忆困境:当OpenClaw开始“遗忘”你的秘密

文章深入探讨了 2026 年 AI 在企业应用中面临的关键“记忆困境”。分析了 AI 因上下文窗口限制导致的“遗忘”现象、被遗忘数据的隐私流向风险,以及不同模型在处理长期记忆时的偏差。文章还介绍了信任评分机制、AI 记忆的分层架构(短期、长期、情节记忆),并针对 OpenClaw 等系统提出了具体的内存故障解决方案与风险治理策略,强调了在 AI 时代重建数据透明度与信任的重要性。

技术 › Agent Jason Zhu 2026-02-2217.3 KB 81