Wiki 知识库

全部文档 / 标签: 复现

3 篇
清除

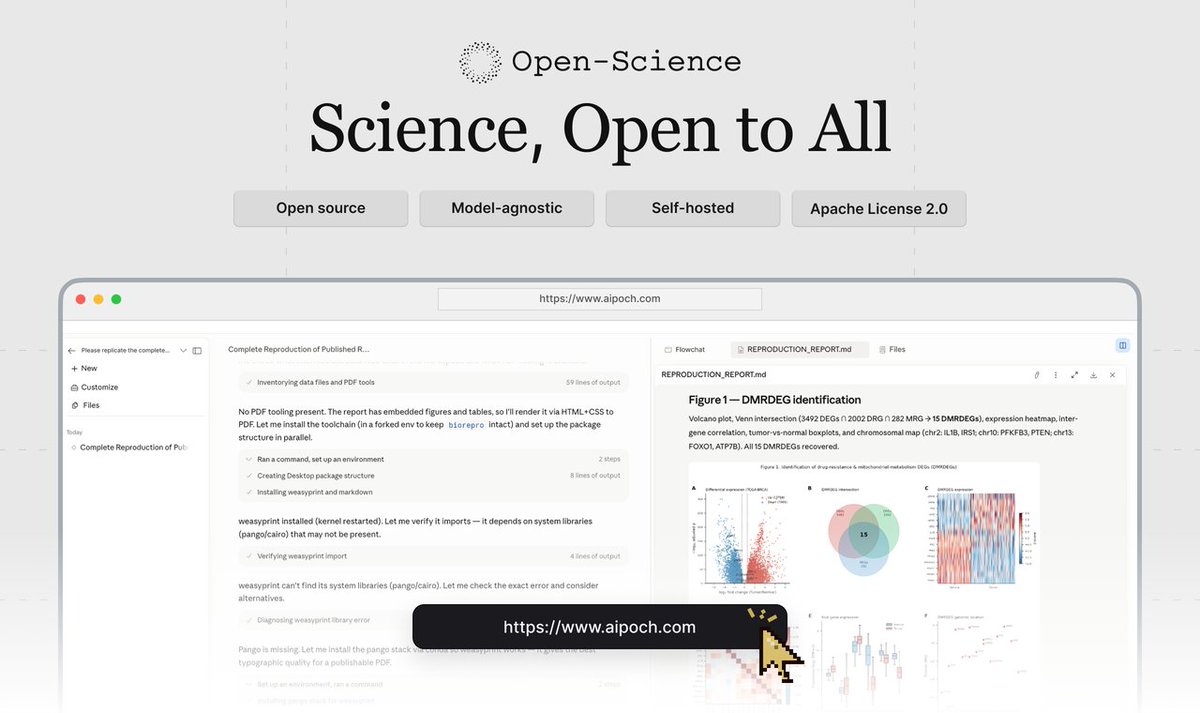
想入门 AI 领域的极佳方式就是大量翻阅论文——Open-Science 科研工作台推荐

作者认为大量阅读 AI 论文是入门 AI 领域的极佳方式,并以朋友韭二老师爆肝 60 篇论文后入职盛大 evermind 为例。同时指出在 X 上分发论文解读是一种起号方式,该赛道仍有空白。针对论文小白,作者推荐一体化 AI 科研工作台 Open-Science:内置科研 skills 的 Agent 可检索文献、梳理方法并输出报告;支持灵活接入 Codex、Claude 等模型;研究过程可回溯审核;支持动手复现论文计算与分析。复现 5 篇以上即可深入掌握 AI 领域知识,项目已开源。
技术 › Agent Sac (@Saccc_c) 2026-10-172.9 KB 47

我们复现了那个决策模型教程

作者复现 Nish Tahir 的《Build your own decision model》教程,在 CommonsenseQA 上验证基于语言模型单次前向读取选项 token 概率作为置信度的决策模型方法。复现发现教程方法成立但需补两个关键前提:读数位置必须放在 assistant 轮,模型需用 8B 而非 1.7B。温度缩放校准有效,而微调增益主要来自修正 harness。作者还将方法应用于素材席位判定任务,发现模型间一致标签不等于准确率,结论需以人工标签为准。核心启示:核对读数位置的概率质量、报告覆盖率、用独立数据拟合温度。

技术 › LLM yibie 2026-10-128.2 KB 1K 4 85

一次独立复现:CLM 的 DeepSWE 数字能跑出来,但它不是平均值

作者对开源项目 CLM(Contrastive Language Models)声称的 DeepSWE 81.6% SOTA 成绩进行了独立复现。通过三重验证(常数分数测试、用作者自带分数复算、checkpoint 哈希校验),确认 fold1 的 81.579% 可精确复现。但深入分析发现,该项目采用三折交叉验证,公布的数字是最优折,三折平均仅为 78.66%,跨度达 19 个百分点,fold2 甚至低于随机基线(主要因小样本高方差)。文章还验证了 CLM 训练成本低(纯 CPU 分钟级)、编码器可在 macOS 上运行、预训练头在 1000 条数据以内有效等结论,并指出 README 中复现命令路径失效、评估脚本未公开等问题。

技术 › LLM yibie 2026-09-2710.7 KB 1.2K 2 86