Wiki 知识库

全部文档 / 标签: Qwen3

6 篇
清除

现在普通人也能从零训练一个 Reasoning Model 了

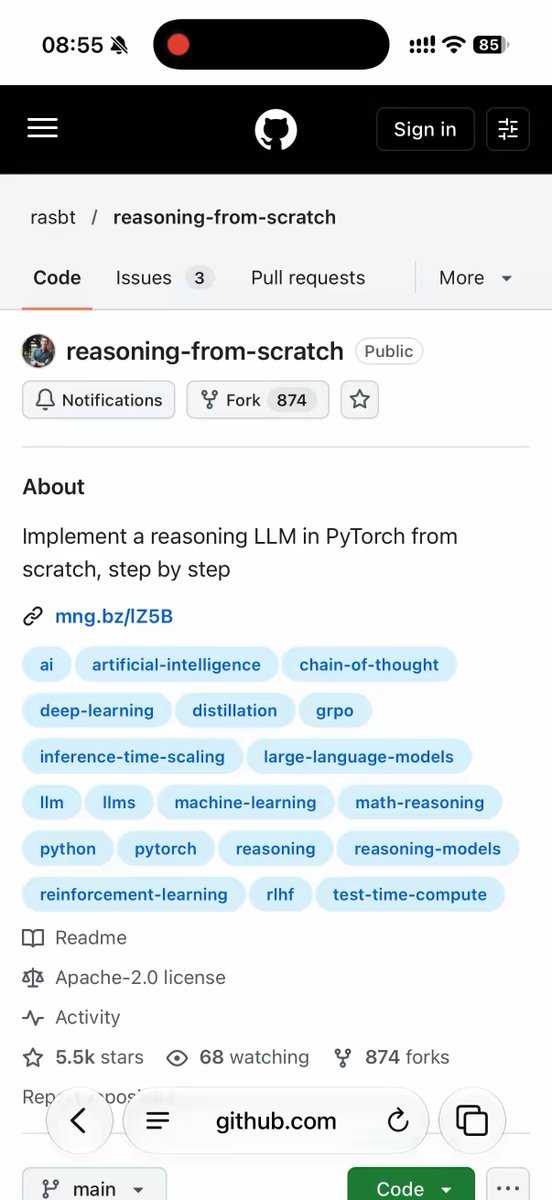
Sebastian Raschka 公开了一套完整课程《Building Reasoning Models from the Ground Up》,包含 8 节视频、11+ 小时内容,基于 Qwen3 0.6B 小模型,用 Python + PyTorch 实现现代推理模型的关键技术,包括 Inference-Time Scaling、Verifier、GRPO 强化学习、KL/Clipping 训练稳定性控制、Reward Hacking 以及基于 DeepSeek-R1 数据的推理蒸馏。课程让学习者可以亲手运行训练循环,观察模型生成推理路径、根据奖励更新参数的全过程,大幅降低了理解推理模型的门槛,使推理模型训练从少数实验室技术变为可动手验证的工程知识。

技术 › LLM lifcc (@mylifcc) 2026-10-261.9 KB 73

Sebastian Raschka 免费视频课:从零构建推理模型

《从零构建大模型》作者 Sebastian Raschka 推出 8 集共 11 小时的免费视频课,配合新书《从零构建推理模型》,教你用 PyTorch 基于 Qwen3 0.6B 从零实现推理模型。课程内容涵盖 KV cache、数学答案验证器、self-consistency 多数投票、自我修正、简化版 GRPO(RLVR)训练、reward hacking 以及 DeepSeek R1 蒸馏。前几集 CPU 或 Mac Apple 芯片即可运行,只需会 Python 和 PyTorch 即可直接学习。视频与代码仓库均已开源。

技术 › LLM 耳朵 (@RookieRicardoR) 2026-10-252.5 KB 70

我们复现了那个决策模型教程

作者复现 Nish Tahir 的《Build your own decision model》教程,在 CommonsenseQA 上验证基于语言模型单次前向读取选项 token 概率作为置信度的决策模型方法。复现发现教程方法成立但需补两个关键前提:读数位置必须放在 assistant 轮,模型需用 8B 而非 1.7B。温度缩放校准有效,而微调增益主要来自修正 harness。作者还将方法应用于素材席位判定任务,发现模型间一致标签不等于准确率,结论需以人工标签为准。核心启示:核对读数位置的概率质量、报告覆盖率、用独立数据拟合温度。

技术 › LLM yibie 2026-10-128.2 KB 1K 4 85

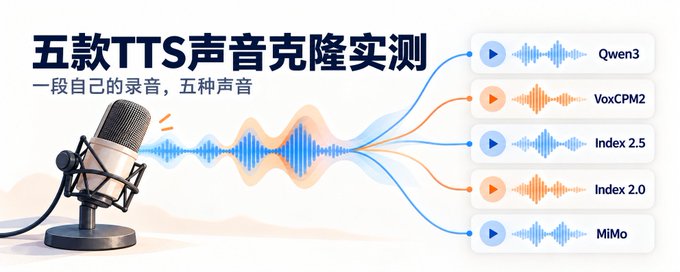
用自己的声音做配音,5款TTS实测后我会怎么选

作者用24秒自己的录音实测了Qwen3、VoxCPM2、Index 2.5、Index 2.0和小米MiMo五款TTS工具的语音克隆效果。每款读取相同两篇文案,从音色相似度、语气控制、生成耗时等维度对比。结果显示VoxCPM2和Index 2.0效果最好,是本地方案的首选;Qwen3可用但调节空间有限;小米MiMo通过API云端生成,适合不想本地部署的用户。文章还详细介绍了各工具的界面功能和在RTX 4070 Ti SUPER上的实际等待时间。

技术 › TTS 风渡fengdu 2026-10-118.2 KB 24.6K 278 82

10款值得在本地运行的开源AI工具

文章介绍了10款免费开源、可在本地运行的AI工具,涵盖从模型引擎到日常应用的完整技术栈:llama.cpp作为本地推理引擎,Qwen3作为开源模型,AnythingLLM提供本地知识库聊天,whisper.cpp实现本地语音转文字,Kokoro-82M负责文本转语音,Immich用于自托管照片管理,Tabby提供本地代码补全,ComfyUI支持本地图像生成,Activepieces实现自动化工作流。每个工具均通过免费开源、本地运行、持续更新、有公开证据四项筛选标准,帮助用户摆脱云端订阅和数据外流。

技术 › 工具与效率 Alex Veremeyenko 2026-08-2510.5 KB 8.8K 23 78

穷鬼玩 Agent 的配置

文章分享了低成本搭建 Agent 的技术配置方案。主要利用商汤、硅基流动等平台的免费额度,集成了 DeepSeek V4 作为主模型,Qwen3 系列处理视觉与工具任务,并结合多个免费或薅羊毛的图像、视频及大模型资源(如 GLM5.1, Claude Opus 4.6 等)来应对不同场景,实现了一套零成本或极低成本的复杂 Agent 工作流。

技术 › Agent K Kafka 2026-06-291006 B