教你用AI创作绘本、动画和互动课件
本文介绍了腾讯出品的AI趣味学习社区“懂了鸭”,一款面向青少儿成长、融合趣味学习与AI创作的内容平台。作者实测演示了其四大核心功能:生成闯关小游戏、做动画、做绘本和制作动态课件,并详细说明了知识树分类、作品改编、模型选择(Deepseek、混元、GLM等)以及积分消耗情况。平台目前处于邀请内测阶段,注册即送积分,适合家长和教师为孩子快速创作AI教育内容。
本文介绍了腾讯出品的AI趣味学习社区“懂了鸭”,一款面向青少儿成长、融合趣味学习与AI创作的内容平台。作者实测演示了其四大核心功能:生成闯关小游戏、做动画、做绘本和制作动态课件,并详细说明了知识树分类、作品改编、模型选择(Deepseek、混元、GLM等)以及积分消耗情况。平台目前处于邀请内测阶段,注册即送积分,适合家长和教师为孩子快速创作AI教育内容。
作者在 Opus 5.5 发布后实测“一句话生成动画”的真实效果,从 5 秒片名卡做到 195 秒讲解动画,共完成 5 部作品。结论是:一句话确实能生成好看的内容,但成功区间很窄——只有短、内容自由、无标准答案的片名卡一次通过。片子一长、内容一定,就出现牙齿数量错误、画面冻结、占位文字残留等细节问题,需借助独立 AI 审查与人工把关。作者总结:意图与感知只能由人提供,并给出开工前给齐决定、先看抽帧拼图、另开 AI 审查、反馈带时间码、沉淀素材五条实践建议。
作者分享了使用 EverOS Cloud 为 AI Agent 构建记忆层的实测体验。他通过自动生成 X 引用帖配图的工作流,总结了生图提示词敏感词、图片压缩、后台任务管理等踩坑经验。EverOS Cloud 能将 Agent 的任务过程存为 Case,自动提炼出可复用的 Skill(如「生成合规图像并添加水印」SOP),支持中英文混合检索(不到100毫秒)、业务资料接入、API 轻量集成、可视化管理记忆,并提供云端与开源自托管两种部署方式。作者认为,Agent 没有记忆就像每天重新带的实习生,能把经验攒下来才能成为靠谱的老员工,对一人公司尤其有价值。
作者实测使用OpenCode搭配DeepSeek V4.1 Flash模型,通过一段完整提示词直接生成了一段22秒的智能手表产品动效视频。提示词详细规定了画面风格(电光蓝配白)、分镜节奏、动效与配乐要求。整个生成过程耗时近5个小时,作者评价效果尚可但生成时间极长,并在回复中表示'OpenCode拉完了',认为其表现不佳。文中还公开了完整的三段式提示词供他人复刻。
作者将 OpenCode Go 和 Command Code GOAT 两个 10 美元/月的套餐接入自己的 Sub2API 网关,基于 64,648 条使用记录和小规模质量测试进行实测对比。两者月额度均为 80 美元,OpenCode 短时额度更大(5 小时 16 美元、周 40 美元),GOAT 为 14/35 美元。在相近规模流式请求中 GOAT 耗时中位数和 P95 更短,400 错误也显著更少。结论:接自己的 Agent 或通用 API 客户端优先 GOAT;用于兼容的 coding agent 且集中跑任务则选 OpenCode Go。文章还讨论了处理费、高峰定价、参数兼容问题和模型是否量化等细节。
作者分享了在 AI 视频创作中使用 EverOS Cloud 记忆层的实测体验。通过将三条旧项目的创作经验(任务目标、修改理由、最终取舍)整理成卡片存入记忆库,Agent 在接到新 Brief 时先检索相关经验再写提纲。对照实验显示,检索分数最高的预告片经验仅作背景,真正被采用的是排第三的香氛修改卡,其'修改要求落到具体位置、比例和留白'的判断被融入提纲。但也发现旧经验可能带偏任务目标,需人工把关。作者结论:旧经验能借的是判断方法,最终取舍仍由人决定。
Google 发布新一代旗舰模型 Gemini 4 Argon,主打复杂长流程任务的深度推理,输出 token 上限达 100 万,行业第一。官方跑分 19 项中拿下 14 项第一,第三方测试显示其幻觉率全场最低(15%),且成本仅为 GPT-6 Astra 的六成。作者通过两个实测案例进行对比:俄罗斯方块游戏中 Argon 5 分钟一次写完 4.7 万字符代码,速度是 Astra 的两倍多,验证了长输出能力;但番茄钟前端设计对比中,Argon 功能完整却设计粗糙并有 UI bug,验证了其前端偏弱的爆料。结论:Argon 硬实力强、长代码能力实锤,但前端精细活不是主场。
作者实测了 AICodeMirror 中转站配合 CC Switch 在国内使用 Claude Code 的体验。通过两个硬核任务验证:一句提示词生成 3D 鹈鹕踩单车动画,以及将开源项目 Pi Agent Desktop 的核心依赖跨大版本升级并成功合并 PR。结果显示 AICodeMirror 接入的是正宗 Claude Sonnet,速度达 60-70 token/s,价格约为官方 4.2 折,且连接稳定无断流。配合 CC Switch 可三分钟完成配置,新用户还送 8 元体验金。
本文介绍了DeepSeek Harness平台上的DeepSeek Bot插件,作为Grok Bot的替代方案。DeepSeek Bot支持多Bot多智能体团队协作,每个Bot可设置角色、模型和长期记忆,默认由Chief主管分派任务。文章详细讲解了安装部署、配置Chief、组建Bot团队及建群讨论的实操过程,并指出其门槛低、适合普通用户体验Agent玩法。
作者在 Teamily AI 平台上组建了一个包含三个 AI 成员和一位人类伙伴的群组,实测多 Agent 协作能力:为尚未上线的 AI 编程课制作宣传页。文章总结了多 Agent 系统易犯的三类错误(错误传递、交接丢条件、缺乏验收),并设定三个观察点:分工是否清晰、改动能否传递、交付前有无审核。实测中 AI 团队展现了组队排任务、接住反馈、按事实调整的能力,但作者强调业务前提(如课程未上线)仍需人来把关,审核报告也需追问核实依据。最终交付了可分享的宣传页 Demo,作者收获是学会了如何给 AI 团队提需求。
作者分享了通过 Northwest Registered Agent 免费注册 .com 域名的实测经历。该服务商首个域名免费(最高支持 $25),提供免费 WHOIS 隐私保护,官方称域名留在其平台则续费免费。作者实测 8 天后确认域名正常解析、可修改 Nameserver,并成功接入 Cloudflare 托管 DNS 和 CDN。使用 Gmail 注册账号、Kraken 英国卡付款完成流程。文章提醒后台仍显示续费 $15.99,明年能否继续免费尚不确定。
作者实测分享通过 Airtap 远程浏览器注册 Muse AI(一款热门 Personal Agent 产品)的完整教程。流程为:用 Google 账号登录 Airtap,发送提示词让 AI 浏览器打开 muse.ai 注册页面,依次完成 Google 邮箱验证、基本信息填写和信用卡验证(作者使用招行国际信用卡),全程约5分钟秒过。文章特别提醒新用户需在注册后48小时内到 设置→通用→兑现推荐码 处兑换推荐码 KYCT0I,可领取10亿 Muse 词元奖励。作者指出注册对环境有要求,直接访问易卡住,该方法适合此前注册失败的用户。
作者的 Claude Max 20X 账号被封后,因无外币卡、虚拟卡易被风控而难以重新订阅,于是实测了 Sukai 平台的成品号购买与代充服务。文章详细记录了用 OKX Web3 钱包通过 USDT(推荐 TRC20)链上充值、下单 Claude 成品号、等待交付与登录验证的全流程。实测中缺货预订 12 分钟获人工确认,不到 3 小时完成交付,账号含 2FA 和 Session 可完全接管,但需配置固定代理 IP 才能登录。代充方面 GPT Plus $17/月、Pro 20x $150/月,低于官方价。文章同时提醒封号不在质保范围、建议小额试水等风险,并附赠 OKX 闲置 USDT 生息的小技巧。
作者实测了 Manus 推出的多 Agent 产品 Cue。Cue 允许用户创建多个 Agent,为它们分配邮箱、电话号码、钱包和桌面,Agent 之间可以单独传话或组群聊协作。文章详细体验了创建 Agent、查看独立桌面、设置自动化任务、邮箱收信、电话与支付等功能。作者发现邮箱需要手动提醒、收信不稳定,电话和支付仅限部分地区,连接器以国外服务为主。总体评价 Cue 方向与 Grok Bot 相似但仍是'毛坯房',基础体验有待完善,更看好其 Skills 和连接器的发展潜力。文末附邀请码 MEETCUE。
作者通过六天44项实际任务,实测Muse Agent的能力,回应外界质疑。文章记录了Muse接入Gmail、GitHub、腾讯文档、自建MCP服务等11个真实系统的过程,并产出9篇文档、9支视觉视频(含宣传片与讲解视频)、完成6场深夜排障、建立5项自动化提醒。作者强调HUMAN IN THE LOOP原则:花钱、发布、删除等有后果的操作必须经人确认。核心观点是:Agent的能力上限取决于它能接入多少真实系统,而真正的上限在于用户的想象力与实践力,Agent的价值在于用证据干活、错了就认。
作者对开源项目 CLM(Contrastive Language Models)声称的 DeepSWE 81.6% SOTA 成绩进行了独立复现。通过三重验证(常数分数测试、用作者自带分数复算、checkpoint 哈希校验),确认 fold1 的 81.579% 可精确复现。但深入分析发现,该项目采用三折交叉验证,公布的数字是最优折,三折平均仅为 78.66%,跨度达 19 个百分点,fold2 甚至低于随机基线(主要因小样本高方差)。文章还验证了 CLM 训练成本低(纯 CPU 分钟级)、编码器可在 macOS 上运行、预训练头在 1000 条数据以内有效等结论,并指出 README 中复现命令路径失效、评估脚本未公开等问题。
本文实测了 TypeSafe AI 发布的不生成文本的 AI 模型 Jev 在 RAG 检索流程中的效果。作者在重排、回答判断、检索前置门卫三个环节插入 Jev 进行验证:重排方面,Jev 以八分之一的成本达到接近 Cohere Rerank 的精度;在调用 LLM 之前用 Jev 判断「无法回答」,响应速度提升 5.6 倍,成本降至二十七分之一;在检索之前拦掉范围外提问,速度提升 7.4 倍,成本降至七十五分之一。此外,Jev 还能一次请求同时完成重排和回答判断。结论是用 Jev 改善 RAG 速度与成本可行,但需慎重设定阈值,避免误拦可回答问题。
作者用两周时间在编程、销售、财务、客服、法务和电商等场景中实测 GPT-6 Astra。核心发现:传统自动化在可预测输入下仍最优,而 Astra 适合需要判断力的“混乱中间地带”;它能操作从未见过的软件界面(如 CRM、后台系统);作为编码 Agent 可定位并修复真实 bug 并补测试;能端到端完成销售准备、竞品分析和财务数据处理等完整工作流。作者建议拆分成多个窄领域 Agent 使用,并从现有工作流出发而非凭空构建场景。
作者实测了 Meta 的 Muse——一个运行在 Secure VM 中的个人 AI Agent。文章介绍了其界面结构(Chat、Feed、Ideas、Goals、Library、Settings),讲解了 Library 中 Media、Artifacts、上传文件三者的区别,演示了生成 HTML Artifact、上传文件读取和短视频生成。还重点说明了定时任务与 Polls 的轮询机制、Connectors 的能力开关与 Google OAuth 登录的区别、Secure store 的安全模型,以及购物需逐单审批的限制。结论认为 Muse 适合作为云端个人助理,浏览器+Connectors+审批机制是其核心优势。
作者在做剧时遇到参考图迁移提示词难写的问题,通过大量跑图试验,总结出一句简短提示词模板:「将图一的【对应维度】迁移到图二,保持图二的主体身份与主要内容」。他将图片风格拆解为17个维度(光线调色、成像质感、摄影空间、造型媒介四大类),逐项单独测试迁移效果,记录每项的收获与代价。结论是:短提示词写起来快、能直接感知画面变化,虽可能需要两三轮迭代,但相比AI生成的复杂长提示词效果偏差不大,且维度可灵活混合叠加使用。
文章实测了 xAI 与 Cursor 团队联合推出的新产品 GrokBot。作者将市面 Agent 分为三类:闭源桌面办公 Agent、开源系统级 Agent、IDE/终端编码 Agent,指出 GrokBot 属于全新的 Bot 驱动形态——它是'数字员工'而非工具箱,每个 Bot 对应一个领域职责,拥有极强的电脑操控能力,本机不在线时可在云电脑上 7×24 运行。实测中,GrokBot 完成了写公众号文章、配图排版、操作浏览器插件存入草稿箱等全流程任务,并支持多端同步与多 Bot 协作。作者认为其设计更简单、运行更稳定、能力更强,已初具'贾维斯'的样子,预示移动办公是未来。
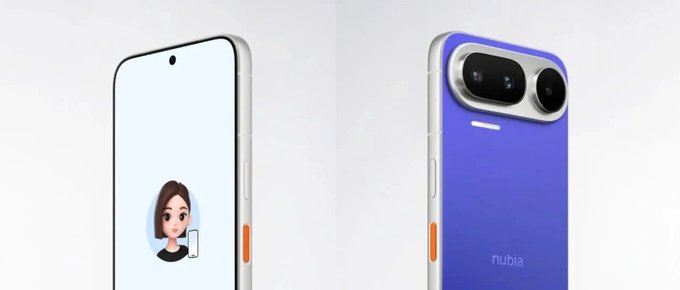
搭载豆包手机助手消费者版本的努比亚NaviX Ultra正式发布开售。作者提前拿到真机并实测:AI键首次加入指纹鉴权,保护隐私安全;复杂长程任务能力提升,可一次性完成飞书报销等流程,并支持任务排队与插队;记忆功能大幅升级,可记住用户偏好并自动执行重复任务;支持把跑通的流程保存为快捷指令;能理解屏幕内容直接干活;系统级应用如相机、录音接入更多AI能力。文章同时指出免费额度有限及生态支持受限等不足。
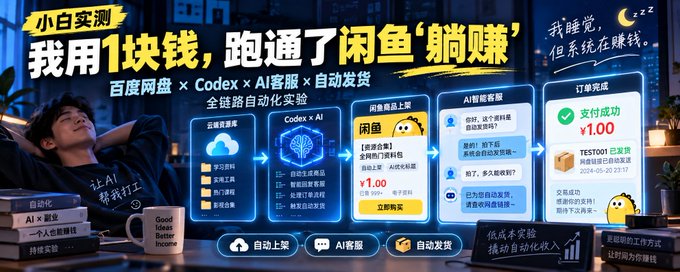
作者锦鲤以小白视角实测闲鱼自动化副业,利用百度网盘、Codex和闲鱼MCP搭建从选品、上架到客服、自动发货的流水线。通过两次实操,验证了商品草稿生成、关键词自动回复及1元测试订单自动发货链路。文章强调自动化只能替代重复劳动,不能替代生意判断,并提醒注意版权、账号安全与平台风控,适合自有合法数字产品的小范围测试。
作者实测让 ChatGPT 的 Astra(电脑操作 Agent)自动通关游戏《羊了个羊》。在『轻度』模式下,Astra 花约 40 分钟通关,仅用了一次道具,但 5 小时额度耗尽,靠赠送的重置额度才完成。文中总结了 Astra 的工作原理:先做规划,再通过截图识别、OCR、Playwright 等工具分析执行,最后统一思考、批量操作,从而控制成本,这也解释了 OpenAI 采购大量 Mac mini 的原因。作者还提醒并发操作可能触发微信风控,并分享了其 AI 公众号。
作者以电商从业者视角实测 OpenAI 新发布的生图模型 Image 2.5,通过六个真实场景测试:主体换场景、连续四轮局部修改、跨境电商产品图、复杂中文海报、Sketch 草图生图等。结果显示新模型在参考图主体保留、局部精确修改、多轮编辑稳定性和中文文字控制上均有明显提升,生成延迟最多降低 50%。作者认为 AI 生图的竞争正从“能否生成漂亮图片”转向“能否把图片稳定地改到可用”,Prompt 依赖降低,普通人借助 Sketch 等功能更容易表达创意。
OpenAI 发布 GPT-Image 2.5,包含 Flare 和 Sunburst 两款模型,生成延迟最高降低 50%,局部编辑更精准,新增 Sketch 手绘、图片批注和模板功能。作者通过连续修改桌面图、透明背景导出、草图转效果图、中文信息图定点编辑和 Poster 模板五个实测,验证了多轮编辑稳定性、透明通道真实性、草图布局还原、文字修改准确性和模板引导流程。结果显示 2.5 能跑通小步精修流程,但未修改区域仍会轻微重绘,像素级精确编辑仍需专业工具。
OpenAI 发布 ChatGPT Images 2.5,对图像生成能力全面升级。核心改进包括速度更快、画面更逼真、编辑与微调更精准。新增 Sketch 功能,用户可直接在 ChatGPT 中绘制草图,由模型生成完整图像,还支持将简笔画转为艺术风格、Logo 或 3D 黏土风格。生图过程新增进度条,光照与纹理更自然,并提供自由画布选风格、海报商品图模板、照片一键合成、图上标注编辑等功能。同时推出 GPT-Image-2.5 Flare 和 Sunburst 两个新模型,向所有 ChatGPT、Work 和 Codex 用户开放。
作者陈硕实测 GPT-6 Astra 一整天,通过 30-45 分钟制作可跑的 3D 游戏 Demo,验证了其核心能力。文章总结了 GPT-6 的四大升级:Computer Use 真正执行操作、异步工具调用、任务中追加指令、推理强度按阶段切换。还筛选了 X 上三个典型案例:重建火车图为 3295 个可编辑对象、自动跑模拟器测试、核对 41 份财务文件。作者强调应将 AI 整合进工作流,拆分输入、工具调用、验收和人工确认环节,而非神化模型能力,敏感操作仍需人工把关。
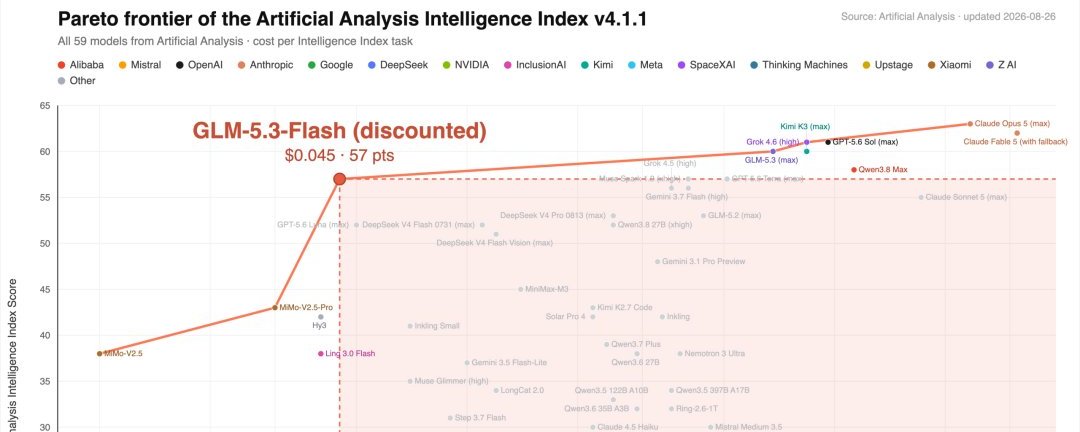
作者实测智谱新发布的 GLM-5.3-Flash 模型,对比 DeepSeek V4 Flash 的价格与性能。该模型每百万 Token 输入 0.8 元、输出 2.8 元,在 Artificial Analysis 榜单上以 $0.045 成本获得 57 智力分,14 项 benchmark 中赢 DeepSeek 11 项,视觉端六项全胜,与 Opus 4.8 对比 13 项赢 9 项。实际测试中,模型可通过一句话从截图、视频、链接复刻网站(如 GitHub、3D 游戏 Krunker),前端与视觉能力极强。作者计划将日常 coding 和 agent 任务分流给它以节省成本。
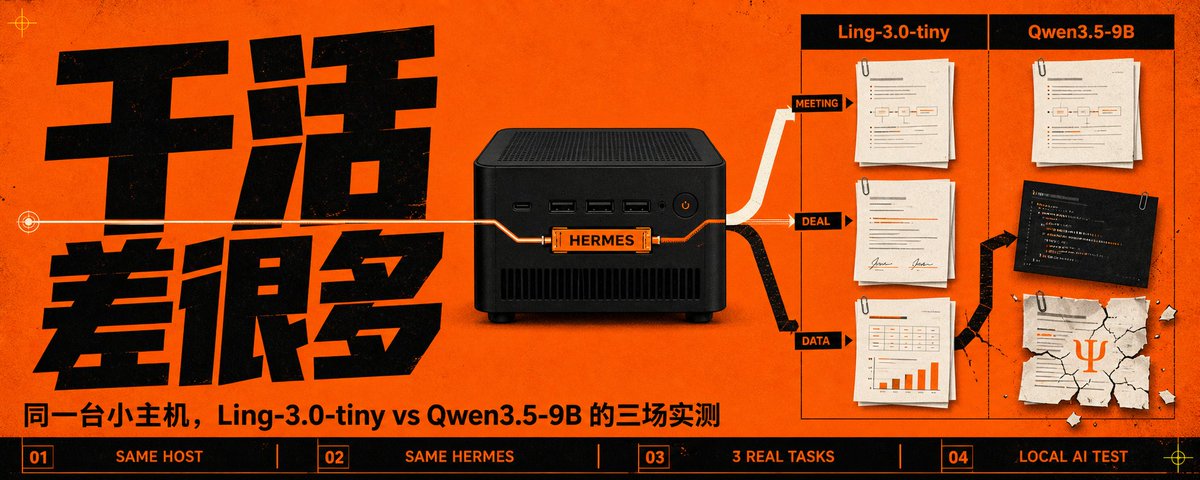
作者在 AMD Ryzen AI MAX+ 395 小主机上,用相同提示词和 Hermes 环境,对 Ling-3.0-tiny 与 Qwen3.5-9B(均 Q8_0、64K 上下文)跑三份真实业务任务:电商中台需求整理、商务合作决策备忘录、X 长文数据分析。结果 Ling 在前两轮抓住主线、输出可继续修改,总耗时仅约为 Qwen 的 56%;Qwen 在数据题上更稳,但商务任务两次失控,一次忘记任务、一次虚构公司实体。作者最终选择 Ling 作为默认模型,并强调应以模型最差一轮而非最好一轮作为取舍标准,同时收紧本地 Agent 的权限边界,保持人工把关。