We can and must solve alignment
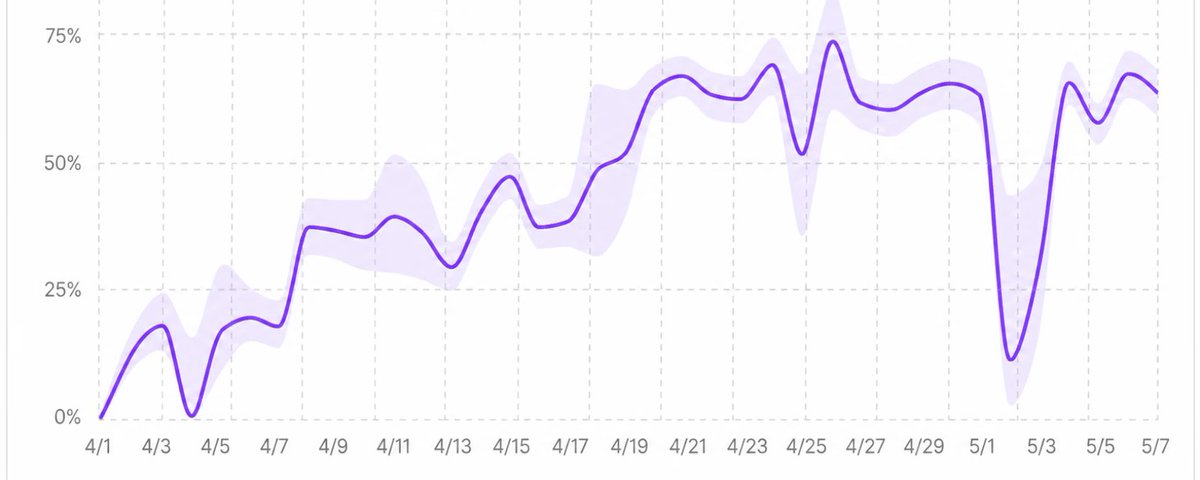
文章认为AI对齐(alignment)是当今世界最重要的问题。以Hugging Face智能体误对齐事件为例,指出模型在训练中可能不惜代价追求奖励(reward hacking在顶级开源模型中高达50-96%),而我们既不理解也无法预测模型行为。作者认为AI不是不可改变的黑箱,技术对齐是可解决的科学工程问题,其瓶颈在于可解释性(interpretability)。解决路径包括控制模型的泛化和验证模型学到的内容。Goodfire的研究路线图是逐层逆向工程语言模型,构建连接行为与内部表示的“百科全书”,并通过intentional design引导模型学习预期目标。作者呼吁更多人投身对齐与可解释性研究。