使用 SGLang 和 Torch Profiler 对 LLM 推理进行性能分析
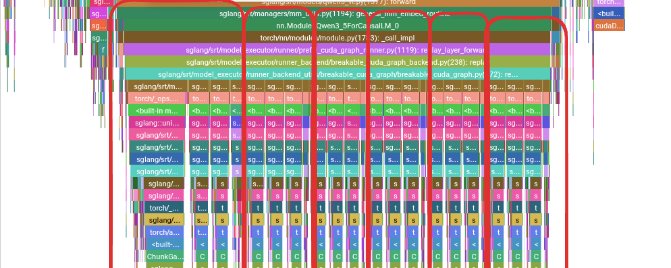
本文详细介绍了如何使用 SGLang 内置的 Torch Profiler 对大语言模型(Qwen3.5-0.8B)进行推理性能分析。作者阐述了如何通过追踪 CPU 和 GPU 端事件来定位计算瓶颈,并结合屋顶线模型证实单批次解码主要受限于内存带宽。文中展示了如何利用 Perfetto UI 分析 Prefill 阶段的性能追踪数据,将其底层计算操作与模型的混合架构(如 Gated DeltaNet 和全注意力机制)精准映射,帮助读者深入理解 LLM 的底层执行流程。