Wiki 知识库

全部文档 / 标签: SGLang

14 篇
清除

推理是训练的 12 倍,可一块卡生成时只跑出 5% 的算力

文章基于 YC Paper Club 播客,剖析 LLM 推理成本真相:按两年模型寿命摊算,推理总算力约为训练的 12 倍。decode 阶段 MFU 仅 5%,瓶颈在显存带宽而非算力。DeepSeek 通过 KV cache 保留 72 小时、radix attention、零开销调度等手段将缓存命中率做到 96%,实现 38 美元一卡时、80% 毛利。文章还讨论了 SSM 等被低估的模型结构、服务商质量参差(同一模型不同服务商差距超开源闭源差距)以及开源推理生态的规模,指出推理成本优化才是 LLM 竞争的胜负手。

技术 › LLM Saito 2026-10-268.7 KB 140 77

From Big Tech SWE to AI Infra (Part 2): What I Learned in My First Year

作者分享从大厂软件工程师转向 AI 基础设施方向一年的学习历程与心得。毕业加入大厂后,因工作缺乏主动性空间和创造感,三个月后决定转向 AI infra。通过学习基础知识、深入研读 SGLang 源码、参与社区贡献,逐步加入 SGLang-Omni 项目并进入一家 AI infra 创业公司。作者认为这一年是高回报率的一年,但也指出 AI 领域竞争激烈、节奏快,转行需权衡个人追求。文章最后强调了开源的重要性,认为强大的 AI 工具不应只掌握在少数公司手中,呼吁更多人参与开源社区。

技术 › 后端 Yichi Zhang 2026-10-257.8 KB 20K 401 69

AI 每日早报:DeepSeek 开源推理框架、Google TPU 推理引擎与 Anthropic 的 AI 队友实践

本期早报聚焦三条主线:一是 DeepSeek 全面开源内部推理框架 DeepInfer 与生产级 Token 编解码组件 deepseek-recipe,覆盖分布式推理、推测解码、结构化输出等能力,兼容英伟达与昇腾平台;二是 Google 为 vLLM 和 SGLang 推出原生 PyTorch TPU 后端,通过 TorchTPU、分层缓存与 TPU Sync 优化多轮 Agent 场景下的推理性能;三是 Anthropic 团队分享 Claude 如何从问答助手成长为承担团队职责的协作伙伴,涵盖追踪表维护、内部应用开发与会议协调等案例。速览部分还介绍了小红书 ROSS 训练方法、FairStress 公平性评估基准、Dyna Robotics 机器人 Scaling Law 及 SGLang 低延迟模式。

技术 › LLM ginobefun 2026-10-2128.3 KB 1.7K 1 77

Build your own Jev (100% local):用开源 LLM 构建本地决策引擎

文章介绍如何将开源 LLM 变成快速、本地的决策引擎,而无需重新训练。核心思想是:当应用已知所有可能的答案时,不必让模型生成文本或 JSON,而是通过 next-token scoring 一次性为每个候选答案返回分数和概率分布。作者讲解了固定答案打分与结构化输出的区别、LLM 第一个输出 token 的生成原理,并使用 SGLang 的 /v1/score 接口,结合 Qwen 和 DeepSeek 模型进行实测,与普通文本生成进行了基准对比。文中还提到概率的含义与校准问题。

技术 › LLM Avi Chawla 2026-09-2022.3 KB 1.1M 3.1K 76

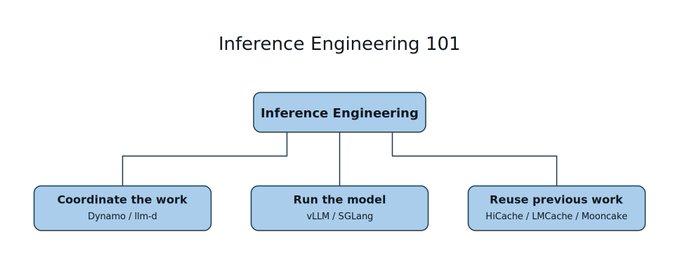
推理工程入门指南

本文介绍了推理工程的概念、重要性及入门方法。推理工程负责在满足产品需求(正确性、响应时间、可靠性和成本)的前提下运行已训练模型,涵盖模型选择、评估、服务、性能优化和运维。软件工程师可凭借API设计、性能分析、缓存等技能进入该领域。文章通过vLLM、SGLang和llama.cpp三个开源项目,展示了如何解决高并发、重复计算和硬件适配等实际问题,并强调定义工作负载和复现问题的重要性。

技术 › LLM danialhasan 2026-09-1418.6 KB 54.5K 526 78

The Inference Engineering Skills Map

作者从 B2B SaaS Web 开发转向推理工程一个月后分享的入门知识地图。文章将推理工程分为三大类:协调工作(Nvidia Dynamo、llm-d 负责路由、调度与扩展,需智能负载均衡)、运行模型(vLLM、SGLang 处理批处理、张量并行、prefill/decode 分离)、复用先前工作(KV 缓存与 HiCache、LMCache、Mooncake 实现跨 GPU/CPU/NVMe 的分层前缀缓存)。作者强调从 Web 开发转型并不难,不需要精通 CUDA,先跑起模型、发送流量,再逐层深入即可。

技术 › 后端 Nick Khami 2026-09-118.5 KB 17.7K 512 73

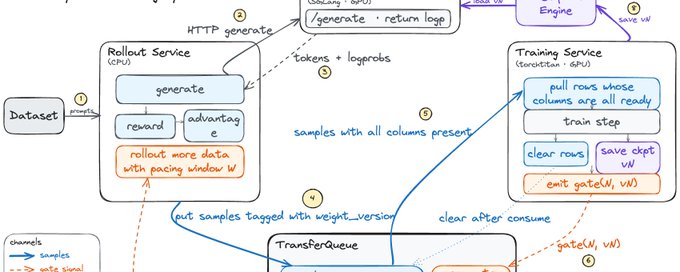
Meshy: 角色驱动下 SPMD 范式的 RL 训练框架

本文介绍了开源 RL 训练框架 Meshy,它摒弃了中央控制器和 Ray,将 Inference、Training、Rollout、Teacher 建模为独立服务。样本数据通过 TransferQueue 数据面在生产者与消费者之间直达传输,流程由数据列的就绪状态驱动,拓扑由各进程在启动时本地确定性推导,使 RL 训练回归预训练式的 SPMD 设计。文章分析了传统 RLHF 流水线与 Single-Controller 架构在异步生成、多轮 Agent 等场景下的局限,阐述了 Meshy 通过声明式 ServiceGroup、基于令牌环的多角色共置等机制,支持同步 RL、异步 RL 及在线蒸馏等多种训练方式。框架基于 TorchTitan 与 SGLang 实现,代码已开源。

技术 › LLM Guitar Cat + LLM 2026-09-0931.4 KB 8.2K 67 84

Agentic Kernels in Production

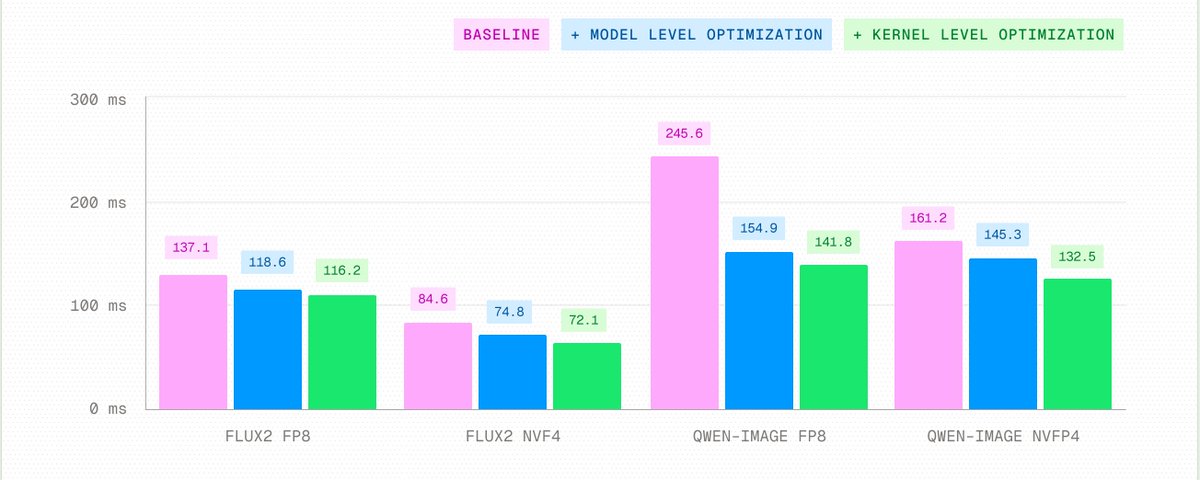
文章介绍了一个面向生产环境的 agentic kernel 优化框架,弥合基准测试与生产部署之间的差距。框架分为模型级优化和单 kernel 优化两层:先对完整 workload 进行 profile,提出算子融合、冗余消除等改进,再并行探索多个 kernel 实现并迭代优化。框架还具备自我改进机制,将成功与失败的优化经验存入知识库供后续复用。在实际部署中,该框架将 Qwen-Image 端到端延迟降低 42.3%,FLUX.2 降低 15.2%,MiniMax M3 吞吐提升 5.5%,具体优化包括 FP8 scale 预打包、QKV 投影融合、归一化与量化融合等。

技术 › LLM Brian Li 2026-08-2917.1 KB 265.1K 758 77

我把 Moderna 癌症疫苗论文丢给 Apodex 的 Deep Discover(附 RTX 5090 本地部署)

作者以 Moderna/Merck 个体化 mRNA 癌症疫苗 Phase 3 进展为案例,体验了 Apodex 的 Deep Discover 多 Agent 研究产品。产品通过 Task Board、分工的 Sub-agent(临床数据读取、肿瘤研究、估值分析)与 Verifier 复核,实现可视、可中途干预的研究流程,并在测试中自行纠正了药物实体混淆。文章后半部分详细记录在单张 RTX 5090 上用 SGLang 部署 Apodex 1.1 mini(36B MoE GPTQ Int4)及开源 FrontierAgent 的过程,包括网络代理与 SSRF 防护冲突的排查、Agent Team 宏观研究实测,以及单卡下并行的本质是任务与上下文并行而非吞吐并行的性能分析。

技术 › Agent 九尾狐-FoxFairy 2026-08-2820.4 KB 25.5K 115 82

重新审视 CPU 资源作为语音模型 Serving 过程的一等公民

本文回顾了 SGLang Omni 项目在 CI 运行中发现的 CPU 瓶颈问题。由于语音模型推理具有短请求、高并发的特点,CPU 资源成为性能的关键瓶颈。通过实验发现,CPU 资源争用(而非核数不足)导致每个请求消耗更多 CPU 时间,从而显著降低吞吐量。文章详细分析了争用的微观机制,并提出了通过 cpuset 绑核、优化编译缓存等修复措施,最终显著提升了 CI 的稳定性与性能。

技术 › LLM Chayenne Zhao 2026-08-2028.5 KB 14.5K 67 84

Qwen3.8-27B Practical Guide: Control Reasoning Depth and Extend Context to 1M Tokens

Qwen3.8-27B is a compact, deployment-friendly dense model with native vision-language understanding and flexible thinking control. It introduces two key features: reasoning_effort to adjust reasoning depth per request, and ultra-long context support (262K native, up to 1M with YaRN). This guide provides practical instructions on using these features, including code examples for OpenAI-compatible API, vLLM, SGLang, and TokenSpeed, along with tips for optimal configuration.

技术 › LLM Qwen Developers 2026-08-155.7 KB 76.2K 1.2K 78

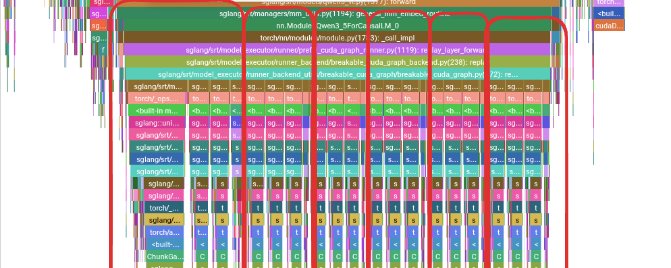
使用 SGLang 和 Torch Profiler 对 LLM 推理进行性能分析

本文详细介绍了如何使用 SGLang 内置的 Torch Profiler 对大语言模型(Qwen3.5-0.8B)进行推理性能分析。作者阐述了如何通过追踪 CPU 和 GPU 端事件来定位计算瓶颈,并结合屋顶线模型证实单批次解码主要受限于内存带宽。文中展示了如何利用 Perfetto UI 分析 Prefill 阶段的性能追踪数据,将其底层计算操作与模型的混合架构(如 Gated DeltaNet 和全注意力机制)精准映射,帮助读者深入理解 LLM 的底层执行流程。

技术 › LLM Jino Rohit 2026-08-0913.8 KB 104.1K 916 88

PagedAttention & RadixAttention

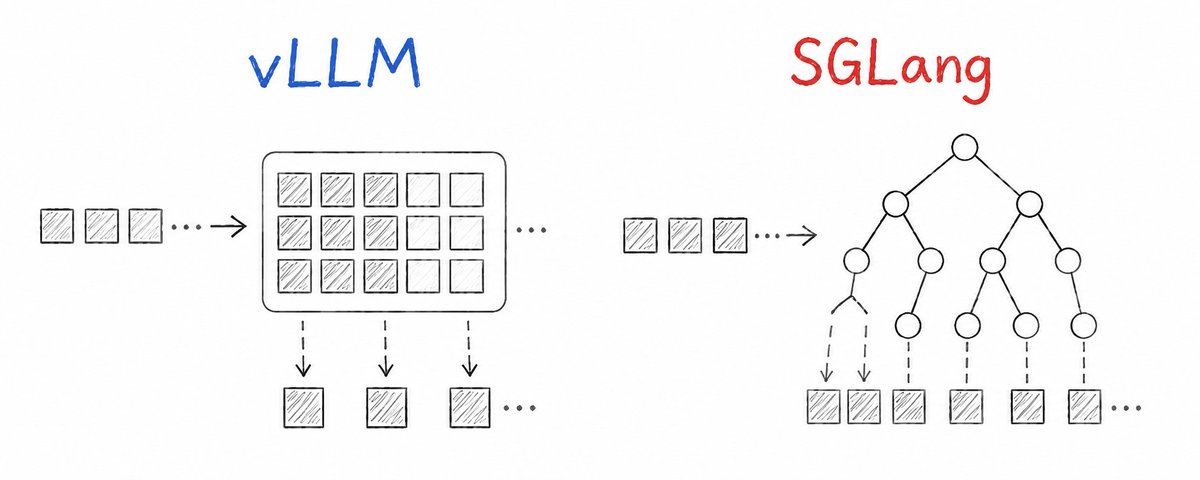
本文深入探讨了 PagedAttention 和 RadixAttention 两种技术。PagedAttention 通过类似操作系统的分页机制管理 GPU 内存,解决 KV Cache 的内部和外部碎片问题,显著提升并发处理能力。RadixAttention 则利用基数树索引缓存的前缀状态,实现跨请求的计算和内存复用,进一步优化推理性能。

技术 › LLM prasanna 2026-07-2814.4 KB 43.7K 565