Wiki 知识库

全部文档 / 标签: 质量保障

3 篇
清除

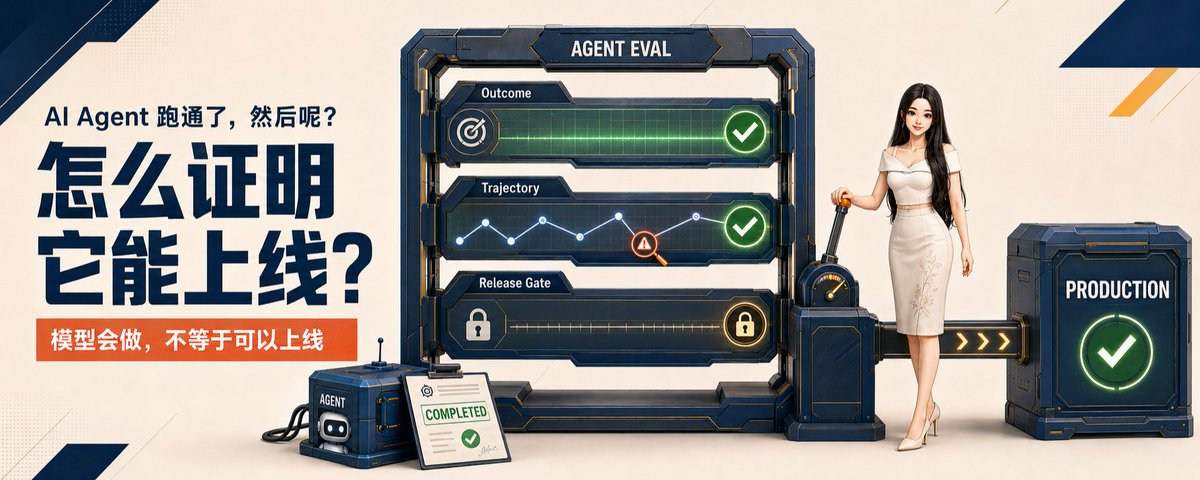
AI Agent 跑通了,怎么证明它真的可以上线?

文章指出 Agent 最危险的失败不是报错,而是做错了却显示"已完成"。作者以一个资料研究 Agent 为例,搭建了一套最小可用的 Agent 评测框架,回答三个问题:任务有没有做成、失败发生在哪里、新版本能否发布。核心方法包括:先明确评测要回答的发布决策;把"做完"写成可检查的完成条件和 Hard Failure;建立 30 条起步的分层评测数据集(dev/holdout/regression/challenge);将 Outcome 与 Trajectory 分开评估;采用 Rules + LLM Judge + Human 三层打分体系。最终通过重复运行对比 v1/v2、设置发布门禁、把线上失败送回评测集,形成完整评测闭环。

技术 › Agent Cloris 🌱 2026-09-0426.4 KB 319.9K 512 85

你的AI第一次运行成功,这几乎证明不了什么

本文指出,AI系统首次运行成功并不能证明其可靠性,因为环境变化或输入差异可能导致失败。作者强调,评估(Evals)是确定AI系统可信度的关键,它要求基于实际工作场景收集案例,并明确“好”的标准。通过持续测试和迭代,评估集能帮助团队了解系统的边界和失败模式。文章还区分了公共基准与产品级评估,认为后者必须基于具体业务场景。最后,作者提倡将评估作为系统开发的核心部分,以确保AI在实际工作中的可靠性。

技术 › LLM Hiten Shah 2026-08-136.8 KB 18.8K 46 62

Eval Engineering: 构建无需人工干预的 Agent 合并闸门(6 步指南)

本文介绍了如何构建一个评估工程闸门,使 Agent 能够在无需人工审查的情况下自动合并代码。文章提出了六个关键步骤:避免评估偏见、将评估结果作为运行控制、评估过程轨迹而非仅关注答案、利用历史日志生成测试用例、固定评估模型版本,以及确保评估规模。核心在于建立可靠的证据和规则,而非盲目信任模型。

技术 › Agent Hanako 2026-08-0611.0 KB 744.7K 667