Evals: 如何判断 AI 系统是否真正有效
本文系统讲解了 AI 系统评估的基础知识,面向构建、购买或审批 LLM 应用的工程师、产品经理和管理者。文章以一个自行车商店客服助手为例,介绍评估的核心循环:收集带标准答案的输入、运行系统、用代码规则或模型裁判进行打分、生成带误差范围的指标。内容涵盖测试集与开发集的划分、失败模式分析、代码评分器与模型裁判的优劣、基准测试与评估的区别、以及如何将评估纳入日常开发流程,强调评分器本身也需要被检验。
本文系统讲解了 AI 系统评估的基础知识,面向构建、购买或审批 LLM 应用的工程师、产品经理和管理者。文章以一个自行车商店客服助手为例,介绍评估的核心循环:收集带标准答案的输入、运行系统、用代码规则或模型裁判进行打分、生成带误差范围的指标。内容涵盖测试集与开发集的划分、失败模式分析、代码评分器与模型裁判的优劣、基准测试与评估的区别、以及如何将评估纳入日常开发流程,强调评分器本身也需要被检验。
本文指出,AI系统首次运行成功并不能证明其可靠性,因为环境变化或输入差异可能导致失败。作者强调,评估(Evals)是确定AI系统可信度的关键,它要求基于实际工作场景收集案例,并明确“好”的标准。通过持续测试和迭代,评估集能帮助团队了解系统的边界和失败模式。文章还区分了公共基准与产品级评估,认为后者必须基于具体业务场景。最后,作者提倡将评估作为系统开发的核心部分,以确保AI在实际工作中的可靠性。
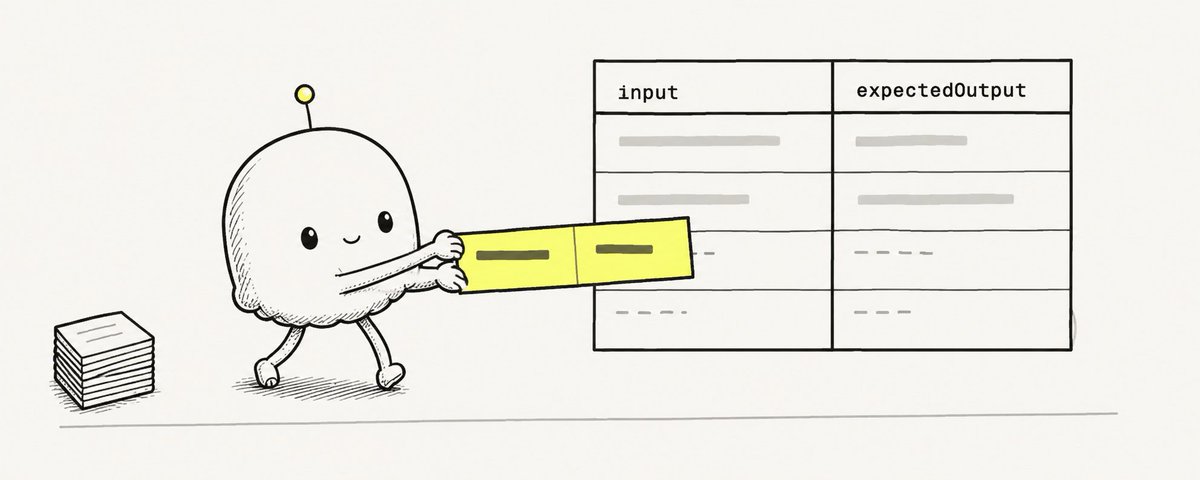
当应用仅靠直觉调试无法满足需求时,构建评估数据集至关重要。本文详细介绍了设计AI Agent评估数据集的五个核心步骤:1.明确数据集的最小目标;2.检查生产记录、现有资产等可用数据源;3.规划输入分布,合理搭配场景与难度;4.决定评估机制,选择基于参考或无参考的评估方式;5.定义包含输入、预期输出和元数据的结构化项目模式。通过迭代设计,确保系统质量可量化和持续改进。
文章介绍了作者开发的“自愈 Agent Harness”系统,该系统通过 AI 代理实现了自动化评估和修复闭环。它包含三个核心组件:用于实时评分的三法官评审团、将低分转化为修复工单的工程管道,以及由 AI 评分控制发布的灰度发布机制。这一系统替代了传统的 QA 和人工审查,使团队能够在每天发布 3-8 次的高频节奏下,自动发现并修复模型幻觉、工具契约漂移或基础设施故障等问题。