Wiki 知识库

全部文档 / 标签: 可靠性

9 篇
清除

Agentic evals: 如何判断 AI Agent 是否真正完成了任务并保持可靠

本文面向构建基于 LLM 的 Agent 系统的工程师,讲解如何对 Agent 进行评估(Agentic Evals)。核心观点是:要评估 Agent 实际改变了什么,而非它说了什么。文章通过一个自行车店客服 Agent 的完整示例,展示五步评估法:编写带预期终态的任务、多次运行并保留完整轨迹、同时评估终态和路径、报告能力与可靠性两个数字、定位失败的第一步。文章还区分了单次回答模型与多步 Agent 在评估上的差异,强调没有可检验终态的任务不构成有效的评估,并讨论了模型作为评判者的可信度问题。

技术 › Agent Sergii Makarevych 2026-10-1151.9 KB 65.5K 671 89

Building Prod with Jev and LangGraph

TypeSafe AI 发布了决策模型 Jev,不同于传统 LLM,它不生成文本,而是返回带概率的结构化决策结果,在路由、分类等窄任务上比领先 LLM 快 200 倍、便宜 400 倍,并具有一致性和可并行性。LangChain 团队认为这与其'prod, not god'理念契合:代码掌控工作流,AI 只处理需要语义判断的分支。文章介绍如何用 LangGraph 编排 Jev 决策,包括节点、状态和边的架构,以及持久化执行、人在环路和可观测性等可靠运行时能力,实现可靠、可测试的 AI 驱动生产系统。

技术 › Agent Sydney Runkle 2026-09-2616.1 KB 108.3K 224 72

智能体评测三要素:时长、价值与可信度 | 斯坦福 CS329A Part 8 深度解读

本文深度解读斯坦福 CS329A Self-Improving AI Agents 课程第八讲,通过三篇前沿论文系统讲解智能体评测:METR 用'50%时间视界'衡量模型可完成任务的时长(每约7个月翻倍,但80%可靠性下缩短4-6倍);OpenAI GDPval 用盲测胜率衡量经济价值(Claude Opus 4.1 达 47.6%,但趋势近似线性);DeepScholar-Bench 评测知识综合的可信度(最高分仅31%,检索与综合是双重瓶颈)。核心结论:能力≠价值≠质量,三者共同撞上'上下文之墙',评测需多指标并用并保持人类校验。

技术 › Agent meng shao 2026-09-1410.2 KB 11K 26 81

Harness Engineering: 构建可靠 AI Agent 的完整指南

文章指出许多 Agent 失败并非模型推理问题,而是环境(Harness)设计缺陷。作者系统阐述了 Harness Engineering 这一工程学科:将模糊请求转化为包含目标、范围、约束、验收标准和审批要求的任务契约;通过渐进式披露提供项目地图而非信息轰炸;构建带校验和风险控制的工具网关而非工具堆砌;分离大脑(推理)、双手(执行)和历史(状态)三大职责;将对话历史转化为包含事实、决策、进度和教训的持久化状态,从而将模型智能转化为可靠的工作成果。

技术 › Harness Engineering Lunar 2026-09-0722.2 KB 1.3M 621 81

构建弹性生产级 Agent Harness 的 5 层架构

文章指出 Agent 可靠性的关键在于模型之外的确定性软件基础设施,即 Harness Engineering。作者提出构建弹性生产 harness 的 5 层方法:1)从模型优先转向系统优先架构,结构化工作流可将任务完成率从 31.7% 提升至 78.0%;2)实现持久化状态与检查点,避免长时间运行中丢失进度;3)通过角色分离(规划者、生成者、评估者)构建验证闭环;4)利用 hooks 和隔离运行时(如沙箱、网关)确保安全边界,防御提示注入;5)记录结构化追踪便于调试与自动化修复。文中结合 Google Antigravity、ADK 2.0、Gemini Enterprise 等工具给出实践建议。

技术 › Harness Engineering Google Cloud Tech 2026-08-298.7 KB 35.7K 263 81

2026 Agent Eval 全景图:从'会做'到'值得部署'

本文系统梳理了2026年Agent评估领域的全景图,指出Agent Eval正从'任务能否完成'转向'结果是否有效、过程是否可靠、系统是否值得部署'。文章从通用Agent、软件工程、GUI与SaaS、工具与事务、知识工作(Deep Research、数据分析、预测)、多模态内容生产、科研优化、组件与记忆、多Agent系统等赛道,介绍了代表benchmark及其演进,并强调了可靠性、成本、轨迹审计与证据包成为评估的新基本单位。

技术 › Agent Cloris 2026-08-2221.9 KB 5.6K 56 77

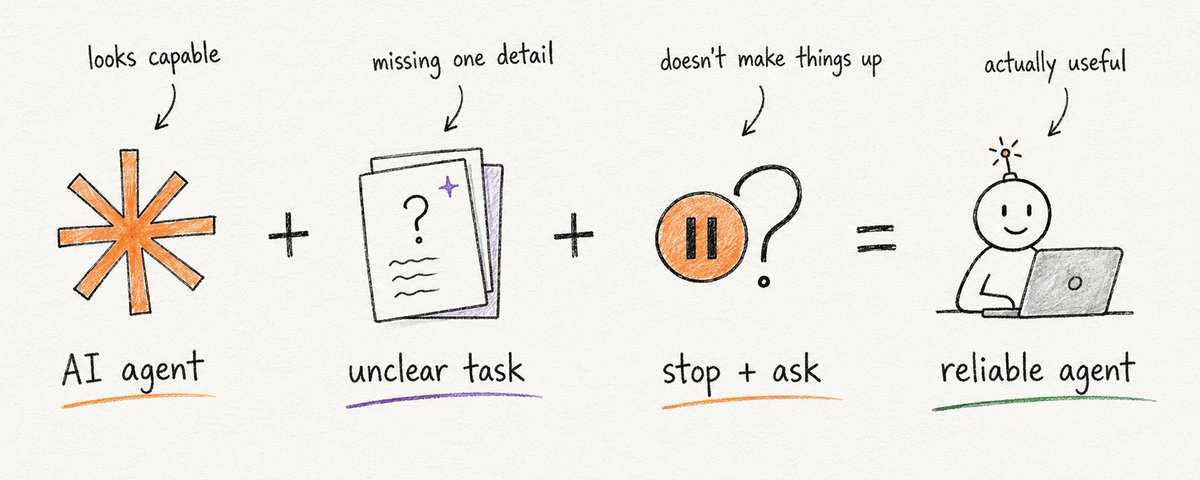
The simple rule that stops AI agents from guessing

本文探讨了AI代理在不确定情况下容易猜测并继续执行任务的问题,提出了一条简单规则:当信息不足时,代理应暂停并寻求帮助。文章详细说明了何时应触发该规则、如何将其集成到AI工作流中,以及如何测试代理的决策行为。通过设置检查点,代理可以在处理常规任务时自主行动,但在关键决策上寻求用户输入,从而提高可靠性和可信任度。

技术 › Agent Penguin 2026-08-1515.2 KB 14.1K 25 79

你的AI第一次运行成功,这几乎证明不了什么

本文指出,AI系统首次运行成功并不能证明其可靠性,因为环境变化或输入差异可能导致失败。作者强调,评估(Evals)是确定AI系统可信度的关键,它要求基于实际工作场景收集案例,并明确“好”的标准。通过持续测试和迭代,评估集能帮助团队了解系统的边界和失败模式。文章还区分了公共基准与产品级评估,认为后者必须基于具体业务场景。最后,作者提倡将评估作为系统开发的核心部分,以确保AI在实际工作中的可靠性。

技术 › LLM Hiten Shah 2026-08-136.8 KB 18.8K 46 62

五个被低估的 Hermes Agent 技能

本文介绍了能将 Hermes Agent 提升为操作系统的五个强大且常被低估的技能。grounded-citations 通过要求提供可验证来源来确保研究准确性;dogfood 作为测试代理,以真实用户视角发现产品交互缺陷;systematic-debugging 强调在修改代码前先进行结构化调查以找到根本原因;hermes-agent-skill-authoring 将重复工作转化为可复用的记忆技能。这些技能大幅提升了 AI 工作流的可靠性、可扩展性和操作效率。

技术 › Agent Hermes Agent Super-Intel 2026-08-0812.9 KB 9.9K 52 80