Wiki 知识库

全部文档 / 标签: 数据集

9 篇
清除

Streaming 100 TB+ Robot Datasets

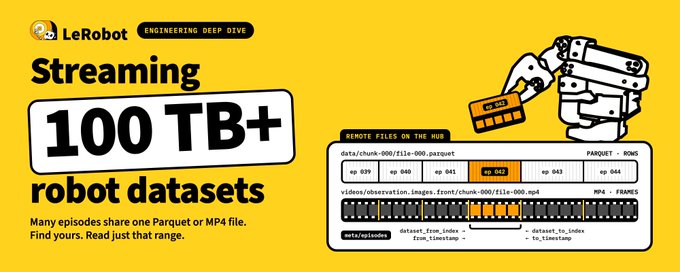
LeRobot 推出了面向 100 TB 及以上规模机器人数据集的新型 episode 级流式数据加载器,可直接从 Hugging Face 数据集或 Bucket 读取选定的 episode 并准备训练样本,无需完整下载本地视频副本。文章阐述了流式加载器的四大需求:保持 GPU 繁忙、混合 episode、覆盖全部数据、控制内存使用。通过 Parquet 统计信息定位表格数据、MP4 sidecar 索引定位视频帧、在 RAM 中维护压缩视频字节池,并采用锚点采样与预取机制,实现数据集持续增长下的高效训练。

技术 › 工具与效率 LeRobot 2026-10-1013.2 KB 12.4K 145 84

Agentic 时代值得构建的 13 种生意

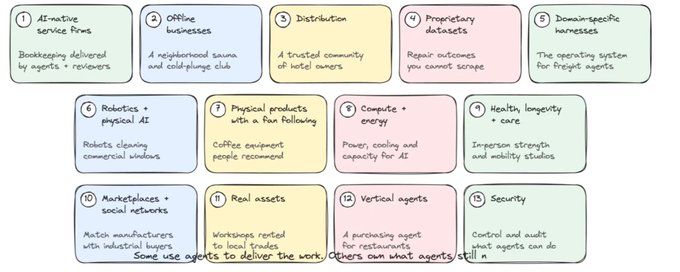
作者认为在 Agent 普及、生产力极大丰富的未来,拥有正确的资产才能占据优势,并归纳出 13 种值得构建的生意:AI 原生服务公司、线下体验生意、分发能力(ACP 漏斗:受众→社区→产品)、专有数据集、领域专属 Harness、机器人与物理 AI、有粉丝基础的实体产品、算力与能源、健康长寿与养老照护、市场与社交网络等。文章为每类生意解释了其在 Agent 时代的逻辑,并配有真实案例,如记账自动化公司、 sauna 俱乐部 Othership、Mercor、Osmo、Fellow、Crusoe 等,为创业者提供方向地图。

技术 › Agent The Startup Ideas Podcast (SIP) 2026-10-0711.3 KB 38.7K 363 70

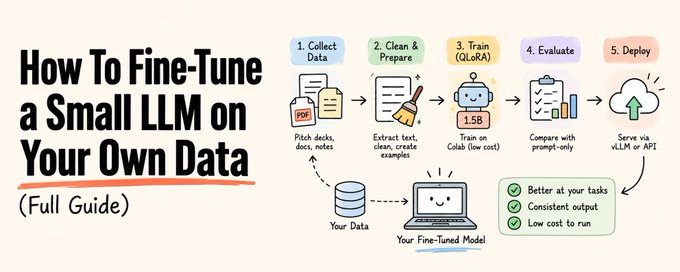
How To Fine-Tune a Small LLM on Your Own Data (Full Guide)

这是一篇关于微调小型LLM的完整实战指南。作者指出不需要70B大模型或昂贵算力,1.5B参数模型在200-500个优质样本上微调后,可在特定任务上超越通用提示的前沿模型。文章以商业融资文案生成为例,详细讲解了微调的实际目标、建立基线(纯提示、RAG、微调)的先后顺序,并分步骤介绍了小型基座模型选择(如Qwen2.5-1.5B)、数据权利合规、可复现数据下载、PDF文本提取与OCR、文本清洗、训练数据集构建、QLoRA训练、评估与部署,每一步均附完整代码。

技术 › LLM Rahul 2026-09-1926.1 KB 2.5M 2.7K 86

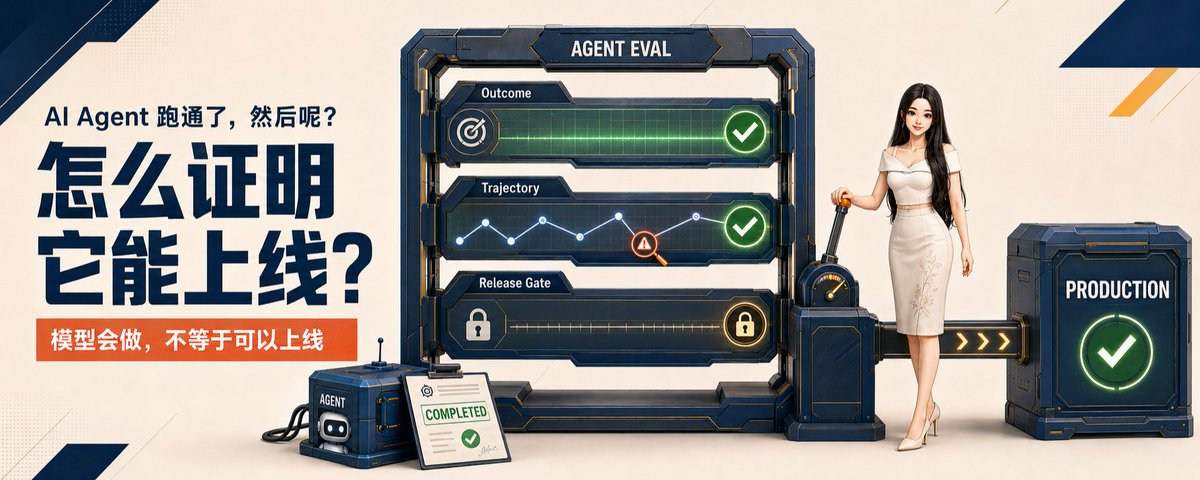
AI Agent 跑通了,怎么证明它真的可以上线?

文章指出 Agent 最危险的失败不是报错,而是做错了却显示"已完成"。作者以一个资料研究 Agent 为例,搭建了一套最小可用的 Agent 评测框架,回答三个问题:任务有没有做成、失败发生在哪里、新版本能否发布。核心方法包括:先明确评测要回答的发布决策;把"做完"写成可检查的完成条件和 Hard Failure;建立 30 条起步的分层评测数据集(dev/holdout/regression/challenge);将 Outcome 与 Trajectory 分开评估;采用 Rules + LLM Judge + Human 三层打分体系。最终通过重复运行对比 v1/v2、设置发布门禁、把线上失败送回评测集,形成完整评测闭环。

技术 › Agent Cloris 🌱 2026-09-0426.4 KB 319.9K 512 85

GitHub 不只是找代码的地方:8 个实用开源仓库推荐

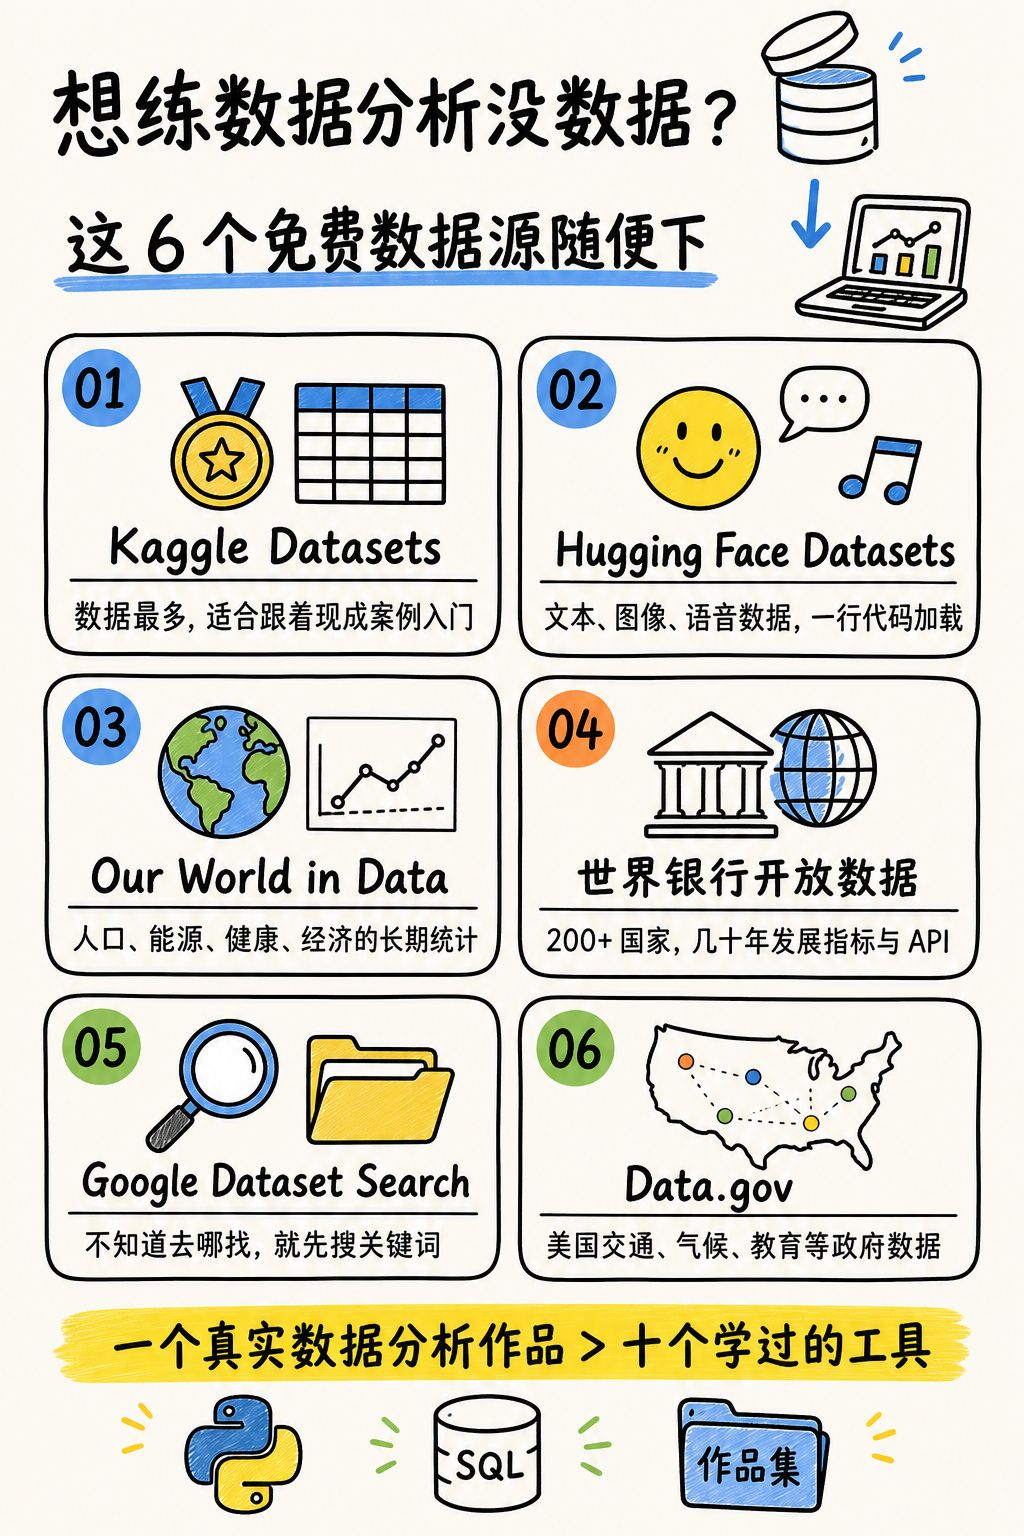
作者分享了 8 个实用的 GitHub 仓库,覆盖 AI 副业案例(ai-money-maker-handbook)、闲鱼监控、远程工作资源、Telegram 资源导航、经典 Awesome 总入口、n8n 自动化工作流、量化交易资源库和公开数据集。作者认为这些仓库的核心价值在于有人整理好了信息、工具和数据,并将自动化基础设施开源,关键在于如何组合这些资源转化为自己的能力和生意。

技术 › 工具与效率 Kelvin (@ai_Goge) 2026-08-213.5 KB 53

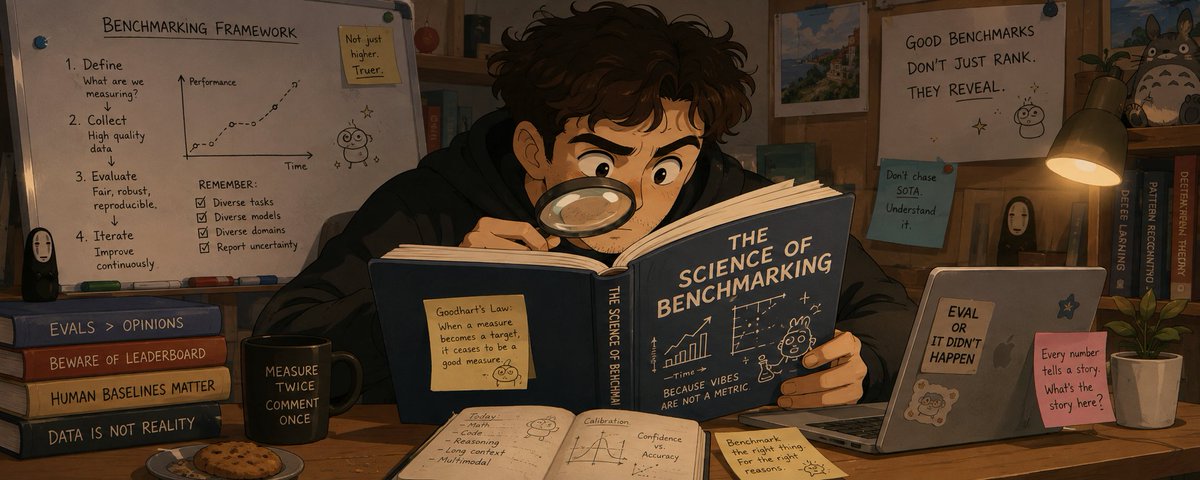
The science of benchmarking: from Zero to Hero [Part I]

本文是基准测试科学系列第一部分,从第一性原理讲解LLM评测:为什么评测(为无法直接观测的能力提供决策证据)、评测什么(任务、数据与用户环境的代表性)、如何评测(指标、采样与统计)。作者将基准视为测量仪器而非问题集合,拆解了任务、数据集、评分器等核心组件,并强调分数不等于能力本身,声明离直接观测越远所需假设越多。后续部分将讨论基准失效、数据污染与榜单刷分等议题。

技术 › LLM giovanni 2026-08-1428.0 KB 66

训练小模型:2026 年最被低估的 AI 技能

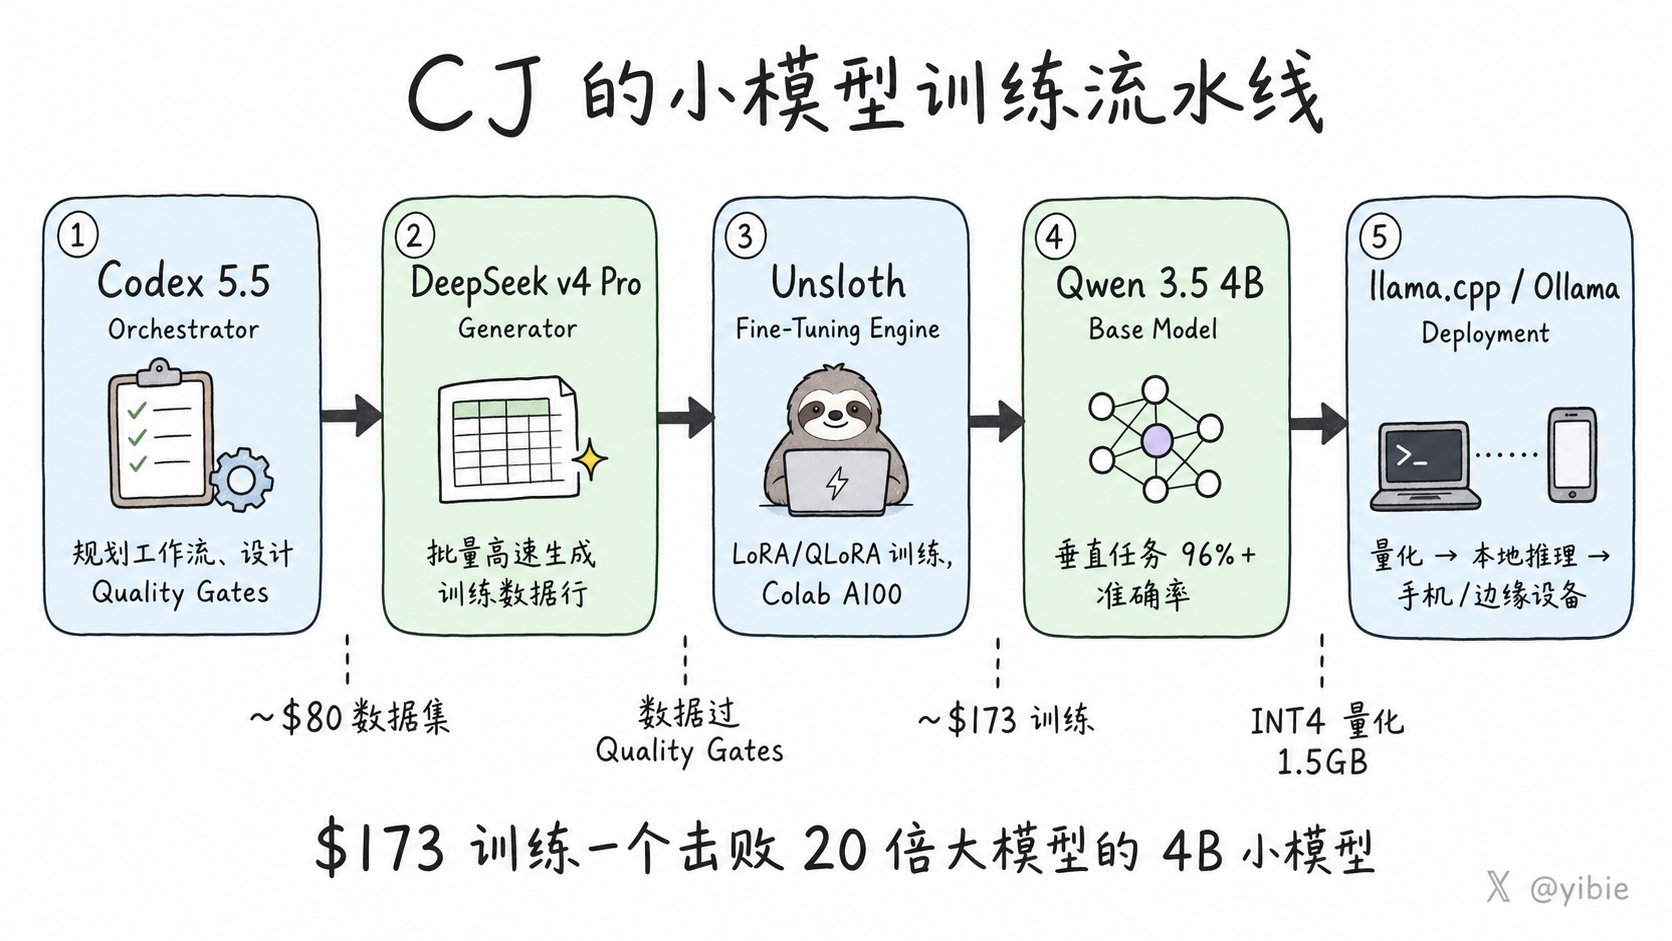
本文探讨了 2026 年 AI 领域的边缘趋势:个人开发者训练小模型(SLM)。文章详细介绍了 CJ Zafir 的方法论,即利用 Codex 和 DeepSeek 生成数据、Unsloth 进行训练、Qwen 作为基座,以极低成本(最低 11 美元)在垂直任务上超越大模型。文章指出,真正的护城河在于高质量数据集的生成工厂,而随着硬件门槛降低和工具成熟,模型微调正从企业军备竞赛转向个人技能。

技术 › LLM yibie 2026-06-028.1 KB 88

Designing eval datasets for LLM applications

本文是 Langfuse Academy 系列的一部分,深入探讨了 AI 工程生命周期中的数据集设计。文章解释了数据集如何连接生产监控与开发迭代,详细介绍了数据集项的三个核心字段(输入、期望输出、元数据)及不同的评估模式。此外,文章还分享了构建高质量数据集的最佳实践,包括如何定义范围、确定规模,以及如何从生产 Trace、手工编写和合成数据中起步。

技术 › LLM Lotte 2026-05-186.3 KB 39.8K 321 80