Wiki 知识库

全部文档 / 作者: 美研芒格君 (@Kay2289123) / 标签: AI推理

2 篇
清除

越来越值钱的互联:从存储到AI推理这条路,能让GPU少等一会儿,是被95%的人低估了的万亿市场

本文从GPU算力与内存速度不匹配的问题出发,深入分析AI推理中KV缓存的内存占用与复用机制,说明为什么给GPU扩容后计算芯片仍在等待数据。文章以Qwen3-32B为例量化KV缓存大小,比较本地缓存与远端缓存的传输开销,指出连接在缓存共享、跨机器传输中的关键作用。随后分析了铜互连与光互连各自的适用场景,介绍NPO/CPO技术路线,并以Marvell的CXL内存扩容控制器、交换芯片、信号调节芯片和Photonic Fabric为例,梳理连接芯片厂商的商业逻辑与验证进度,最后从客户成本账角度论证互联市场的价值,认为这是一个被低估的万亿级机会。

投资 › 股票 美研芒格君 2026-09-1220.7 KB 15.7K 95 83

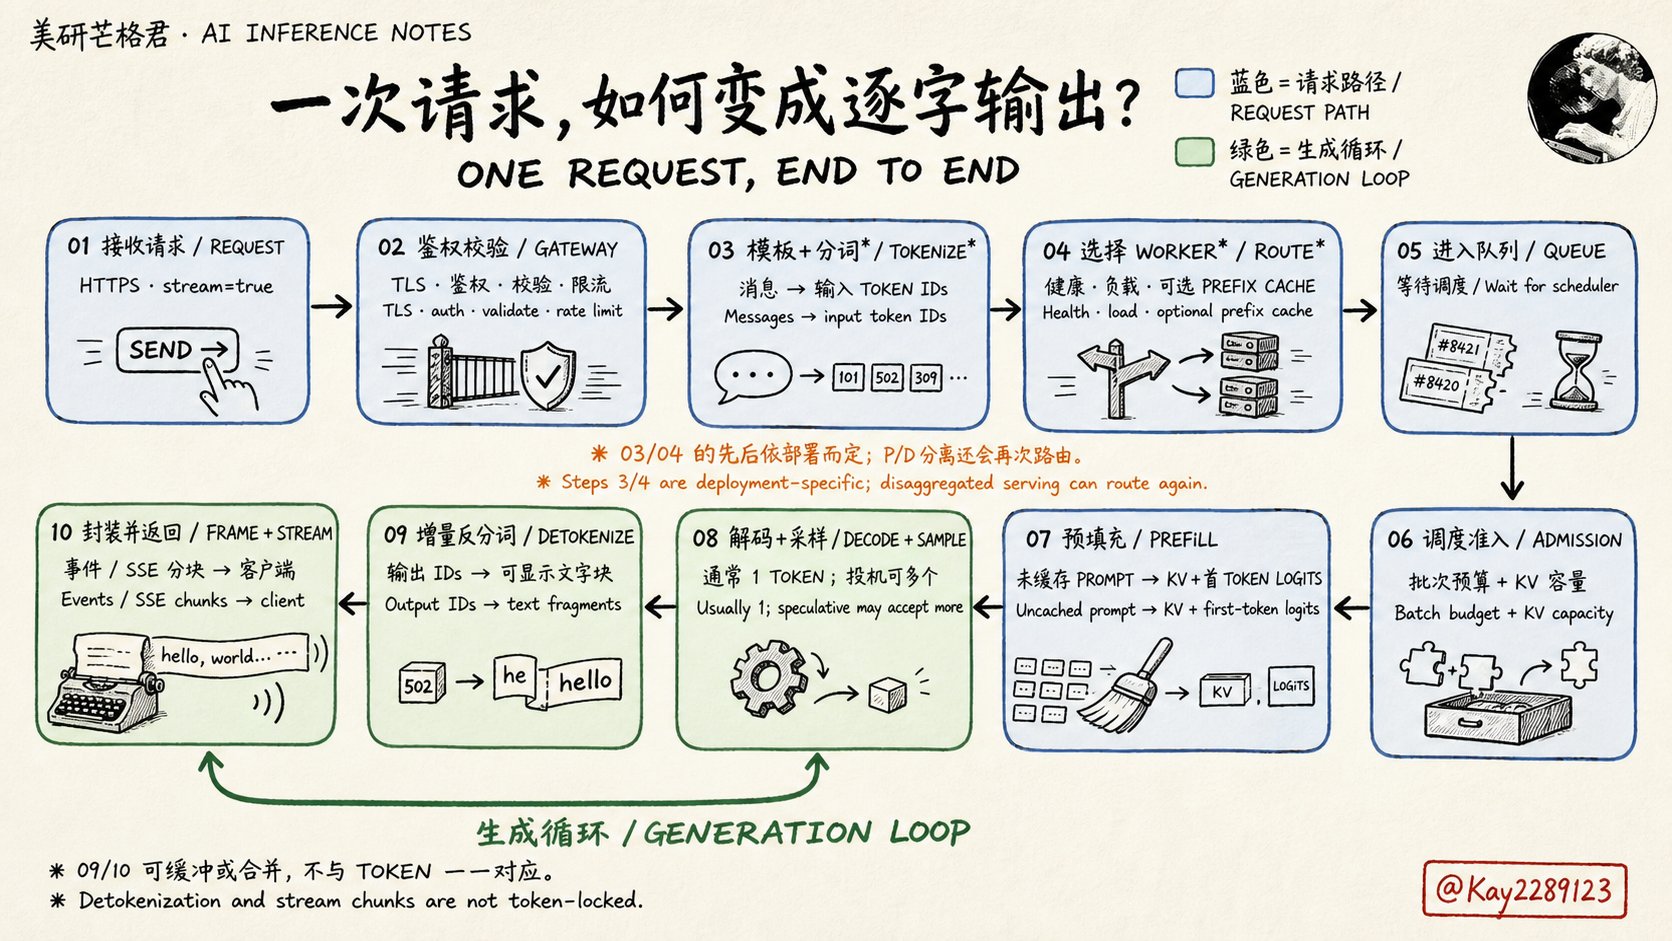
一张图讲清 AI 推理内部流程:从发送请求到首 Token 输出

作者基于在硅谷大厂面试上百人的经验,介绍 AI 推理的完整内部流程:用户发送请求后,需经过 HTTPS 鉴权、模板化分词、路由排队与 KV 容量管理,Prefill 处理完未缓存的 Prompt 后才输出首个 Token,随后进入 Decode + sampling 循环,经增量反分词、SSE 分块返回客户端。作者强调 AI 推理不只是 GPU 速度问题,首 Token 延迟取决于并发排队与 Prefill 的均衡,持续输出取决于 Decode,需优化 KV Cache 以在有限硬件资源下服务更多用户。文中还提到帮团队成员规划了从 SDE 转型 AI infra 的 12 周学习路线。

技术 › LLM 美研芒格君 (@Kay2289123) 2026-08-302.0 KB 57