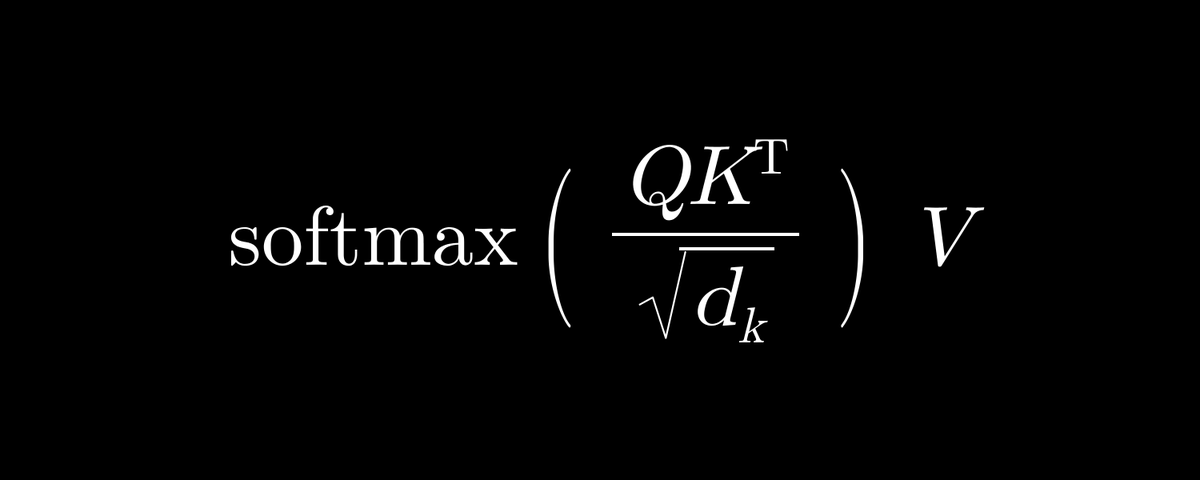
Wiki 知识库

全部文档 / 标签: KV缓存

14 篇
清除

推理是训练的 12 倍,可一块卡生成时只跑出 5% 的算力

文章基于 YC Paper Club 播客,剖析 LLM 推理成本真相:按两年模型寿命摊算,推理总算力约为训练的 12 倍。decode 阶段 MFU 仅 5%,瓶颈在显存带宽而非算力。DeepSeek 通过 KV cache 保留 72 小时、radix attention、零开销调度等手段将缓存命中率做到 96%,实现 38 美元一卡时、80% 毛利。文章还讨论了 SSM 等被低估的模型结构、服务商质量参差(同一模型不同服务商差距超开源闭源差距)以及开源推理生态的规模,指出推理成本优化才是 LLM 竞争的胜负手。

技术 › LLM Saito 2026-10-268.7 KB 140 77

从零开始理解提示缓存(Prompt Caching In Agents)【译】

本文翻译自 Earendil Engineering 的《Prompt Caching In Agents》,系统讲解编程 Agent 中提示缓存的原理与实践。文章介绍了 KV 缓存的工作机制(prefill 与 decode 阶段)、缓存的两种存放方式(会话亲和性与分布式缓存)、前缀匹配对缓存命中的决定性作用,以及显式缓存与自动缓存的区别。还解释了为何修改工具定义会破坏缓存、TTL 过期导致短请求昂贵、缓存未命中的计费代价,以及 Pi 为何保持旧记录稳定而不激进剪枝,帮助读者在上下文、缓存复用、延迟与成本之间取得平衡。

技术 › LLM 小墨同学 2026-10-0726.1 KB 34.7K 89 83

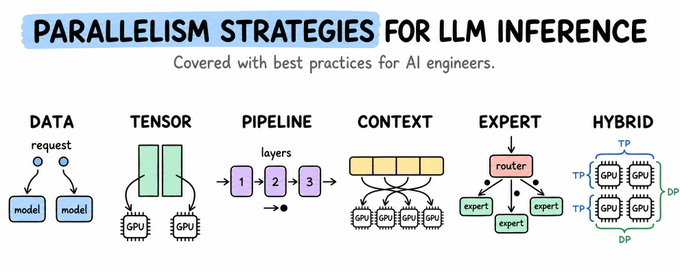
Parallelism strategies for LLM inference, clearly explained

本文系统讲解了 LLM 推理的多 GPU 并行策略。首先介绍推理的两个阶段(Prefill 影响 TTFT,Decode 影响 TPOT)以及部署中的四大资源限制(参数内存、KV-cache、计算、通信),然后通过五个关键问题框架分析各类并行策略:数据并行(复制完整模型、分区请求)、张量并行、流水线并行、上下文并行和专家并行。文章强调选择布局需权衡内存容量、请求延迟和吞吐量,避免通信开销超过硬件承受能力,并给出部署检查规则,帮助读者根据模型、硬件拓扑和工作负载选出合适的布局。

技术 › LLM Avi Chawla 2026-10-0629.4 KB 29.4K 178 82

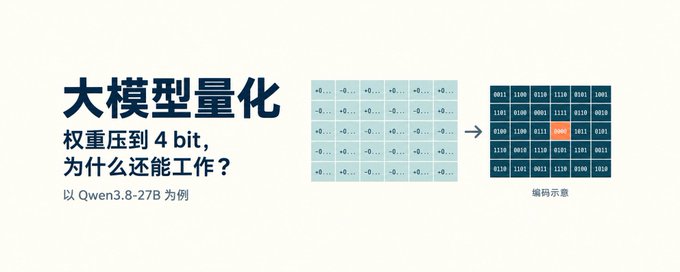
权重压到 4 bit,大模型为什么还能工作?

文章以 Qwen3.8-27B 为例,系统讲解大模型权重量化的原理。从参数如何参与矩阵乘法运算入手,说明 bit 数与编码格式(FP16、BF16、INT4)的关系,演示 0.73 如何被 4 bit 编码为 0.8 并引入误差。深入分析了刻度选择中范围、分辨率与截断误差的取舍,权重误差如何随输入放大为输出误差,以及 GPTQ、AWQ、PTQ、QAT 等量化方法如何利用校准数据控制误差。最后估算 4 bit 模型的存储大小(约 13.5-19 GB),讲解 KV 缓存、混合注意力结构对显存的影响,并给出选择和评估本地量化模型的实用建议。

技术 › LLM gKev1n 2026-10-0511.9 KB 4.9K 36 84

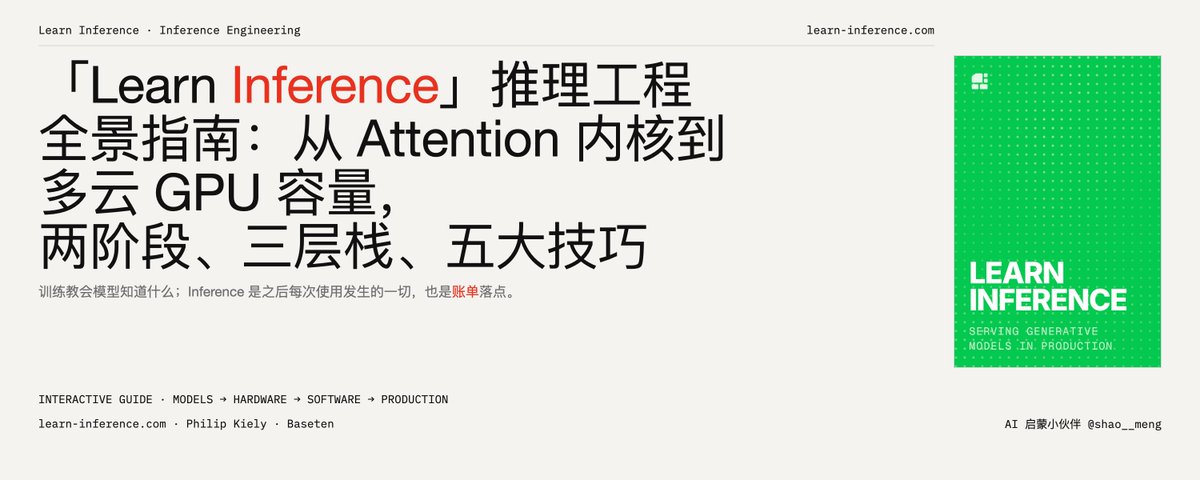
「Learn Inference」LLM 推理工程全景指南:从 Attention 内核到多云 GPU 容量,两阶段、三层栈、五大技巧

本文是 Philip Kiely 所著《Inference Engineering》的交互式伴读站点介绍,系统梳理 LLM 推理工程全貌。文章以 prefill/decode 两阶段为原子结构,按运行时、基础设施、工具链三层展开,逐章讲解模型结构(Attention、KV 缓存、MoE)、GPU 硬件选型(带宽 vs 算力)、软件栈(vLLM、SGLang、TensorRT-LLM)、五大优化技巧(量化、投机解码、缓存、并行、解耦)以及多模态与生产实践(扩缩容、路由、成本、可观测性)。核心思想是:先诊断瓶颈再优化,一切优化皆是权衡,具体知识会过期而底层约束移动缓慢。

技术 › LLM meng shao 2026-09-2918.6 KB 3.4K 11 86

Top AI Papers of the Week (9月21日-9月27日)

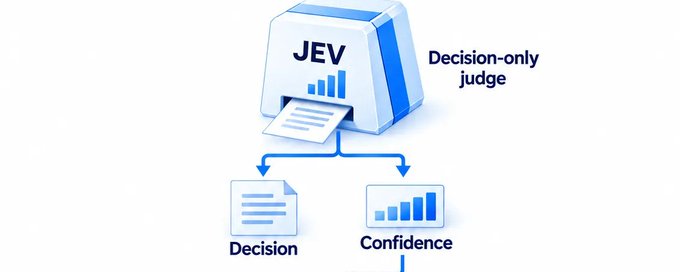
DAIR.AI 每周精选五篇 AI 论文:(1) 小米 MiMo 团队的 HySparse2 混合稀疏注意力架构,通过两级 KV 共享将百万 token 预填充成本降低至原方案的几分之一,同时提升长上下文检索精度;(2) MIT 与 Sakana AI 的 SIFT,用 LLM judge 加 Bradley-Terry 模型替代昂贵基准评估,将自改进智能体搜索成本降至约十分之一;(3) GAVEL 图世界模型,无需改动权重即将小模型长时程机器人任务成功率翻倍;(4) WFM Wiki 基础模型,针对 markdown 链接式长期记忆的图检索;(5) JEV 决策型 judge 模型,成本仅为 GPT-6 的约 1/277。

技术 › LLM DAIR.AI 2026-09-2816.0 KB 37.8K 146 80

越来越值钱的互联:从存储到AI推理这条路,能让GPU少等一会儿,是被95%的人低估了的万亿市场

本文从GPU算力与内存速度不匹配的问题出发,深入分析AI推理中KV缓存的内存占用与复用机制,说明为什么给GPU扩容后计算芯片仍在等待数据。文章以Qwen3-32B为例量化KV缓存大小,比较本地缓存与远端缓存的传输开销,指出连接在缓存共享、跨机器传输中的关键作用。随后分析了铜互连与光互连各自的适用场景,介绍NPO/CPO技术路线,并以Marvell的CXL内存扩容控制器、交换芯片、信号调节芯片和Photonic Fabric为例,梳理连接芯片厂商的商业逻辑与验证进度,最后从客户成本账角度论证互联市场的价值,认为这是一个被低估的万亿级机会。

投资 › 股票 美研芒格君 2026-09-1220.7 KB 15.7K 95 83

DeepSeek V4.1 Flash:架构学习笔记

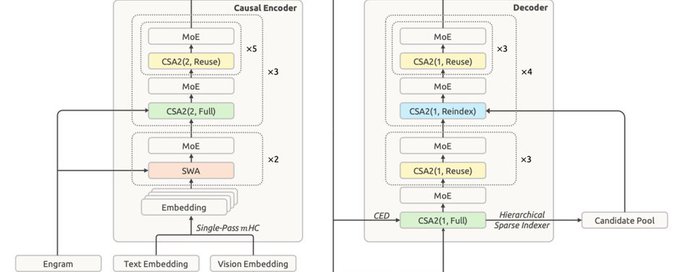
本文是 DeepSeek V4.1 Flash 的架构学习笔记。文章详细解析了其 Causal Encoder-Decoder(CED)结构,该结构通过前后半段网络的不对称计算减少长输入处理成本。核心创新在于 KV 缓存压缩:通过 CSA2 跨层共享全局 KV、FP4 量化、分层稀疏检索以及 SWA 有界回放等设计,将全局 KV 降至约 890 字节/token,持久化缓存约为上一代的 1/8。文章还讨论了这些设计如何协同工作,使长上下文在 Agent 场景下更可负担。

技术 › LLM AI Dance 2026-09-1113.1 KB 21.3K 203 79

The Inference Engineering Skills Map

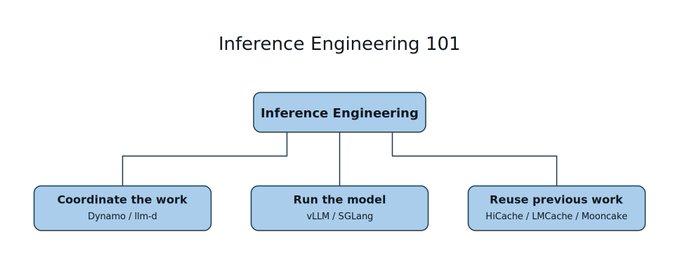
作者从 B2B SaaS Web 开发转向推理工程一个月后分享的入门知识地图。文章将推理工程分为三大类:协调工作(Nvidia Dynamo、llm-d 负责路由、调度与扩展,需智能负载均衡)、运行模型(vLLM、SGLang 处理批处理、张量并行、prefill/decode 分离)、复用先前工作(KV 缓存与 HiCache、LMCache、Mooncake 实现跨 GPU/CPU/NVMe 的分层前缀缓存)。作者强调从 Web 开发转型并不难,不需要精通 CUDA,先跑起模型、发送流量,再逐层深入即可。

技术 › 后端 Nick Khami 2026-09-118.5 KB 17.7K 512 73

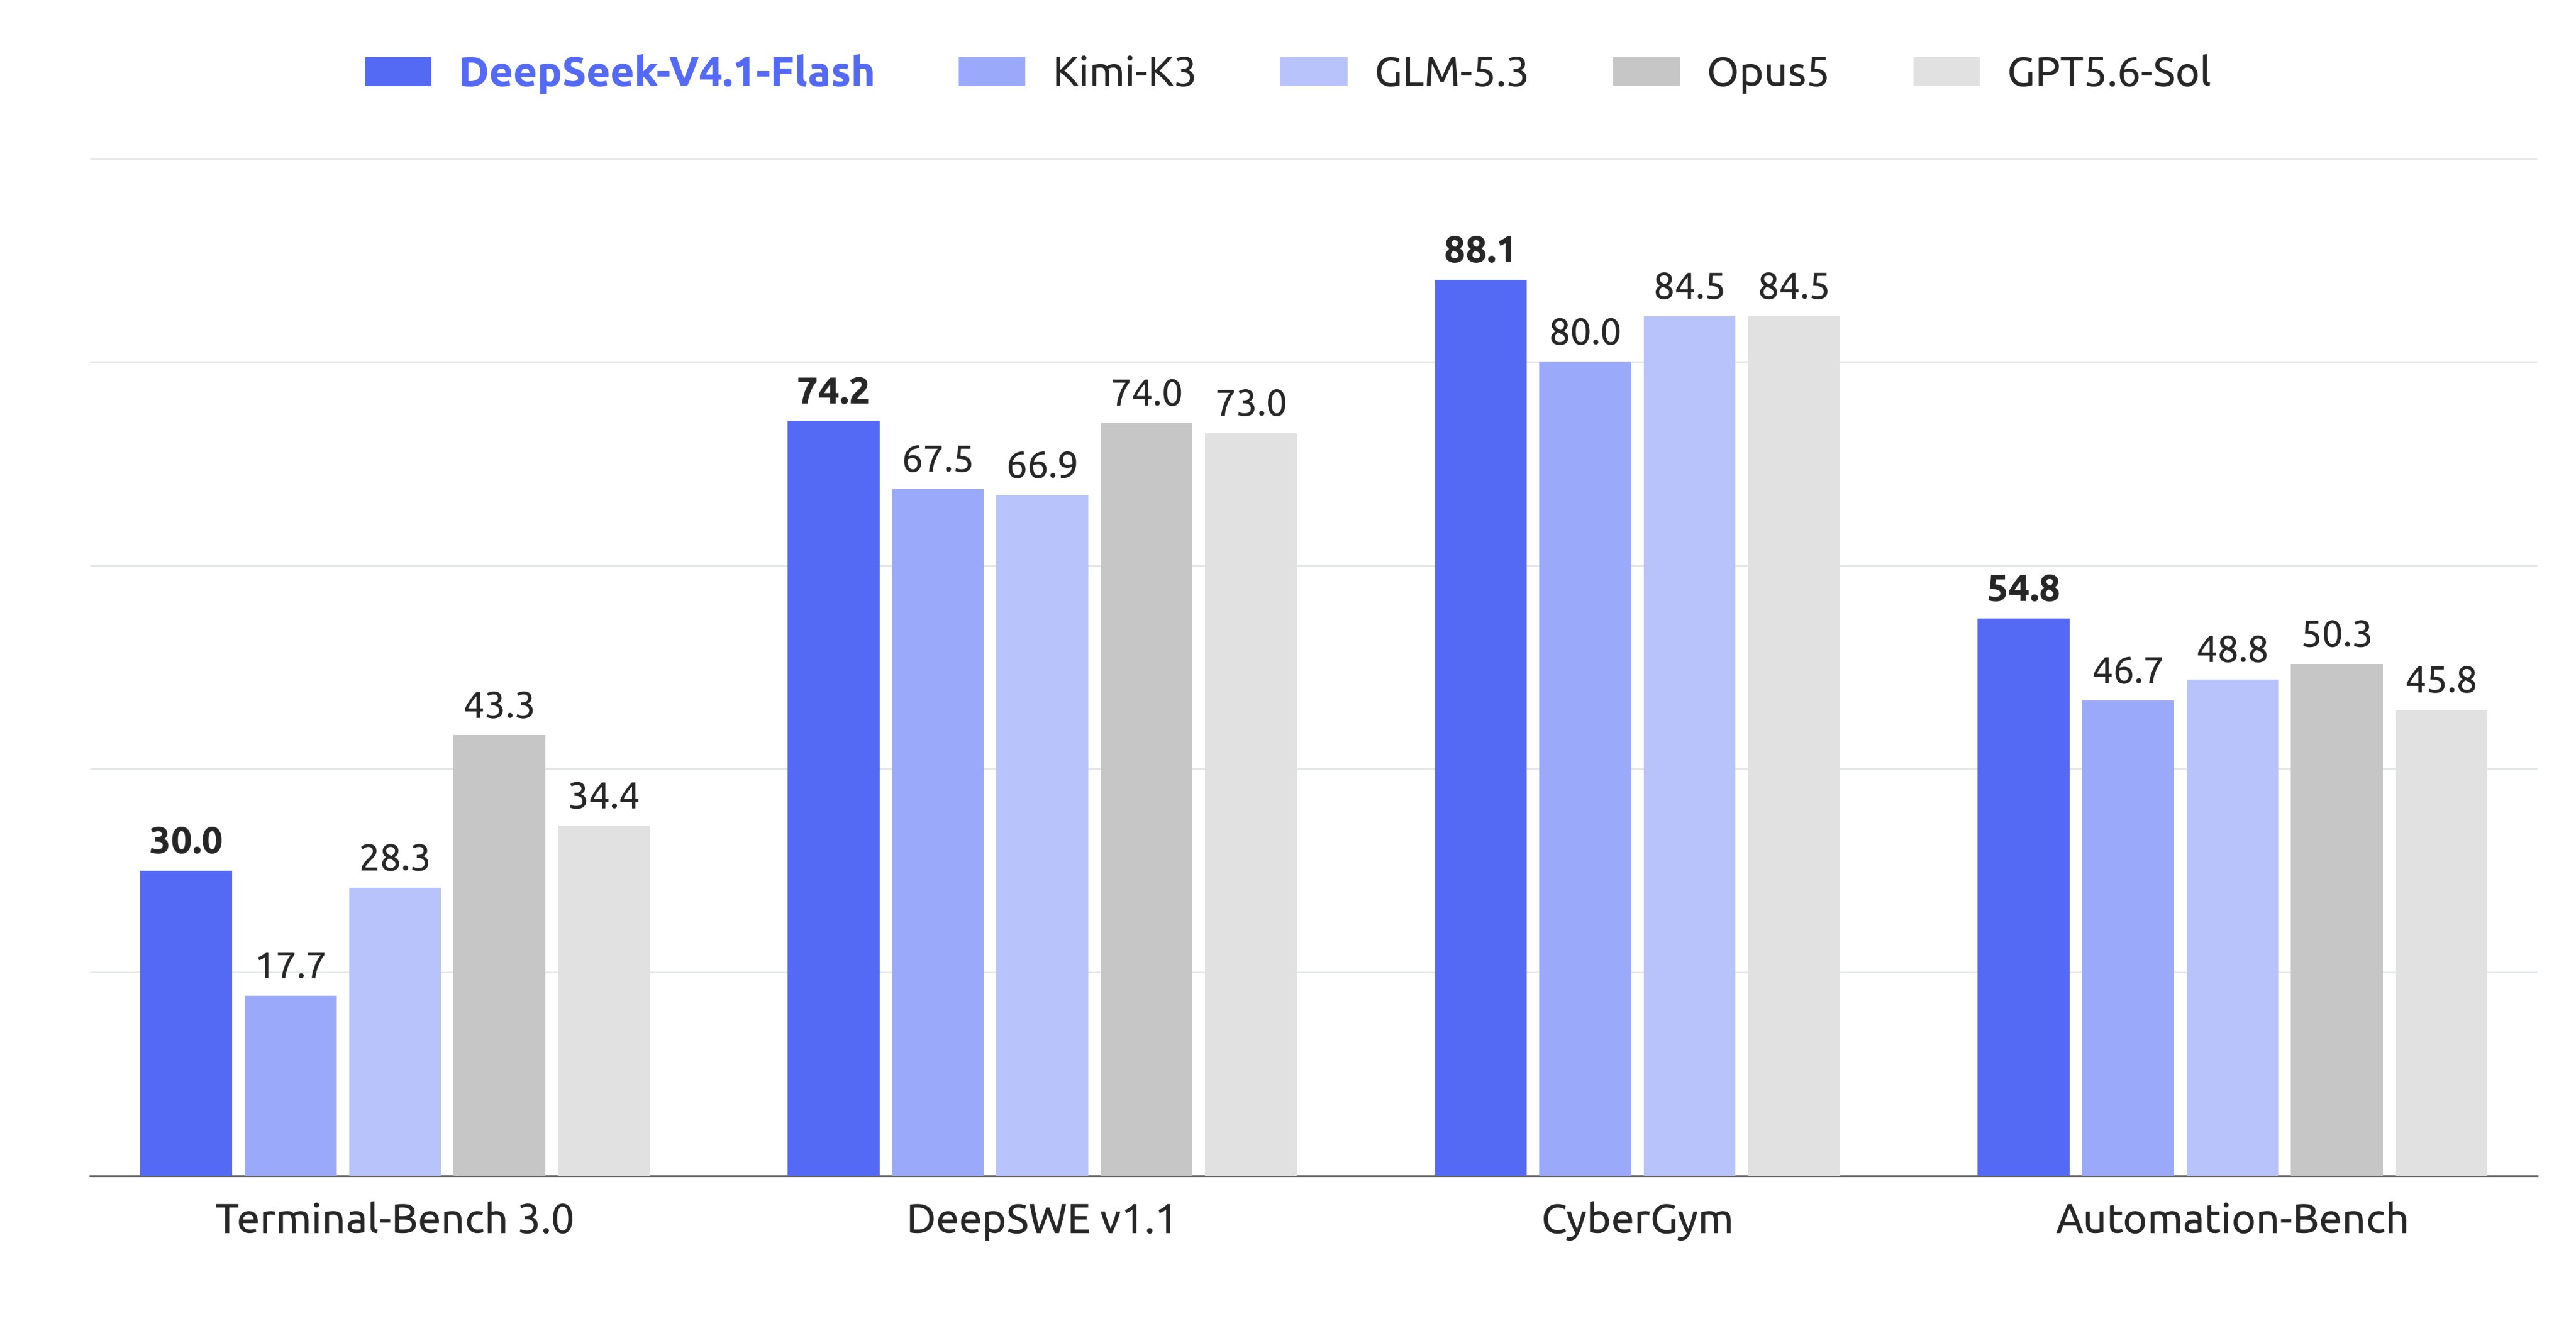
DeepSeek-V4.1-Flash 发布:更聪明、更快速、更高效

DeepSeek 发布新架构家族中最小的模型 V4.1-Flash,具备原生视觉理解能力。该模型采用非对称因果编码器-解码器架构,552B 参数 MoE,仅 8B 激活参数用于输入、16B 用于输出,通过新预训练方法和大规模 RL 后训练,性能超越旗舰模型 V4-Pro。KV 缓存仅需前代 1/4 的 HBM 和 1/8 的 SSD 存储,大幅降低 Agent 成本。模型已上线 DeepSeek API,支持多模态,API 价格下调,非高峰时段费率为峰值的 50%。官方将与开源社区合作推进推理支持,模型已在 HuggingFace 开放。

技术 › LLM DeepSeek (@deepseek_ai) 2026-09-103.3 KB 73

LLM 注意力机制详解:从 Self-Attention 到 MLA

文章系统讲解了 Transformer 中各类注意力机制的演进:从自注意力、因果注意力、交叉注意力的基础概念,到 Multi-Head Attention(MHA)的表达力与显存代价,再到 MQA 通过共享 KV 头缩减缓存、GQA 在质量与内存间取得平衡成为主流、DeepSeek 提出的 MLA 通过低秩潜空间压缩 KV 缓存,以及 FlashAttention 通过改变内存访问方式优化计算效率。核心驱动力是 KV cache 的显存约束:长上下文大模型的注意力状态存储可与模型权重相当。每种机制都是为了解决前一设计的缺陷而诞生。

技术 › LLM Akshay 🚀 2026-09-0513.4 KB 191.5K 577 75

DeepSeek 的 10 万亿美元大战略:技术、算力与国产芯片的未来

本文深入分析了 DeepSeek 如何通过 MLA、MoE、mHC 等一系列底层技术创新,极大幅度降低大模型对 HBM(高带宽内存)和先进 GPU 制程的依赖。文章指出,DeepSeek 的战略并非局限于软件订阅,而是旨在通过算法优化盘活中国产能充足的 NAND 闪存和 LPDDR 产业,以此构建一套独立于西方之外的 AI 硬件生态,最终撬动价值 10 万亿美元的产业巨兽。

技术 › LLM 宝玉 2026-05-2426.0 KB 207.1K 387 82

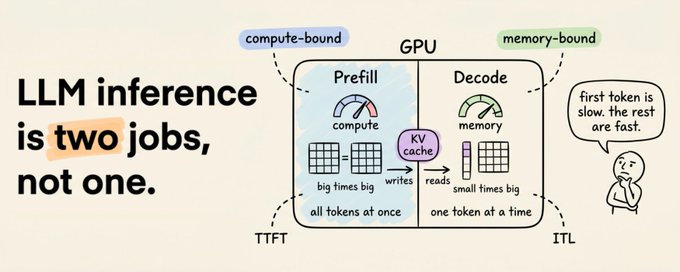
LLM 推理原理:从 Prompt 到流式响应的全流程解析

文章深入剖析了大语言模型(LLM)的推理过程。首先介绍了文本如何通过分词和嵌入转换为向量,接着详细解释了 Transformer 层中的自注意力机制与前馈网络如何协同工作。文章重点揭示了推理过程的两个不同阶段:处理输入时的“预填充”阶段受算力限制,而生成输出时的“解码”阶段受内存带宽限制,这种性能差异导致了首个token与后续token生成速度的不同。

技术 › LLM Akshay 2026-05-0313.8 KB 352.5K 849 71

LLM 中的 KV 缓存机制详解

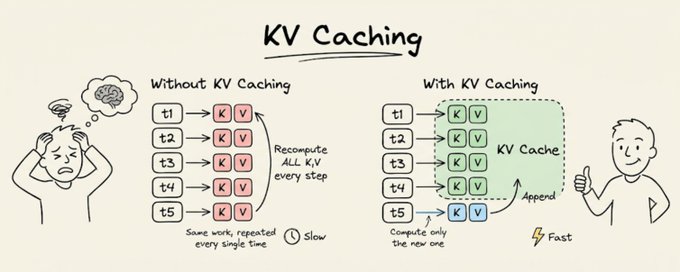
文章深入解释了大型语言模型(LLM)中的 KV 缓存技术。作者指出,LLM 生成文本时首个令牌较慢而后续令牌迅速的现象,归功于 KV 缓存的工程优化。该技术通过存储已计算键值向量,避免在自回归生成过程中的冗余计算,以 GPU 内存为代价换取显著的计算加速。文中详细解析了注意力机制的冗余问题、KV 缓存的工作原理、首令牌延迟(TTFT)的产生原因,以及内存与计算资源之间的权衡取舍。

技术 › LLM Avi Chawla 2026-03-226.3 KB 1.8M 2.9K 69