Wiki 知识库

全部文档 / 标签: AI推理

5 篇
清除

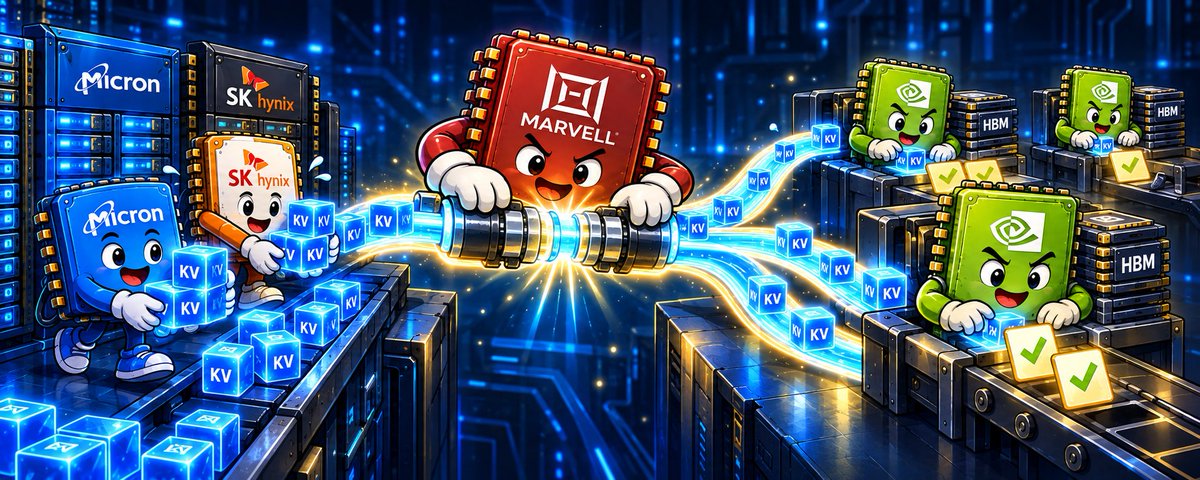
越来越值钱的互联:从存储到AI推理这条路,能让GPU少等一会儿,是被95%的人低估了的万亿市场

本文从GPU算力与内存速度不匹配的问题出发,深入分析AI推理中KV缓存的内存占用与复用机制,说明为什么给GPU扩容后计算芯片仍在等待数据。文章以Qwen3-32B为例量化KV缓存大小,比较本地缓存与远端缓存的传输开销,指出连接在缓存共享、跨机器传输中的关键作用。随后分析了铜互连与光互连各自的适用场景,介绍NPO/CPO技术路线,并以Marvell的CXL内存扩容控制器、交换芯片、信号调节芯片和Photonic Fabric为例,梳理连接芯片厂商的商业逻辑与验证进度,最后从客户成本账角度论证互联市场的价值,认为这是一个被低估的万亿级机会。

投资 › 股票 美研芒格君 2026-09-1220.7 KB 15.7K 95 83

The Math Needed for AI Inference Engineering (Complete Roadmap)

本文系统梳理了AI推理工程所需的核心数学知识路线图。内容涵盖:浮点数表示(FP32/FP16/BF16/FP8/INT8等格式的位分配与精度/范围权衡)、舍入误差累积、溢出与下溢、机器epsilon、灾难性消除及稳定softmax与log-sum-exp技巧;量化数学,包括scale与zero-point线性映射、对称/非对称量化、粒度选择、范围裁剪、激活离群值处理及基于Hessian的曲率方法;以及线性代数计算成本分析,如矩阵乘法的浮点运算量与内存读写开销估算。作者强调在性能分析前能手算层耗时是推理工程中最有价值的习惯。

技术 › LLM vixhaℓ 2026-09-0827.9 KB 93.1K 870 85

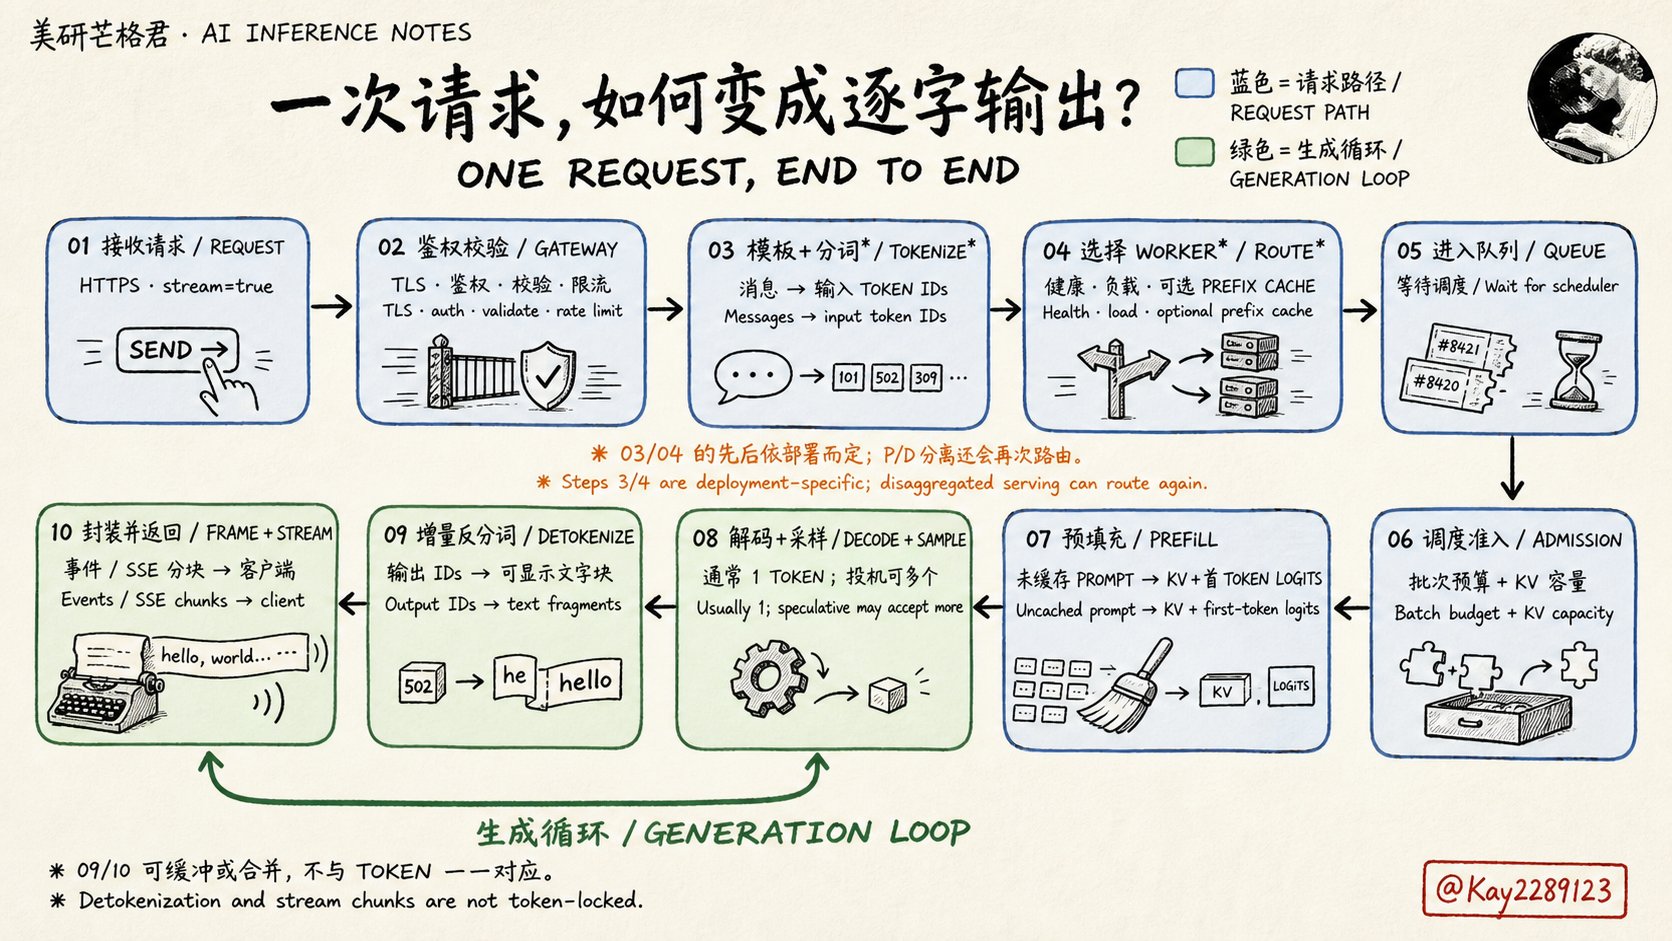
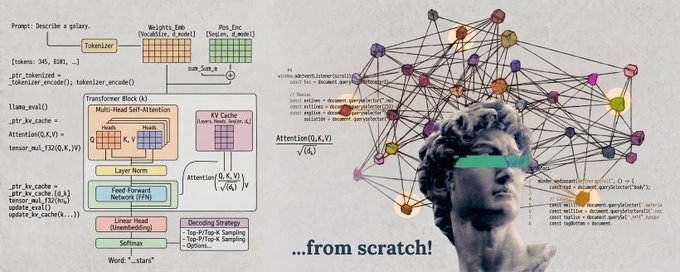
一张图讲清 AI 推理内部流程:从发送请求到首 Token 输出

作者基于在硅谷大厂面试上百人的经验,介绍 AI 推理的完整内部流程:用户发送请求后,需经过 HTTPS 鉴权、模板化分词、路由排队与 KV 容量管理,Prefill 处理完未缓存的 Prompt 后才输出首个 Token,随后进入 Decode + sampling 循环,经增量反分词、SSE 分块返回客户端。作者强调 AI 推理不只是 GPU 速度问题,首 Token 延迟取决于并发排队与 Prefill 的均衡,持续输出取决于 Decode,需优化 KV Cache 以在有限硬件资源下服务更多用户。文中还提到帮团队成员规划了从 SDE 转型 AI infra 的 12 周学习路线。

技术 › LLM 美研芒格君 (@Kay2289123) 2026-08-302.0 KB 57

如何在 AI 领域赢得最大市场

文章探讨了计算历史上的专业化趋势,指出 AI 推理需求正在爆发,通用 GPU 已无法满足其对内存和能效的特定要求。文中以 Google 的 TPU 为例,介绍了定制化硬件的兴起。重点分析了初创公司 Etched 如何押注专用推理芯片,通过低电压推理和集群级内存技术,试图解决算力与能耗问题,抢占这一巨大的市场份额。

技术 › 芯片 Sarah Wang 2026-07-2410.2 KB 61.7K 192

ActiveGraph: 长期运行 Agent 的连续性架构层

文章作者 Yohei 提出了 ActiveGraph 的概念,旨在解决长期运行 AI Agent 的状态连续性问题。作者回顾了 BabyAGI 的发展历程,指出当前 Agent 系统主要围绕“反应”构建,缺乏持续的状态管理。ActiveGraph 试图将任务、记忆、决策、证据等所有状态视为一个共享的演化图,从而实现 Agent 的持久化、自我修正和逻辑追溯,适用于需要严格推理过程的企业级场景。

技术 › Agent Yohei 2026-05-209.6 KB 54.7K 151 68