Tiny Tapeout做你人生的第一颗开源芯片
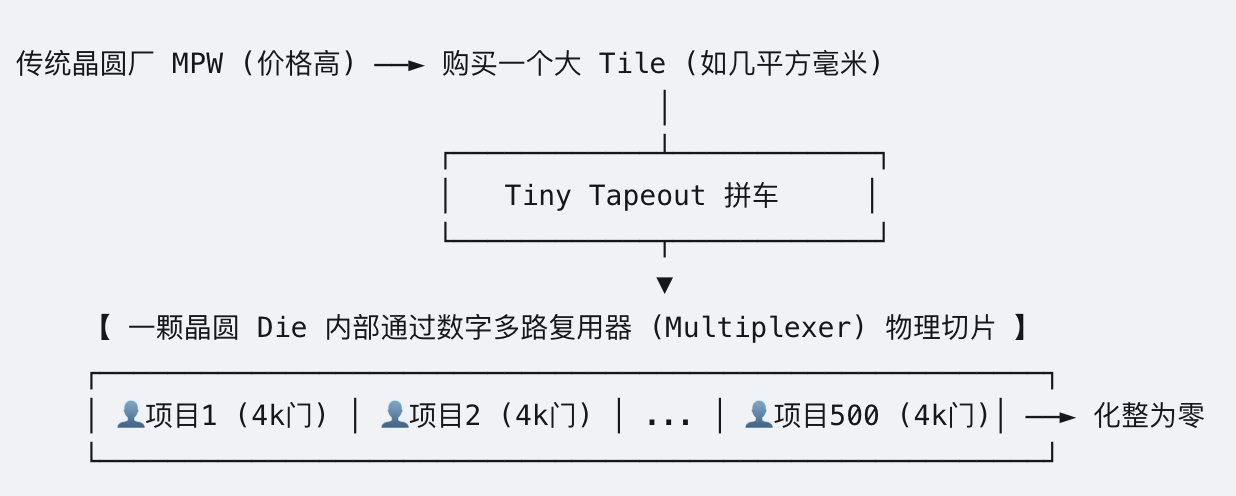
Tiny Tapeout 将流片成本从数万至数百万美元降低到约300美元,让普通工程师、学生和创客也能拥有自己的定制芯片。它向 GlobalFoundries、IHP、SkyWater 等晶圆厂购买芯片格子,切分成几百个微型单元(每个约4k逻辑门),数百个设计共享同一块硅晶片和24个IO引脚。受限于面积,适合做8位CPU、加密算法、VGA生成器等概念验证。文章称其为众筹拼车模式在芯片制造上的完美应用,正重塑微电子教育的门槛。
Tiny Tapeout 将流片成本从数万至数百万美元降低到约300美元,让普通工程师、学生和创客也能拥有自己的定制芯片。它向 GlobalFoundries、IHP、SkyWater 等晶圆厂购买芯片格子,切分成几百个微型单元(每个约4k逻辑门),数百个设计共享同一块硅晶片和24个IO引脚。受限于面积,适合做8位CPU、加密算法、VGA生成器等概念验证。文章称其为众筹拼车模式在芯片制造上的完美应用,正重塑微电子教育的门槛。
Google 宣布进一步推进 Coral NPU 边缘 AI 硬件方案,发布完整的开放硬件蓝图、编译器工具以及由 Synaptics 等合作伙伴推出的商用芯片。传统芯片因数据在存储与计算间来回搬运而消耗大量电能,Coral NPU 通过在数据所在位置完成计算,大幅降低功耗,让智能手表、可穿戴设备、传感器和家庭机器人等小型设备具备强大 AI 能力。统一开放的硬件标准与软件工具链解决了边缘 AI 开发中各设备规范不一的难题,为下一代低功耗智能设备奠定基础。
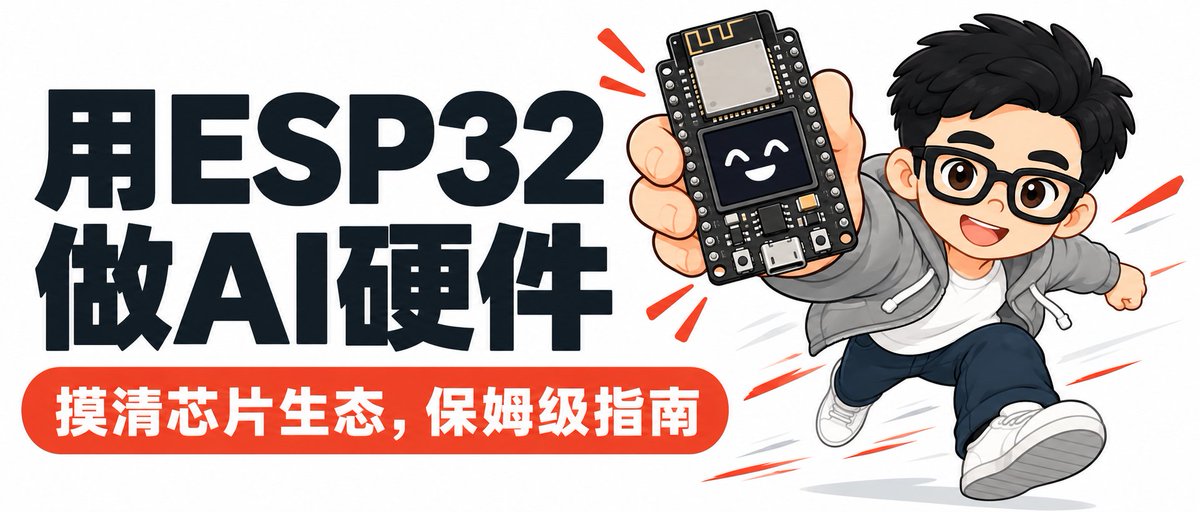
作者在无硬件知识背景下,借助 Claude Code 等 AI 工具为 ESP32 开发板制作了多套固件,遇到 ESP32-C3 单核性能瓶颈后系统调研了 ESP32+AI 生态。文章介绍了小智 AI、StackChan、SenseCAP Watcher、ESP-Hi 机器狗等开源项目,讲解了 ESP32-C3/S3/P4 三款主力芯片的差异与选型要点,梳理了乐鑫芯片发展时间线,并按随身穿戴、视觉、语音对话、桌面机器人、屏幕游戏等场景给出保姆级硬件挑选指南。作者计划下一步打造一款带屏幕的桌面实体 Agent 交互终端。
本文是硅谷101 Alignment 峰会 Day 2 上午的深度笔记,提出 AI 繁荣背后有三张物理账单:电、芯片、推理。 Session 1 指出美国输电网难以建设,行业转向表后发电,从签约到出 token 需 16-17 个月,电力成为算力交付的真正瓶颈;讨论了数据中心融资期限错配、neocloud 风险、云业务利用率本质及算力短缺将持续到 2030 年的预测。 Session 2 探讨半导体,揭示 2nm 只是名义数字、硅在 5nm 以下到物理极限,AI 进晶圆厂第一站是良率检测,价值最终流向制造端。 Session 3 讲述在买不到新卡的情况下,通过推理优化软件从现有 GPU 榨取更多性能。核心结论:三张账单的解法都是效率。
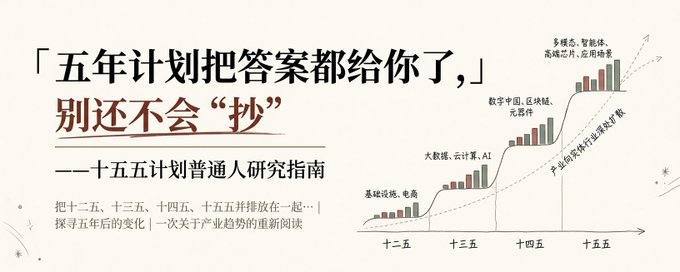
作者通过对比十二五到十五五四份五年规划,提出阅读五年规划的正确方法:不是搜索关键词找利好,而是纵向对比同一产业在不同规划中的演变。文章以互联网、平台经济、人工智能为例,展示数字经济如何从基础设施与电商工具升级为数字中国战略,政策措辞从鼓励发展转向规范监管时对估值的影响,以及AI产业链的细化拆解。核心观点:五年规划应被当作产业变化时间轴,用来确定未来值得重点研究的产业方向,而非直接指导买哪只股票。
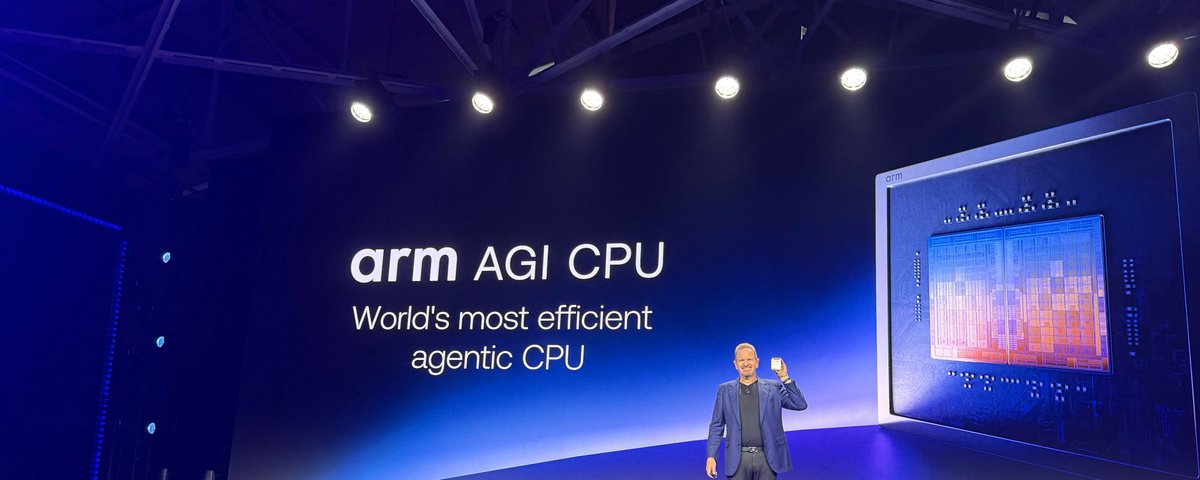
文章分析ARM从技术授权转向直接销售芯片的战略逻辑。ARM与Meta联合开发AGI CPU,瞄准AI智能体对CPU的强劲需求——智能体需打开网页、运行代码、调度任务,CPU成为瓶颈。Meta为深度合作伙伴,甲骨文、字节跳动火山引擎、OpenAI均已采购,谷歌也在新AI系统中用ARM替代x86。客户需求半年内从10亿美元上调至20亿美元以上。直接卖芯片可让ARM每颗芯片贡献从50美元提升至500美元,扩大十倍。Jefferies预计2031财年销售额达180亿美元,ARM自定目标150亿美元,对应利润可达当前全公司水平的两倍多。
李飞飞宣布其创办的空间智能公司 World Labs 将加入 AMD,她本人将出任 AMD 执行副总裁兼首席科学家。文章回顾了她自 2000 年进入 AI 领域以来的历程,包括 ImageNet、Google Cloud AI 和斯坦福 HAI 的工作,以及 2024 年与 Ben Mildenhall、Justin Johnson 共同创立 World Labs,专注空间智能与物理世界推理。公司发布了 Atlas 模型,解决了新视角预测等关键问题。她认为与 AMD 的软硬件整合能加速 AI 解决药物研发、机器人等现实问题,并以'寻求新世界'表达对未来的期待。
文章整理了黑石集团总裁兼COO Jon Gray面向100多位全球顶级投资者闭门演讲的10个核心观点。Gray认为当前AI浪潮更接近1870年工业革命的开端而非2000年互联网泡沫:Anthropic和OpenAI等模型公司收入一年增长100倍达1050亿美元;黑石投资的14家AI公司收入增长21倍至5.25亿美元;超大规模数据中心资本开支达8200亿美元,占美国GDP的2.5%。他指出真正的瓶颈在芯片、电力和数据中心等物理世界,黑石押注技术栈最底层的计算、电力与土地,追求确定性回报。
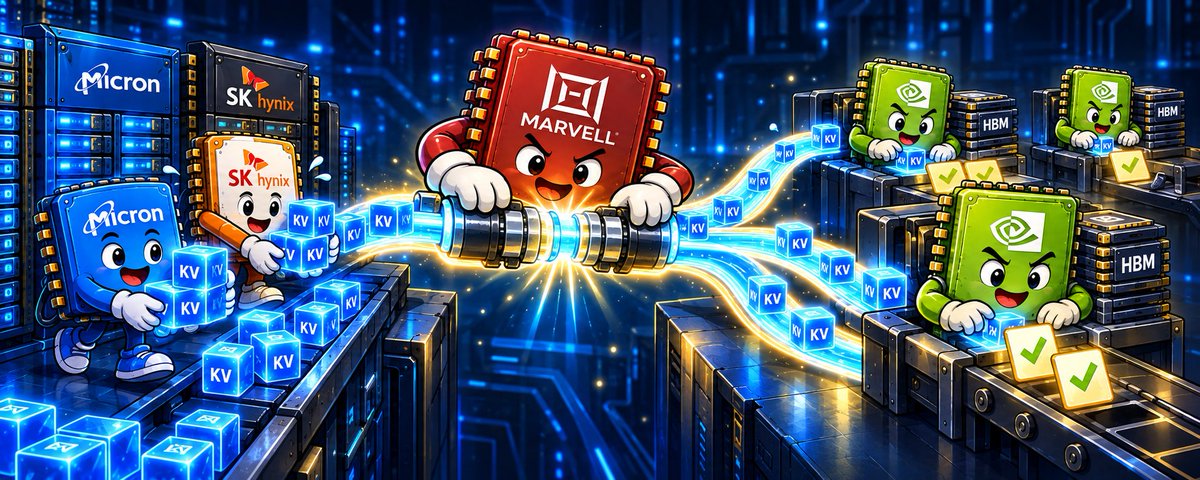
本文从GPU算力与内存速度不匹配的问题出发,深入分析AI推理中KV缓存的内存占用与复用机制,说明为什么给GPU扩容后计算芯片仍在等待数据。文章以Qwen3-32B为例量化KV缓存大小,比较本地缓存与远端缓存的传输开销,指出连接在缓存共享、跨机器传输中的关键作用。随后分析了铜互连与光互连各自的适用场景,介绍NPO/CPO技术路线,并以Marvell的CXL内存扩容控制器、交换芯片、信号调节芯片和Photonic Fabric为例,梳理连接芯片厂商的商业逻辑与验证进度,最后从客户成本账角度论证互联市场的价值,认为这是一个被低估的万亿级机会。
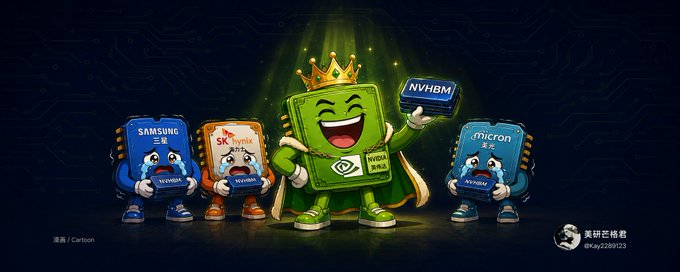
文章解析英伟达8月26日发布的NVHBM技术:将自研内存控制器移入HBM底座,带宽最高提升30%、功耗降低15%,并推动多家内存厂商共同供货。作者对比三星zHBM(Memory-on-Logic垂直堆叠)与SK海力士的3D堆叠、混合铜键合路线图,拆解内存厂商的利润公式:出货量×份额×单位毛利,指出NVHBM可能压缩独有设计溢价、提升制造能力与良率的重要性。对三星的机会在于进入更多采购名单,海力士则需证明客户有得选时仍选自己。行业增长未必等于每家公司都受益。
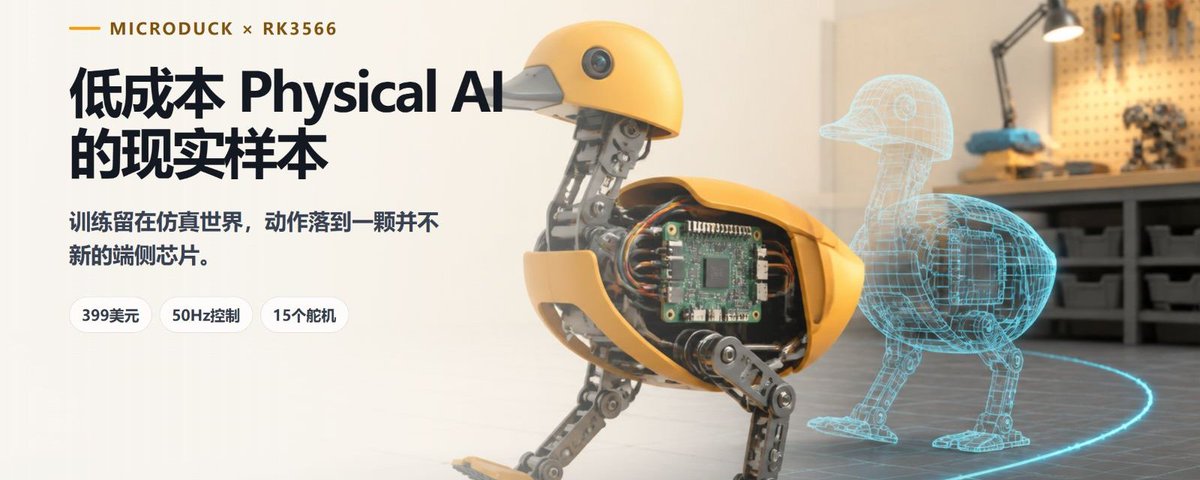
文章通过开源机器鸭项目Microduck(售价399美元,基于RK3566芯片运行神经网络策略控制15个舵机)切入,指出瑞芯微正从消费电子SoC厂商转型为端侧AI部署平台。作者用GitHub数据分析:rknn-toolkit2、rknn_model_zoo、rknn-llm三大AI工具链仓库两年Star数增长约322%,远超传统项目;Hugging Face上RK3588相关模型96.9%创建于近两年。瑞芯微恰好位于MCU与英伟达Jetson之间的算力断层带,适合门禁、机器人、会议终端等海量中端设备。文章同时提醒Star不等于收入、RKNN3工具链不兼容等风险,认为瑞芯微无需击败英伟达,只需拿下低成本端侧智能市场。
a16z 宣布筹集 11 亿美元设立「机器时代基金」,聚焦 AI 物理基础设施的全面重构。文章指出 AI 从聊天到推理再到编码的演进使算力需求呈指数级增长,机架算力密度提升 28 倍,功率从 5-10 kW 升至 250 kW 并将在三年内达 1MW,数据中心迈向 GW 级别。该基金将投资芯片、内存、网络、存储、数据中心、机器人等全栈基础设施。a16z 强调硬件是其团队基因,已投资 Skydio、SpaceX、Anduril、Waymo 等公司,如今正式将硬件投资作为核心战略方向。
文章分析了2026年顶尖独立VC机构的投资动向,指出资本正从浅层应用转向硬基建、物理世界和深垂直领域。通过分析赛道年龄、轮次和具体公司(如Atoms、Etched、Cognition等),揭示了AI创业窗口正在收窄,而推理芯片、机器人、企业Agent及特定垂直工作流成为投资热点。
文章探讨了计算历史上的专业化趋势,指出 AI 推理需求正在爆发,通用 GPU 已无法满足其对内存和能效的特定要求。文中以 Google 的 TPU 为例,介绍了定制化硬件的兴起。重点分析了初创公司 Etched 如何押注专用推理芯片,通过低电压推理和集群级内存技术,试图解决算力与能耗问题,抢占这一巨大的市场份额。
文章详细梳理了人工智能的工程基础,回顾了从GPU游戏显卡到英伟达CUDA生态建立的历史,解析了其技术护城河。同时指出2026年硬件格局的松动,分析了谷歌TPU的回归与AWS自研芯片的崛起,展示了英伟达在推理领域面临的竞争态势。
本文深度解析了华为在ISCAS 2026上发布的“韬定律”,这是中国半导体产业首次提出指导发展的新原则。文章指出,面对摩尔定律失效和外部制裁,华为通过“逻辑折叠”技术和“时间缩微”路径,试图在不依赖EUV光刻机的情况下,实现芯片性能的代际跨越。文章还详细介绍了麒麟9050及灵衢总线的战略意义,分析了华为从“跟随者”向“规则制定者”的转变。
本文深入分析了 DeepSeek 如何通过 MLA、MoE、mHC 等一系列底层技术创新,极大幅度降低大模型对 HBM(高带宽内存)和先进 GPU 制程的依赖。文章指出,DeepSeek 的战略并非局限于软件订阅,而是旨在通过算法优化盘活中国产能充足的 NAND 闪存和 LPDDR 产业,以此构建一套独立于西方之外的 AI 硬件生态,最终撬动价值 10 万亿美元的产业巨兽。
本文分享了一份关于英伟达(NVIDIA)AI 生态系统的深度研报。作者指出该报告制作成本高昂且数据经过多次校准,认为是近期最具“钱途”的高质量研究。报告重点分析了英伟达在 AI 领域的生态布局,旨在为准备或已投资 AI 领域的投资者提供有价值的参考。
文章整理了一份2026年科技圈的高频缩写表,涵盖AI算力、服务器硬件、网络互联、存储及模型架构等核心技术领域。通过通俗解读GPU、ASIC、CPO、LPO、MoE等关键术语,揭示了AI产业链的底层逻辑与未来技术演进方向。
黄仁勋在2.4万字访谈中深入探讨了Nvidia的定位与护城河,反对AI取代就业论,强调智能体将指数级增长。他回顾了错失Anthropic投资的遗憾,解释为何不涉足云服务,并针对中国芯片限制提出“五层蛋糕”论,认为电力可弥补工艺差距,断供将迫使中国建立独立技术栈。