Wiki 知识库

全部文档 / 作者: 青稞社区 / 标签: LLM

4 篇
清除

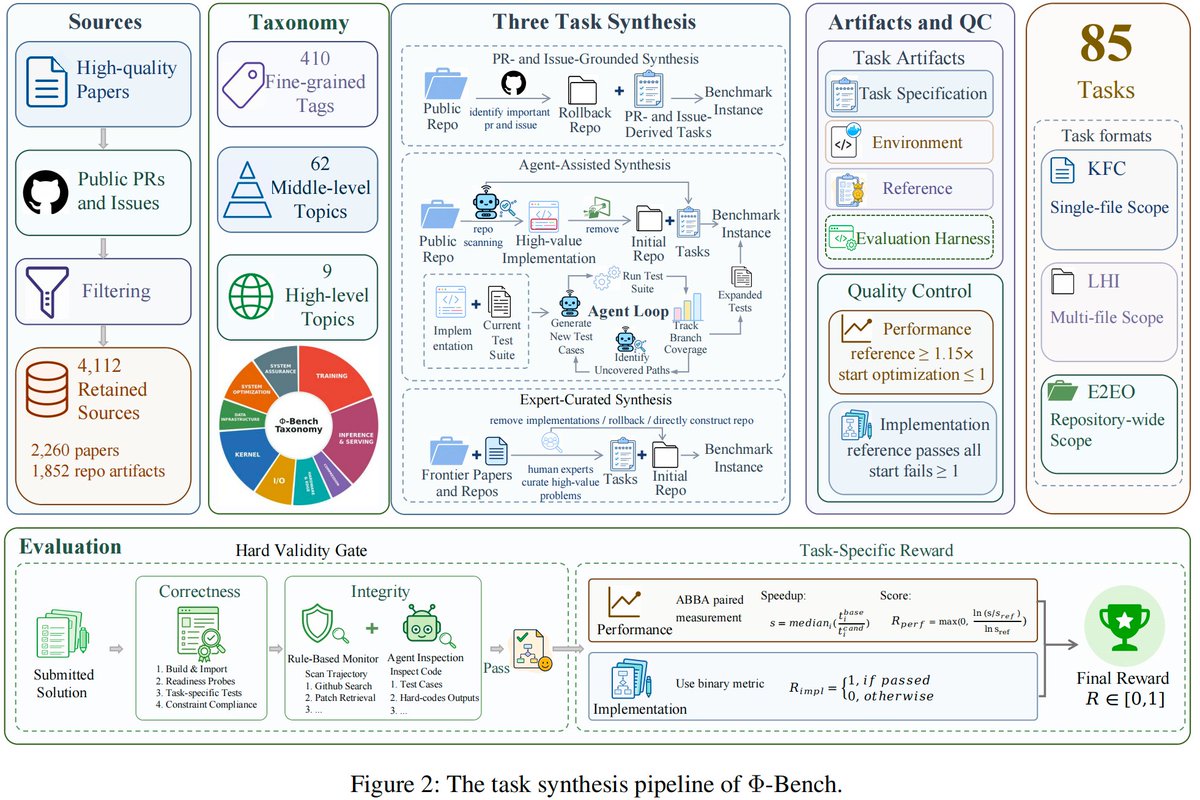
Φ-Bench 深度评测:大模型距离 AI 工程师还有多远

本文介绍 Φ-Bench(Frontier AI Infrastructure Benchmark),一个评估 LLM 基础设施工程能力的基准。它从顶会论文和开源仓库中筛选出 85 个真实高难度任务,分为 Kernel 补全(KFC)、长周期实现(LHI)和端到端优化(E2EO)三类。评测结果显示 Claude Opus 5 以 36.53 分领先,但所有模型在理解大型代码库和硬件相关优化上仍明显不足。分析指出优秀模型需具备假设验证、实验设计和可靠归因能力,Φ-Bench 探索了 AI 自我改进能力向基础设施层延伸的可能性。

技术 › LLM 青稞社区 2026-08-249.6 KB 1.5K 10 66

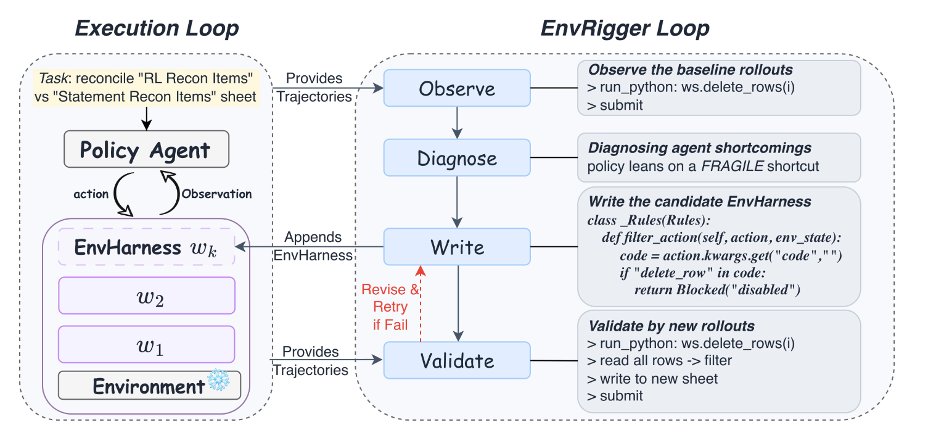
Google提出EnvHarness:环境自进化,倒逼Agent持续进化

Google提出EnvHarness(环境脚手架)框架,通过Stage、Contract、Chain三类组件在不改动环境底层的情况下动态操控环境,并引入环境搭建师EnvRigger,通过观察Agent轨迹、诊断缺陷、编写组件、实战验证的四步闭环自动搭建环境。在SWE-bench Verified基准上,Agent与环境实现螺旋式协同进化,成功率从47.67%提升至54.79%,且300个环境时性能仍持续上升。未来方向包括扩展组件库、拓展至非文本环境及探索语义化组合。

技术 › Agent 青稞社区 2026-08-228.6 KB 4.8K 37 74

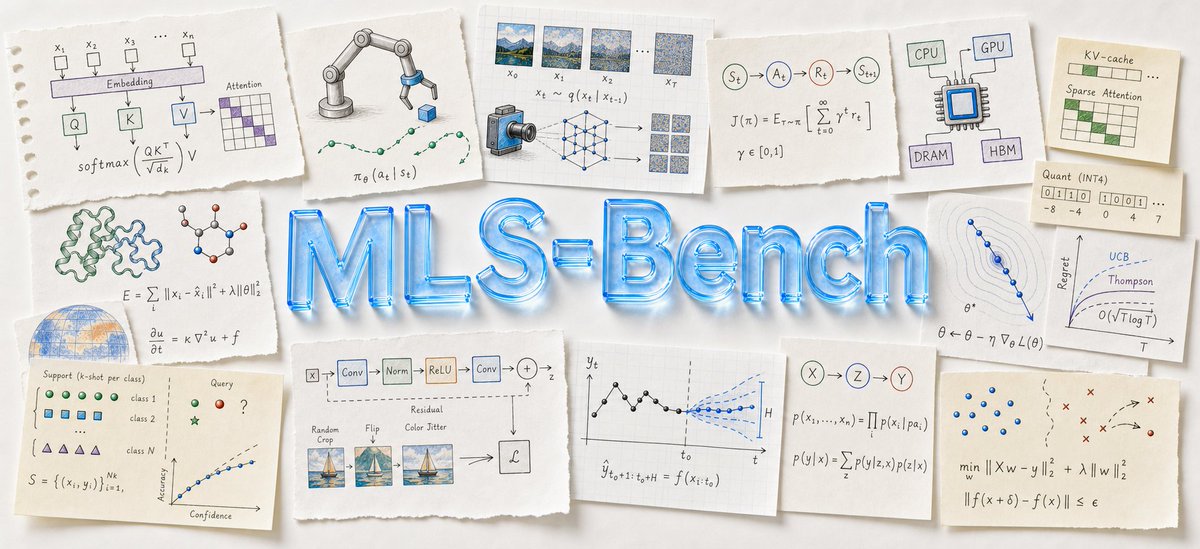
MLS-Bench:AI自进化假象的硬核测试

本文介绍了MLS-Bench基准测试,该测试旨在评估AI系统在机器学习研究中的方法发现能力,而非仅仅是工程执行能力。MLS-Bench包含12个领域、140个真实研究任务,通过控制可修改范围、复现强人类基线、跨条件验证等设计,将算法贡献与调参、容量等因素分离。实验表明,当前AI模型即使经过多轮迭代,也主要是在优化和组合现有组件,未能发现新机制,且在实验规划和论证判断方面表现不足。文章指出,真正的科学发现需要方法提出、实验设计、预算分配、证据判断等综合能力,而当前模型尚未具备。MLS-Bench已被Kimi K3、Qwen3.8-Max等模型官方评测采用,成为衡量AI研究能力的新前沿。

技术 › LLM 青稞社区 2026-08-1417.6 KB 3.5K 9 74

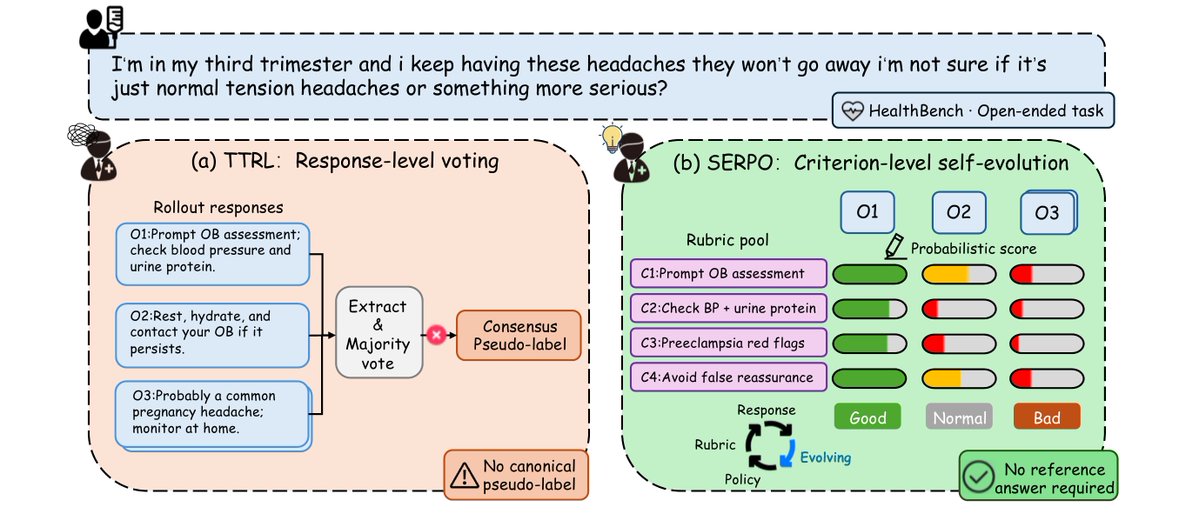
模型部署后的无标注自进化:SERPO机制解析

现有无标注强化学习(TTRL)多依赖多数票生成伪标签,难以处理医疗建议等复杂开放式任务。为此,文章提出SERPO(自进化判据策略优化)机制。它通过模型自身采样的回答提取质量判据生成奖励,无需任何外部监督或人工标注,并将收益直接写入模型权重。实验表明,SERPO不仅大幅提升了模型在垂直领域的性能,且在OOD测试和长程训练中持续进化,证明了其能将质量标准转化为持久的模型能力。

技术 › LLM 青稞社区 2026-08-1018.5 KB 2.7K 16 87