Wiki 知识库

全部文档 / 作者: Cloris / 标签: Eval

3 篇
清除

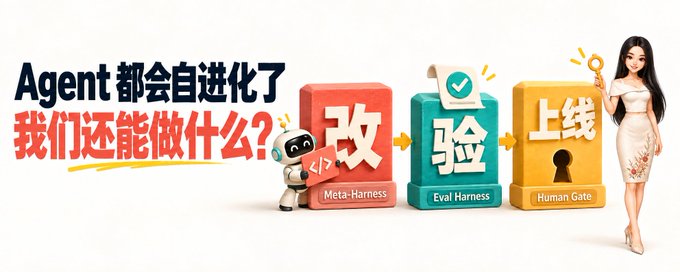
Agent 都会自进化了,我们还能做什么?

文章探讨了 Agent 自动改进系统(Meta-Harness)的构建方法。核心问题是如何让 Agent 自动进步又无法伪造进步。作者提出将三种权力拆开:Agent 负责提出修改,评测系统负责拿证据,上线门禁决定是否升级。文章通过一个补货建议 Demo,演示了从失败记录到修改验证的完整闭环,包括锁定 Agent 不可修改的文件(密封考题、评分器、上线标准)、生成结构化故障单、构建逐层收窄的评测漏斗等实践。同时分析了 Agent 容易刷分的三种捷径:讨好评分器、记住考题、自己宣布通过,并指出 Meta-Harness 只在基础 Eval 成熟、人工改进成为瓶颈时才值得搭建。

技术 › Agent Cloris 2026-09-1817.5 KB 85.7K 127 84

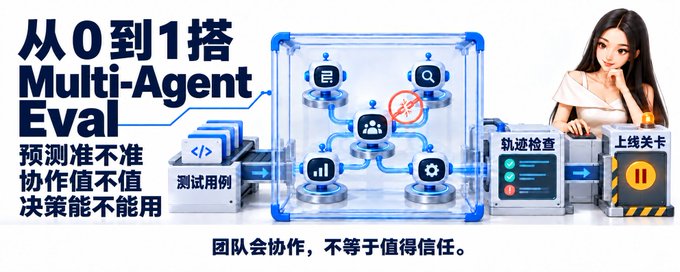
从 0 到 1 搭 Multi-Agent Eval:预测准不准,协作值不值,决策能不能用

本文介绍如何为多 Agent 团队搭建评估体系,以电商场景为例,通过五步流程:设计含陷阱的测试用例、保存 trace 回放协作过程、用结果/协作/决策三张成绩单分别评分、与单 Agent 及重试基线在同等预算下对比、将失败案例加入回归集。文章强调交接信息完整性、冲突解决、角色消融与协调增益等关键检查点,并给出可直接运行的最小 harness 代码示例。

技术 › Agent Cloris 2026-09-1119.0 KB 43.9K 84 83

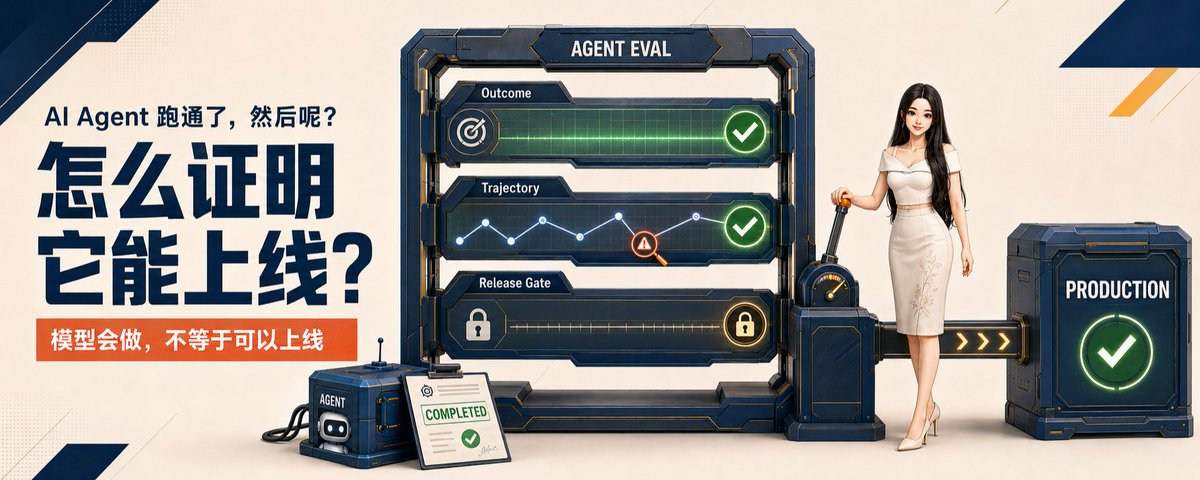
AI Agent 跑通了,怎么证明它真的可以上线?

文章指出 Agent 最危险的失败不是报错,而是做错了却显示"已完成"。作者以一个资料研究 Agent 为例,搭建了一套最小可用的 Agent 评测框架,回答三个问题:任务有没有做成、失败发生在哪里、新版本能否发布。核心方法包括:先明确评测要回答的发布决策;把"做完"写成可检查的完成条件和 Hard Failure;建立 30 条起步的分层评测数据集(dev/holdout/regression/challenge);将 Outcome 与 Trajectory 分开评估;采用 Rules + LLM Judge + Human 三层打分体系。最终通过重复运行对比 v1/v2、设置发布门禁、把线上失败送回评测集,形成完整评测闭环。

技术 › Agent Cloris 🌱 2026-09-0426.4 KB 319.9K 512 85