Wiki 知识库

全部文档 / 标签: Agent评估

8 篇
清除

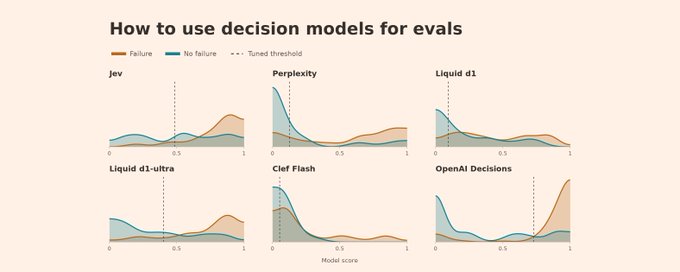
How To Use Decision Models for Evals

文章介绍了决策模型(如 TypeSafe 的 Jev、Perplexity 的 Decider、Liquid 的 d1、Cloudflare 的 Clef、OpenAI 的 Decisions API)作为 LLM judge 的低成本替代方案在自动化评估中的应用。作者基于 100 条公寓租赁 Agent 的对话轨迹,测试各模型识别失败案例的性能与成本,并重点讲解决策阈值的调优:默认阈值 0.50 未必适合具体任务,需根据精确率与召回率的业务权衡(如 F1 优化或最低 80% 双重要求)来选择阈值。文章还提供了用编码 Agent 进行阈值调优的示例提示词,并讨论了校准与分数解释等实用方法。
技术 › LLM Hamel Husain 2026-10-2117.5 KB 318.2K 2.3K 84

Agentic evals: 如何判断 AI Agent 是否真正完成了任务并保持可靠

本文面向构建基于 LLM 的 Agent 系统的工程师,讲解如何对 Agent 进行评估(Agentic Evals)。核心观点是:要评估 Agent 实际改变了什么,而非它说了什么。文章通过一个自行车店客服 Agent 的完整示例,展示五步评估法:编写带预期终态的任务、多次运行并保留完整轨迹、同时评估终态和路径、报告能力与可靠性两个数字、定位失败的第一步。文章还区分了单次回答模型与多步 Agent 在评估上的差异,强调没有可检验终态的任务不构成有效的评估,并讨论了模型作为评判者的可信度问题。

技术 › Agent Sergii Makarevych 2026-10-1151.9 KB 65.5K 671 89

Jev-as-a-Judge for Agent Evaluations

本文介绍了如何使用 TypeSafe AI 的决策模型 Jev 作为 LLM Judge 来评估 Agent 的表现(Jev-as-a-Judge)。与只看最终回复不同,Jev 会阅读完整轨迹(用户请求、工具调用及结果、最终回复),将标准转化为预定义问题,并返回带置信概率的判定。文章通过退款 Agent 示例演示了 Playground 的使用,说明如何设定阈值将运行分为通过、失败和人工复核三类。研究显示,该接受-升级模式比 GPT-6 单独判断更准确且成本大幅降低。作者强调需先用人工标注验证 Jev 的可靠性,能用代码检查的事实性问题就不需要 Judge,将 Jev 保留给需要阅读理解的判断。

技术 › Agent elvis 2026-10-078.3 KB 92.7K 438 83

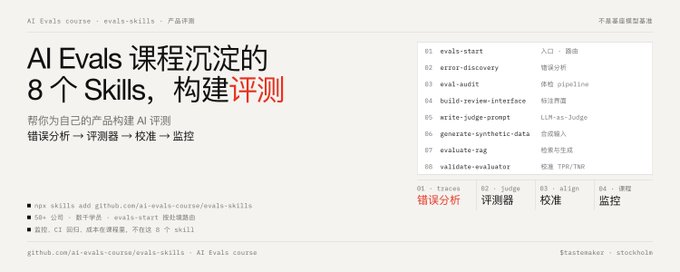
AI Evals 课程沉淀的 8 个 Skills:错误分析 → 评测器 → 校准 → 监控

文章介绍了来自 Hamel Husain 和 Shreya 的 AI Evals 课程沉淀的 8 个 Skills,帮助工程师和产品经理为自己的 AI 产品构建评测体系。核心理念是先看数据再写评测:先手动阅读真实 trace 做错误分析,发现失败模式,再针对每个模式构建评测器,并用约 100 条人工标注校准(TPR/TNR 目标 >90%)。8 个 Skills 覆盖入口路由、错误分析、评测审计、合成数据生成、Judge 提示词编写、评测器校准、RAG 评测和标注界面构建。方法论强调二值评判、单一 judge 测单一失败模式、Rogan-Gladen 偏差修正等最佳实践。

技术 › LLM meng shao 2026-09-238.6 KB 13.9K 66 85

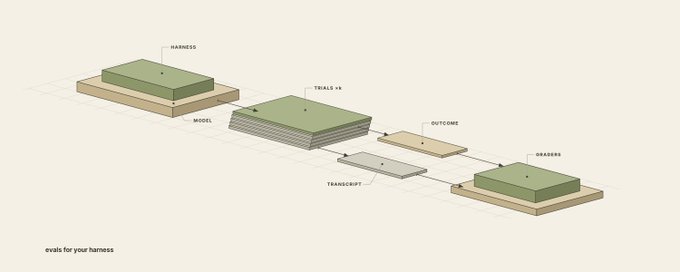
start ugly, write evals anyway:Agent 评估入门指南

文章探讨了 Agent 评估(evals)的重要性与实践方法。作者将 Agent 定义为模型加 Harness 的组合,区分了模型评估与 Harness 评估,并对比了 SDLC 中的测试与 ADLC 中的评估差异。文章澄清了评估的核心概念(task、trial、outcome、grader 等),指出评估的冷启动门槛比想象中低,从真实失败案例中提取 20-50 个任务即可起步。作者强调应只构建任务完成率和正确性两个基础指标,主张评估结果而非路径,并建议纳入负向用例、部分得分机制,坚持阅读轨迹记录,关注分心、token 消耗、延迟、上下文膨胀和一致性等信号。

技术 › Agent hrushikesh 2026-09-1510.4 KB 109.7K 1.2K 82

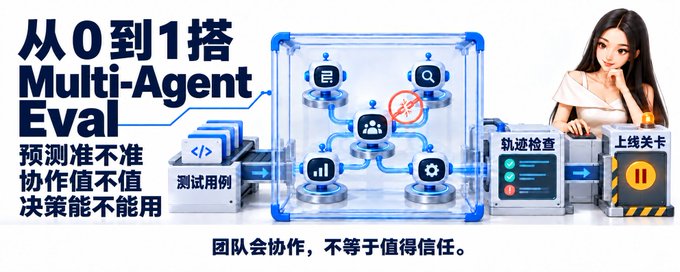
从 0 到 1 搭 Multi-Agent Eval:预测准不准,协作值不值,决策能不能用

本文介绍如何为多 Agent 团队搭建评估体系,以电商场景为例,通过五步流程:设计含陷阱的测试用例、保存 trace 回放协作过程、用结果/协作/决策三张成绩单分别评分、与单 Agent 及重试基线在同等预算下对比、将失败案例加入回归集。文章强调交接信息完整性、冲突解决、角色消融与协调增益等关键检查点,并给出可直接运行的最小 harness 代码示例。

技术 › Agent Cloris 2026-09-1119.0 KB 43.9K 84 83

使用 Google Agents CLI 构建智能体评估内循环

本文是 Google 关于智能体质量飞轮的实操续篇,介绍如何用 agents-cli 手动运行评估内循环。作者构建了一个汇率转换智能体 fx-agent,并故意在指令中植入缺陷(未要求在回复末尾列出所使用的工具),通过六个测试用例的评估集验证:内置 AutoRaters 指标会遗漏此类缺陷,因此需要将关键行为提升为自定义指标(LLM 评审与正则代码检查双重视角)来单独度量。随后修复一行指令,并用分数变化证明修复有效。文章强调评估的意义在于检查智能体是否遵守规则,而非答案表面质量。

技术 › Agent Google Cloud Tech 2026-08-2815.9 KB 31.9K 289 85

2026 Agent Eval 全景图:从'会做'到'值得部署'

本文系统梳理了2026年Agent评估领域的全景图,指出Agent Eval正从'任务能否完成'转向'结果是否有效、过程是否可靠、系统是否值得部署'。文章从通用Agent、软件工程、GUI与SaaS、工具与事务、知识工作(Deep Research、数据分析、预测)、多模态内容生产、科研优化、组件与记忆、多Agent系统等赛道,介绍了代表benchmark及其演进,并强调了可靠性、成本、轨迹审计与证据包成为评估的新基本单位。

技术 › Agent Cloris 2026-08-2221.9 KB 5.6K 56 77