Wiki 知识库

全部文档 / 标签: 回归测试

10 篇
清除

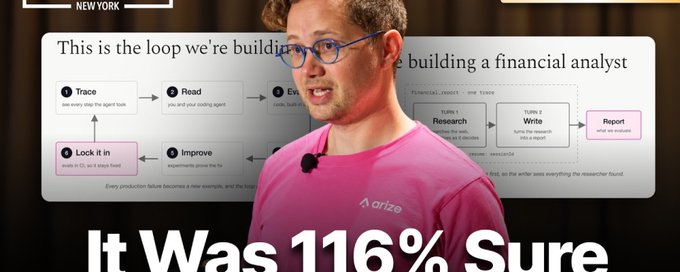
npm 创始人 Laurie Voss:如何判断你的 AI 智能体是否足够优秀

本文整理了 npm 联合创始人 Laurie Voss 在 AI Engineer 纽约 workshop 上关于 AI Agent 评估方法的分享。他从一份分析师共识加总为 116% 的特斯拉研报切入,阐述 trace(日志)与 eval(评估)的区别,强调先人工精读十几条记录再设计评估的重要性。文章详细介绍了从免费代码断言、LLM 裁判到黄金数据集校准裁判的完整评估体系,指出选择正确的评估问题比调优评估更重要,并以'评结果而非评步骤'为原则,演示了通过一行 prompt 修改将可操作性从 5/16 提升到 48/48 的案例。最后他强调将评估接入 CI、区分能力评估与回归评估,才能持续保证 Agent 质量。

技术 › Agent Saito 2026-10-278.6 KB 453 2 84

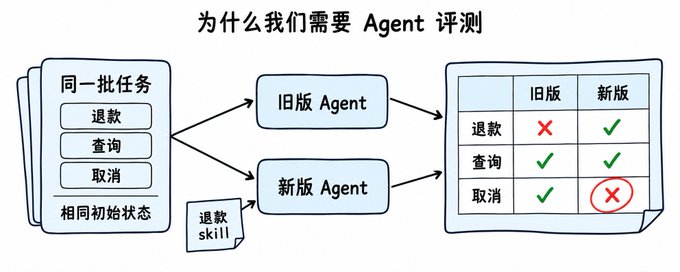
为什么我们需要 Agent 评测

本文是 Agent 评测系列的第一篇文章,作者结合业界共识与个人实践,阐述了 Agent 评测的重要性。文章从一次线上问题修复切入,说明传统后端开发流程难以应对 Agent 的概率性输出与执行路径的不确定性。作者给出 Agent 评测的定义:围绕具体任务,按明确标准检查 Agent 执行过程(trace)和结果的方法。核心价值包括:防止越修越坏、判断改动是否真的变好、确认任务稳定性、明确完成标准、指导迭代优先级。文章还提出评测落地的五步流程:整理任务、写清标准、准备一致环境、运行新旧版本对比、持续更新案例,并提醒注意评测集划分、标准本身可能出错等问题。

技术 › Agent 黄同学h 2026-10-1220.2 KB 15.5K 236 76

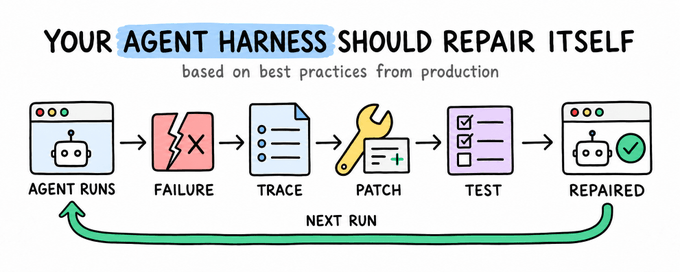
你的 Agent Harness 应该自我修复

文章探讨了 Agent 系统如何在不更新模型权重的情况下实现自我改进。作者提出两条独立回路:成功运行可产出可复用流程(如 Hermes 的 SKILL.md 程序性记忆),失败运行可产出经审查的修复和回归用例。通过 Opik 工具链,生产失败被转化为结构化反馈:trace 记录、源码级诊断、人工批准 diff、重跑验证、回归测试。文章强调改动需版本管理、评估需确定性校验器,系统并非自动学习,而是把事故变成可审查的改进输入。

技术 › Agent yibie 2026-09-1310.3 KB 2.5K 20 77

Your Agent Harness Should Repair Itself

文章探讨 Agent 系统如何在不更新模型权重的情况下自我改进。作者阐述了两条反馈路径:成功运行产生可复用的程序性记忆(以 Hermes 的 SKILL.md 文件和 GEPA 离线优化为代表),失败运行则通过 Opik 的执行 trace 进行诊断,定位故障源头(模型、工具、配置或代码),提出修复方案,经人工审核后重跑并添加回归测试。文章强调失败必须被记录为可验证的预期行为和测试用例,才能转化为可复用的知识,并详细介绍了 trace 结构、失败检测与根因分析的工作流程。

技术 › Agent Avi Chawla 2026-09-1218.9 KB 53K 415 81

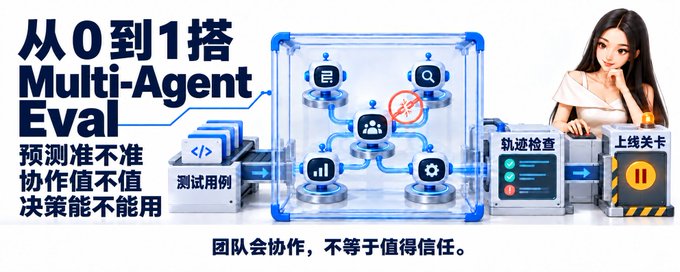
从 0 到 1 搭 Multi-Agent Eval:预测准不准,协作值不值,决策能不能用

本文介绍如何为多 Agent 团队搭建评估体系,以电商场景为例,通过五步流程:设计含陷阱的测试用例、保存 trace 回放协作过程、用结果/协作/决策三张成绩单分别评分、与单 Agent 及重试基线在同等预算下对比、将失败案例加入回归集。文章强调交接信息完整性、冲突解决、角色消融与协调增益等关键检查点,并给出可直接运行的最小 harness 代码示例。

技术 › Agent Cloris 2026-09-1119.0 KB 43.9K 84 83

用 Eval 工程测试 AI Agent 的 6 种方法

文章指出传统确定性单元测试无法覆盖 AI Agent 的多轮、非确定性行为,提出将评估视为可自动化、可度量的 CI/CD 测试套件。作者给出 6 种生产级 Eval 实践:1)先做确定性 schema 检查(JSON 有效性、工具调用参数);2)用 Check Grounding API 等数学化度量事实依据,低于阈值即拒绝输出;3)检查多轮工具调用轨迹的依赖顺序并惩罚循环调用;4)构建带严格评分标准、输出推理过程的 AutoRater 评审模型;5)用 AutoSxS 成对对决和胜率数据安全替换模型;6)在 CI 中建立黄金回归数据集作为硬门禁。文中提到 Firebase 团队借此将复杂多步任务通过率从 31.7% 提升至 78.0%。

技术 › Agent Praveen Rajasekar (Google Cloud Tech) 2026-09-047.1 KB 32.9K 318 81

AI 全部生成代码时代如何保证产品代码可维护不腐化

作者以 Mole 项目(11 万行 Swift、3347 个 XCTest)为例,从产品工程师视角分享 AI 全量生成代码时代保持代码可维护性的实践经验:由工程师主导架构设计与文档沉淀;重视覆盖边界场景的单测,坚持 AI 写的代码由 AI 测试;修 Bug 时补充回归测试并把原因写入规则;用按模块拆分的 Rules 和 Skills 记录功能边界与历史决策;坚持少做无用功能避免维护成本腐化;充分利用 GitHub Actions 与 CI 兜底验证,设置流程卡点让 AI 自动化验证,从而让代码长期持续迭代、清晰可扩展。

技术 › Claude Code Tw93 2026-08-318.2 KB 84

Skill 持续升级指南:让 AI 从记住方法走向自动驾驶

文章讨论 Skill 写完后的持续维护问题,指出 Skill 会随时间腐烂:重复规则、过时参数、失败补丁不断堆积。作者在 Matt Pocock 六种失效模式基础上,扩展为八项检查:过早完成、重复、沉积、蔓延、空操作、否定式引导、样本过拟合和分支串线。针对每种问题,文章给出症状、成因和修复方法,强调先给失败命名再修改,修复后做回归测试。最后提供一份十项体检清单和可直接使用的审计提示词,帮助诊断和优化正在使用的 Skill,让 AI 在正确时间稳定执行正确过程。

技术 › Skill 苏乐 2026-08-3033.5 KB 59.3K 192 93

Eval工程:如何真正评估AI系统是否变得更好

文章介绍了“评估工程”的概念,强调主观感觉无法替代系统化测试。构建可靠的AI评估体系需要三个核心部分:具有代表性的数据集、客观的打分器和预设的及格阈值。作者详细阐述了如何构建包含常规、边缘和已知失败的数据集,以及如何选择精确匹配、规则打分或模型打分机制。最后强调,评估必须在每次系统变更时自动运行,以防微小的改动引发严重的隐性回归。

技术 › Agent wast3 2026-08-1111.3 KB 45.9K 133 85

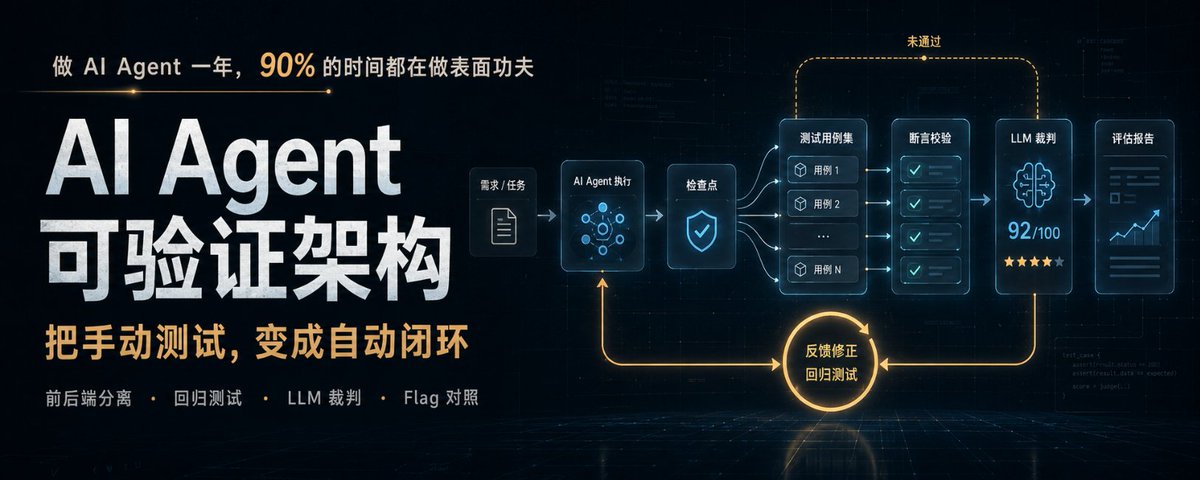
做 AI Agent 一年,90% 的时间都在做表面功夫

作者通过一年的 AI Agent 开发实践,发现 90% 的时间浪费在手动测试上。受芯片“验证不对称”理念启发,作者提出构建可验证的架构:通过前后端分离(ACI)使系统对 AI 友好,并引入“确定性断言”和“LLM 裁判”两级回归测试体系。最终实现了由 Coding Agent 自动运行的闭环开发,将开发者从繁琐的手工验证中解放出来,重塑了 AI 时代的开发效率。

技术 › Agent A Ando 2026-07-0811.5 KB