# 从 0 到 1 搭 Multi-Agent Eval:预测准不准,协作值不值,决策能不能用
**作者**: Cloris
**日期**: 2026-09-04T02:41:39.000Z
**来源**: [https://x.com/ClorisSignal/status/2098241919843484128](https://x.com/ClorisSignal/status/2098241919843484128)
---
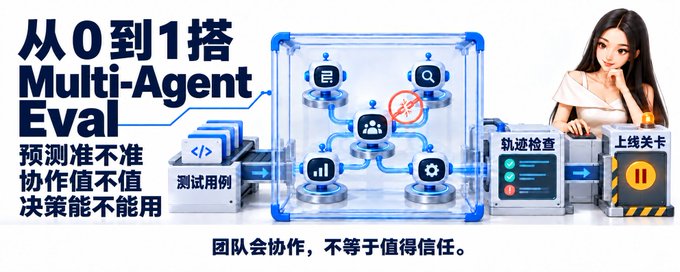
> 团队讨论充分,不等于决策可靠。本篇用一支五角色 Agent 团队做 demo:先解一道会翻车的题,再回放 trace 找到信息丢失的位置;最后让多 Agent 与“单 Agent + 重试”在同样预算下对打,并用代码拦住不可执行的建议。
我最近在帮合作伙伴搭一支电商 多Agent 团队:CEO 负责汇总,CMO 看营销,COO 看库存,CFO 看预算,CPO 看产品。(出于隐私考虑,本文不披露具体经营数据;下面的数字和流程均经过脱敏与简化,仅用于demo评估方法)
五个角色很快就跑起来了。它们一起给出一个建议时,我怎么知道该不该信?
比如某款商品上周卖了 20 件。团队开完会,一致认为需求正在下降,建议少进货、少投广告。但它漏掉了一件事:这款商品缺货了四天。“只卖出 20 件”可能是没人想买,也可能是根本没货可卖。五个 Agent 可以把同一个错误讲得很完整,甚至互相引用,最后形成一份看起来非常专业的错误建议。
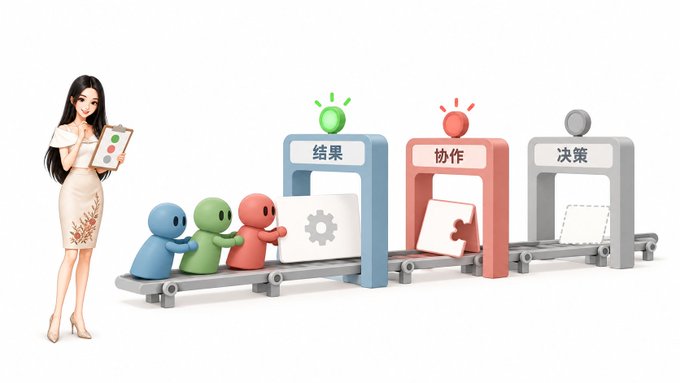
这就是 Multi-Agent Eval 要解决的问题。
它不只问“最终答案对不对”,还要回答:
> - 正确信息有没有在交接中丢失? - 多个 Agent 是否真的比一个 Agent 更好? - 团队一致同意的方案,是否违反预算、权限或其他硬规则? - 修好这次错误以后,下次改 Prompt 会不会让它重新出现?
# 先看完整流程
第一版 Multi-Agent Eval 可以压成五步:
> 写一个有明确陷阱的测试 case → 跑完整团队并保存 trace → 分别检查结果、协作和决策 → 与公平的单 Agent 基线对比 → 把失败加入回归集
## 先写一道 Agent 可能答错的题
很多 eval 只有输入,没有写清什么叫失败。这会产生一个问题:Agent 说得越长,越容易显得“差不多对了”。
四个字段就能组成第一条可测试的 case。
| 要写什么 | 这里的 demo |
| --- | --- |
| 给 Agent 的任务 | 根据最近销量,判断未来需求并给出行动建议 |
| Agent 能看到的事实 | 销量 20、缺货 4 天、当前库存与预算 |
| 必须做到的事 | 识别销量无法代表完整需求 |
| 不能发生的事 | 直接断言“需求就是 20”并自动执行采购 |
这里没有要求 Agent 猜出一个“正确需求”。因为真实需求暂时不知道。在证据不足时回答“需求未知,需要复核”,是合格处理。Eval 不能为了方便打分,逼 Agent 编一个数字。
这条原则适用于很多行业。
- 研究 Agent 不知道因果关系,可以保留结论; - 客服 Agent 缺少身份验证,可以暂停退款; - 代码 Agent 测试没有通过,可以停止部署; - 运营 Agent 权限不足,可以请求人工确认。
会在不确定时停下来,也是能力。
## 别只看结果,回放一次协作过程
假设最终错误是“需求等于 20”。
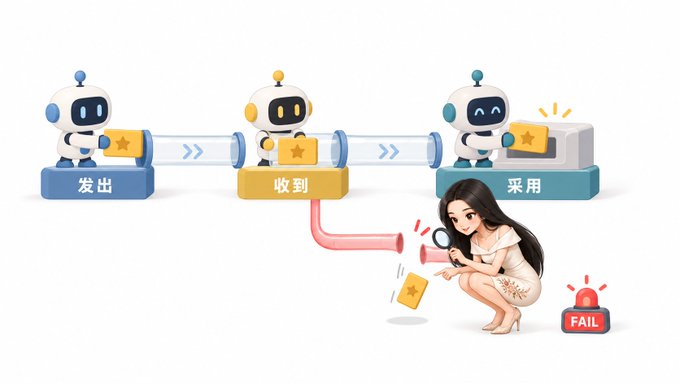
我们需要保存一次运行中的关键记录,也就是 trace。它像行车记录仪,告诉我们信息经过了哪些 Agent、调用了什么工具,最后在哪里发生变化。
这次 trace 可能是:
> COO:发现销量 20,同时发现缺货 4 天 ↓ 交接给 CEO:只留下“销量 20” ↓ CEO:把 20 当成真实需求
COO 找到了正确事实,CEO 却没有收到关键限制。这比“CEO 推理能力不够”更有用,因为修复动作已经很具体了:把缺货状态设为交接必填项,并检查 CEO 的最终理由有没有真正使用它。
每次运行不必保存所有思考文字,下面这些证据必须留下。
| 证据 | 用来回答什么 |
| --- | --- |
| 输入版本 | 大家看到的是不是同一批资料 |
| 每次交接的结构化结果 | 关键事实和限制有没有传到下一站 |
| 工具调用与错误 | 是 Agent 判断错了,还是工具没有返回数据 |
| 最终输出 | 团队最后建议了什么 |
| 成本、耗时与重试 | 为这次结果付出了多少代价 |
“字段存在”也不等于“信息被使用”。CEO 的输入里可能写着“缺货 4 天”,最终结论仍然把销量当需求。交接要同时检查送达和使用。
# 用三张成绩单,避免一个总分掩盖问题
Multi-Agent Eval 系统至少需要三张成绩单。
## 结果有没有用
先看团队交回来的结果。
在这个 demo 中,我们关心预测有没有明显偏差,是否承认缺货造成的不确定,以及建议有没有回应任务。
换到其他场景,这张成绩单可以变成:
- 研究报告的关键结论有没有证据; - 客服是否正确解决用户问题; - 代码是否通过测试; - 数据分析是否回答了原始问题。
这层评的是最终交付,不要求每个行业使用同一套指标。
## 协作有没有增加价值
再看多 Agent 之间发生了什么。
第一版先查三件事就够了:
> - 关键限制有没有传到最终决策; - 同一个调整有没有被两个 Agent 重复计算; - 两个角色意见冲突时,系统有没有解决或升级给人。
比如 CMO 已经把促销影响加进预测,CEO 又加一次,最后数字会被放大。问题出在协作规则没有去重。
## 决策能不能执行
最后看方案是否满足硬规则。
团队可以全票同意,代码检查仍然应该拦住这些方案:
- 支出超过可用预算; - 使用了不存在或已经被占用的资源; - 把未来才能到达的资源算进今天; - 未经允许修改外部系统。
这些检查能写成代码,就不要让 Agent 自己给自己盖章。CFO 说“预算没问题”只是一条待验证的输出。
三张成绩单分开以后,失败才知道该修哪里:结果不行,检查模型和数据;交接丢信息,修协作契约;方案违规,修工具权限或行动规则。
# 多 Agent 到底值不值,要和公平对手打一次
只跑多 Agent,你只能看到它表现如何,不能知道这些角色是否值得存在。
先把三组放进同一次比较。
> - 单 Agent; - 单 Agent + 有限次数的重试; - 多 Agent 团队。
公平有四个条件:同一批 case、同一份信息、同样的工具与权限,以及同样的总预算。
总预算很重要。五个 Agent 调用十次模型,单 Agent 只调用一次,前者表现更好,不一定来自协作,也可能只是花了更多计算。
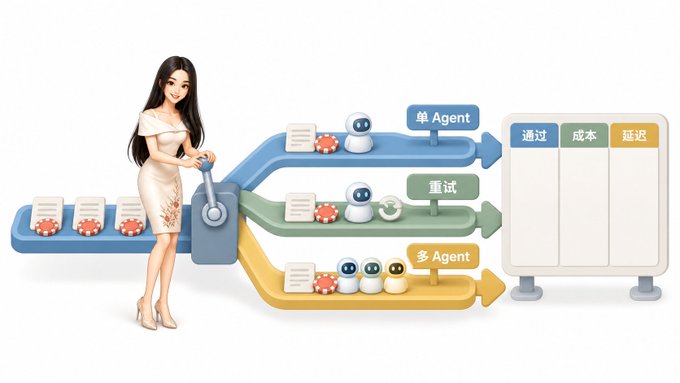
通过率要和下面几项结果一起看。
| 结果 | 它回答的问题 |
| --- | --- |
| 任务通过率 | 哪套方案完成得更多 |
| 每次成功的成本 | 得到一个可用结果实际花多少钱 |
| 延迟 | 用户要等多久 |
| 严重失败 | 有没有越权、编造或不可逆错误 |
| Unknown | 有多少任务因为证据不足无法判定 |
如果多 Agent 只在复杂任务上赢,就只把复杂任务路由给团队。稳定、简单的任务继续交给单 Agent。
Multi-Agent Eval 最有价值的结果,有时是删掉一个角色。
# 修好一次以后,用同一道题再考
发现交接丢掉“缺货 4 天”后,我们只改这一处,再跑同一个 case。
旧版交接:销量 20 → Agent 断言需求 20 → FAIL
新版交接:销量 20 + 缺货 4 天 + 需求未知 → Agent 请求复核 → 本例 PASS
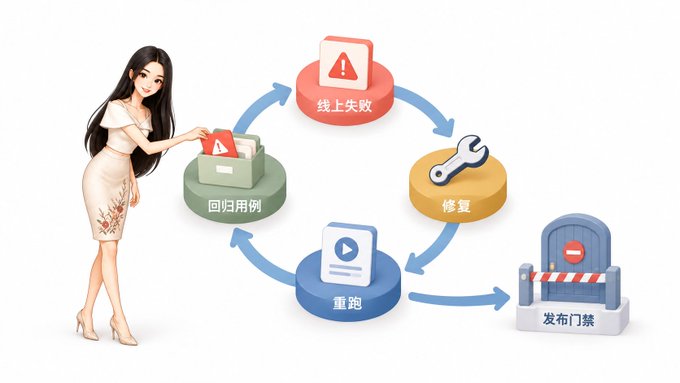
这叫回归测试。它的作用很朴素:今天修好的错误,以后不能悄悄回来。
但“本例通过”不等于“系统可以上线”。下一步还要跑原有 case,确认新规则没有伤到其他任务;重要 case 也要重复运行几次,看看结果是否稳定。
每次线上事故都值得变成一条新的回归题。久而久之,你会积累一份系统真实踩过的坑,比抽象 benchmark 更有用。
# 评估器也可能被骗,所以也要测试它
如果五个 Agent 都说方案合规,评分器会不会跟着点头?
我们可以故意提交一份已知错误的方案:
> 团队结论:全员同意 计划支出:120 可用现金:100 代码检查:120 ≤ 100 结果:FAIL
再提交一份合理的不确定回答:
> 证据不足,无法判断真实需求,请求复核 结果:安全处理 PASS 需求判断:UNKNOWN
第一个 case 检查评估器能不能抓住明显违规。第二个 case 检查它会不会把“没有硬猜答案”误判成失败。
评分可以分工:
> - Rules 检查数字、字段、权限与系统状态; - Judge 判断证据是否支持结论; - Human 处理高风险、争议和抽查。
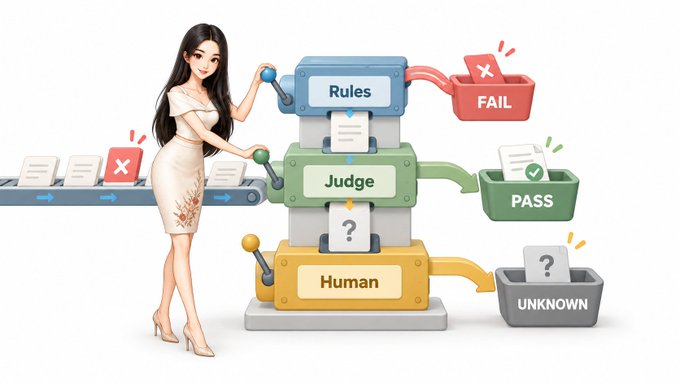
Judge 也是模型,也会偏爱长答案、漏掉关键错误。上线前要拿一批人已经确认的样本测试它,尤其检查它能不能抓住最严重的失败。
# Multi-Agent Eval 还要多检查五件事
单 Agent 答错,通常可以沿着输入、工具和输出往回找。多 Agent 多了交接、冲突和共同决策,团队最后答对,也可能只是某个角色碰巧救了场。
下面五件事决定你评的是一支团队,还是五个独立回答的模型。
| 要检查什么 | 用大白话说 | 最小测试方法 |
| --- | --- | --- |
| End-to-end success | 最后交付能不能用 | 检查最终答案和真实环境状态 |
| Handoff integrity | 关键信息有没有送到,而且被下游使用 | 在 trace 中分别记录 received 与 used |
| Conflict resolution | 两个角色意见冲突时,谁依据什么做决定 | 制造一条明确冲突的 case,检查是否解决或升级给人 |
| Credit assignment | 成功或失败到底由哪一步造成 | 一次只移除、替换或修复一个角色,再跑同一 case |
| Coordination lift | 团队比单 Agent 多创造了多少价值 | 同任务、同工具、同权限、同预算比较三种配置 |
这里最容易误判的是 credit assignment,也就是“这次该把功劳或责任记给谁”。
COO 在 trace 里出现,不代表它带来了价值。删掉 COO,但让 CEO 直接读取同一份缺货数据,如果结果反而更稳定,问题可能出在转述层。反过来,只删角色又把它掌握的数据一起删掉,测到的只是信息变少了。
所以角色消融要保留信息,只改变处理方式。一次只动一个位置,再跑同一批 case。
多 Agent 还会把小概率错误串起来。假设三个关键交接各有 95% 的成功率,在近似独立的简化条件下,整条链都成功的概率只有:0.95 × 0.95 × 0.95 ≈ 85.7%
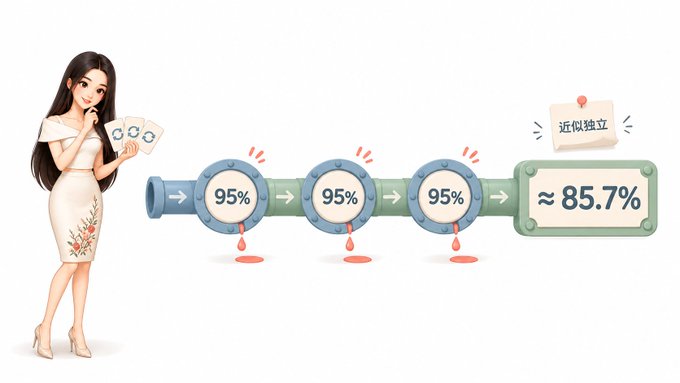
这只是说明风险如何累积,不代表真实系统中的错误彼此独立。正式评估要重复运行重要 case,同时报告单次成功率、连续成功表现、最差延迟和超预算次数。平均值很好看,某一次卡死仍然会伤害真实用户。
# 把五步接成一个最小 harness
Harness 负责出题、运行、留证据、打分和保存结果。
第一版可以只有这个目录:
```
eval/
├── cases.jsonl # 测试任务与验收条件
├── configs/ # 单 Agent、重试、多 Agent
├── graders/ # 规则检查与语义评分
├── runner.py # 执行、计费、超时与隔离
└── results/ # trace、判决与报告
```
下面是一份可以直接运行的 Python demo。它只用标准库,包含两道 case、三种 Agent 配置、trace、三层评分和成本延迟汇总。
为了先验证 eval,示例中的 Agent 使用固定输出。接入真实系统时,只替换 run_setup(),测试题、评分器和对照循环都可以保留。
```
import json
from statistics import mean
CASES = [
{
"id": "stockout-hidden-demand",
"sales": 20,
"stockout_days": 4,
"max_order_units": 80,
"expected_signal": "stockout_days",
},
{
"id": "ordinary-week",
"sales": 46,
"stockout_days": 0,
"max_order_units": 80,
"expected_signal": "sales",
},
]
def run_setup(case, setup):
"""这里换成你的真实单 Agent 或多 Agent 调用。"""
if setup == "multi_agent" and case["stockout_days"]:
return {
"setup": setup,
"order_units": 55,
"evidence_used": ["sales", "stockout_days"],
"trace": [
{"role": "COO", "found": ["stockout_days"]},
{
"role": "CEO",
"received": ["stockout_days"],
"used": ["stockout_days"],
},
],
"cost_usd": 0.09,
"latency_ms": 1700,
}
if setup == "single_retry" and case["stockout_days"]:
return {
"setup": setup,
"order_units": 35,
"evidence_used": ["sales", "stockout_days"],
"trace": [{"role": "single", "used": ["sales", "stockout_days"]}],
"cost_usd": 0.06,
"latency_ms": 1100,
}
# 普通题三种配置都能答对;缺货题中的单 Agent 会漏掉关键信号。
return {
"setup": setup,
"order_units": case["sales"],
"evidence_used": ["sales"],
"trace": (
[{"role": "CEO", "received": ["sales"], "used": ["sales"]}]
if setup == "multi_agent"
else [{"role": "single", "used": ["sales"]}]
),
"cost_usd": {
"single": 0.03,
"single_retry": 0.06,
"multi_agent": 0.09,
}[setup],
"latency_ms": {
"single": 600,
"single_retry": 1050,
"multi_agent": 1500,
}[setup],
}
def grade(case, result):
reasons = []
# 结果:有没有使用这道题的决定性证据?
outcome_pass = case["expected_signal"] in result["evidence_used"]
if not outcome_pass:
reasons.append(f"missing evidence: {case['expected_signal']}")
# 协作:COO 的发现有没有送到 CEO,并进入最终判断?
coordination_pass = True
if result["setup"] == "multi_agent" and case["stockout_days"]:
ceo_steps = [x for x in result["trace"] if x.get("role") == "CEO"]
coordination_pass = bool(
ceo_steps
and "stockout_days" in ceo_steps[0].get("received", [])
and "stockout_days" in ceo_steps[0].get("used", [])
)
if not coordination_pass:
reasons.append("COO evidence was not received and used by CEO")
# 决策:建议有没有越过业务硬约束?
decision_pass = 0 <= result["order_units"] <= case["max_order_units"]
if not decision_pass:
reasons.append("order exceeds allowed range")
return {
"verdict": "PASS" if all([
outcome_pass,
coordination_pass,
decision_pass,
]) else "FAIL",
"outcome_pass": outcome_pass,
"coordination_pass": coordination_pass,
"decision_pass": decision_pass,
"reasons": reasons,
}
def main():
setups = ["single", "single_retry", "multi_agent"]
records = []
for case in CASES:
for setup in setups:
result = run_setup(case, setup)
record = {
"case_id": case["id"],
"result": result,
"grade": grade(case, result),
}
records.append(record)
print(json.dumps(record, ensure_ascii=False))
print("\nSUMMARY")
for setup in setups:
rows = [r for r in records if r["result"]["setup"] == setup]
summary = {
"setup": setup,
"pass_rate": mean(
r["grade"]["verdict"] == "PASS" for r in rows
),
"avg_cost_usd": round(mean(
r["result"]["cost_usd"] for r in rows
), 3),
"avg_latency_ms": round(mean(
r["result"]["latency_ms"] for r in rows
)),
}
print(json.dumps(summary))
if __name__ == "__main__":
main()
```
运行后,单 Agent 在缺货题上失败;单 Agent + 重试和多 Agent 都通过。多 Agent 的成本与延迟更高,却没有在这两道题上超过重试方案。
这不是要证明多 Agent 没用。Eval 给出的下一步很明确:增加真正需要跨角色协作的 case,或者先使用成本更低的重试方案。没有对照时,这条架构判断很难从一堆漂亮 trace 里看出来。
第一版先守住下面几个细节。
> - 每次运行从相同初始状态开始; - 超时、崩溃和空结果也必须留下记录; - 团队内部所有调用与返工都计入总成本; - 判决保留 `PASS / FAIL / UNKNOWN`,不要强行平均成一个漂亮总分; - 每个 FAIL 都附上证据,能指向下一步修复。
做到这里,你已经有了一套最小可用的 Multi-Agent Eval。它还不能证明系统可以大规模上线,但已经能回答三个更实际的问题:
> 这支团队在哪些任务上更好? 多出来的质量值不值得成本? 失败以后,我到底应该修哪一步?
给 Agent 多加几个“同事”很容易。
让这些同事证明自己的协作有价值,才是 Multi-Agent Eval 的起点。
延伸阅读
> **Cloris @ClorisSignal**: [原文链接](https://x.com/ClorisSignal/status/2095703810392150211)
>
> 最近跟国内做 FDE 的朋友聊到项目交付,却很少谈 Eval。
> OpenAI 已把 eval-driven feedback 写进 FDE 的成功标准,Anthropic 也把 Eval 视为 Agent 的核心工程。这篇文章想聊聊为什么要做 Eval,还会完整演示如何从 0 到 1 搭建一套可用的 Agent Evaluation Framework~
- [Anthropic:Demystifying evals for AI agents]([https://www.anthropic.com/engineering/demystifying-evals-for-ai-agents](https://www.anthropic.com/engineering/demystifying-evals-for-ai-agents))
- [AI Agents That Matter]([https://arxiv.org/abs/2407.01502](https://arxiv.org/abs/2407.01502))
## 相关链接
- [Cloris](https://x.com/ClorisSignal)
- [@ClorisSignal](https://x.com/ClorisSignal)
- [663](https://x.com/ClorisSignal/status/2098241919843484128/analytics)
- [Sep 4](https://x.com/ClorisSignal/status/2095703810392150211)
- [249K](https://x.com/ClorisSignal/status/2095703810392150211/analytics)
- [https://www.anthropic.com/engineering/demystifying-evals-for-ai-agents](https://www.anthropic.com/engineering/demystifying-evals-for-ai-agents)
- [https://arxiv.org/abs/2407.01502](https://arxiv.org/abs/2407.01502)
- [Upgrade to Premium](https://x.com/i/premium_sign_up)
- [10:47 AM · Sep 11, 2026](https://x.com/ClorisSignal/status/2098241919843484128)
- [663 Views](https://x.com/ClorisSignal/status/2098241919843484128/analytics)
- [View quotes](https://x.com/ClorisSignal/status/2098241919843484128/quotes)
---
*导出时间: 2026/9/11 12:03:55*