Wiki 知识库

全部文档 / 作者: huangserva / 标签: 开源

3 篇
清除

全世界第一个记忆原生大模型 MemT-1.0 上线

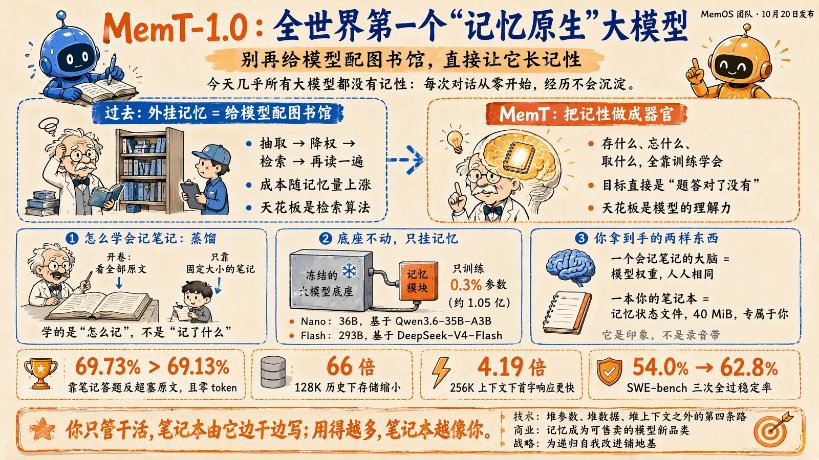
MemOS 团队发布全球首个“记忆原生”大模型 MemT-1.0,将记忆能力直接训练进模型权重,取代 RAG、Mem0 等外挂记忆方案。其思路是不改底座、参数冻结,仅在部分层并联约 1.05 亿参数的记忆块,通过蒸馏训练让模型自学“什么该记、什么该忘、怎么取用”,优化目标从检索命中率改为任务答对率。交付物包括通用模型权重(会记笔记的大脑)和用户专属记忆状态文件(仅 40 MiB 的笔记本)。数据显示其 40 MiB 记忆答题成功率 69.73%,略高于全量上下文的 69.13%,存储缩小 66 倍、首字响应快 4.19 倍。已在 Hugging Face 和 GitHub 开源,被视为开启模型“在使用中变强”的第四条技术路线。

技术 › LLM huangserva (@servasyy_ai) 2026-10-218.8 KB 73

给科学家用的 Claude Code:本地跑、可追溯、能换引擎的 Open-Science 实测

文章实测了新加坡 AIPOCH 团队开源的科研 AI 工作台 Open-Science,它以 Claude Code、Codex 等为可替换引擎,外覆科研专用壳层。针对科研三大痛点——文献易被 AI 编造、敏感数据不能出本地、图表无法溯源——该项目提供 36 个科学数据库连接器、本地数据存储、不可篡改的执行记录与血缘图,并支持通过 .science 文件包(基于 RO-Crate 开放标准)导出完整研究过程供他人复现。作者以复现一篇基因表达分析论文为例,验证了差异表达分析与火山图生成,并用独立 AI 审查员完成交叉核验,展示了可复现、可交接的开源科研工作流。

技术 › Agent huangserva 2026-10-1926.3 KB 13.4K 49 85

腾讯开源 AI Agent 运行时系统 TencentDB Agent Memory

文章深度解析了腾讯开源的 TencentDB Agent Memory 系统。不同于市面上的“向量数据库+RAG”方案,该系统旨在解决长任务中的“上下文退化”问题。其核心创新在于短期压缩(Offload 机制)与长期记忆(四层流水线)的结合,通过三层回溯、任务图动态压缩及结构化记忆提取,有效管理了 Agent 的上下文窗口与记忆生命周期。

技术 › Agent huangserva 2026-05-228.7 KB 8.7K 58 88