Wiki 知识库

全部文档 / 作者: yibie / 标签: Harness

4 篇
清除

16 个 agent 把一款老游戏反编译回 C++

作者分享了用 16 个自主 AI agent 在三个月内反编译一款热门第一人称射击游戏为 C++ 的完整过程。项目从 4 个 agent 起步,用 GitHub issues 追踪进度、Discord 实现 agent 间通信,并用 Hex-Rays ida-mcp 进行反汇编。初期虽然游戏能运行,但代码存在大量语义错误,根源是缺乏客观验收标准。团队随后构建了字节匹配验证 harness,对重构函数与原版 EXE 逐字节比较,让便宜的模型也能可靠工作。最终 99% 的函数完成重构,83% 字节级精确。文章总结了关键经验:指令必须精确、正确性应机器可检查、好的 harness 可用低成本模型、指令需定期刷新等,总计消耗约 6000-7000 亿 token。

技术 › Agent yibie 2026-10-1217.0 KB 2K 10 85

解放模型:前沿上的 harness 设计

本文介绍 Replit AI 团队关于 agent harness 设计的实证文章:与其让较弱的 router 替强模型选择 LLM,不如解放模型自己决定 effort 档位、何时委派任务以及交给谁。Replit Agent 通过四个可组合委派原语(领域感知子 agent、档位与 effort、可复用子 agent、动态 effort 调整)实现这一目标。生产数据显示,GPT-6 Astra 是首个无需吩咐就例行把实现交给通用 worker 的模型,回访已有子 agent 的比例达 42%。基准测试中 Replit Agent 在 DeepSWE 和 Terminal-Bench 上均优于 sidekick 架构 11~16 个点,且具备成本-质量帕累托有效性。作者将其解读为 Sutton「苦涩的教训」的实例:模型越强,harness 越应少做决定。

技术 › Agent yibie 2026-09-3010.8 KB 4K 42 79

你的 Agent Harness 应该自我修复

文章探讨了 Agent 系统如何在不更新模型权重的情况下实现自我改进。作者提出两条独立回路:成功运行可产出可复用流程(如 Hermes 的 SKILL.md 程序性记忆),失败运行可产出经审查的修复和回归用例。通过 Opik 工具链,生产失败被转化为结构化反馈:trace 记录、源码级诊断、人工批准 diff、重跑验证、回归测试。文章强调改动需版本管理、评估需确定性校验器,系统并非自动学习,而是把事故变成可审查的改进输入。

技术 › Agent yibie 2026-09-1310.3 KB 2.5K 20 77

Harness 是组合泛化器

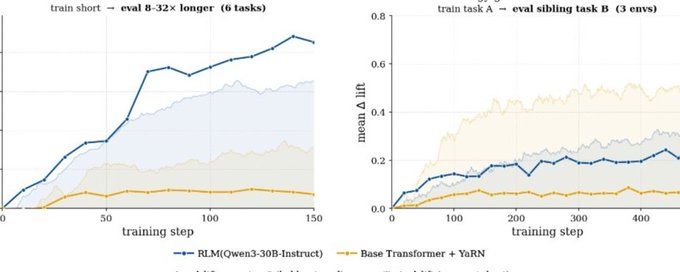
本文介绍 Alex L. Zhang 与 Omar Khattab 提出的观点:Transformer 不擅长组合泛化,而更好的泛化应主要由 harness 完成。Harness 位于外部世界与神经网络之间,通过 context offloading(上下文卸载)和程序化子 agent 调用两个机制,让每次 LM 调用看到的观察处于训练分布内(LID),把复杂、陌生的问题归约为简单、熟悉的问题。实验基于 Qwen3-30B 的递归语言模型(RLM)显示在长度泛化和跨域策略泛化上远胜裸 Transformer,30B RLM 甚至可逼近 GPT-5.5。作者提醒不要手工硬编码 harness 结构,数据 scaling 仍是最大驱动力,但 harness 决定 scaling 系数。

技术 › Harness Engineering yibie 2026-09-127.1 KB 14.2K 93 76