你的 Agent Harness 应该自我修复
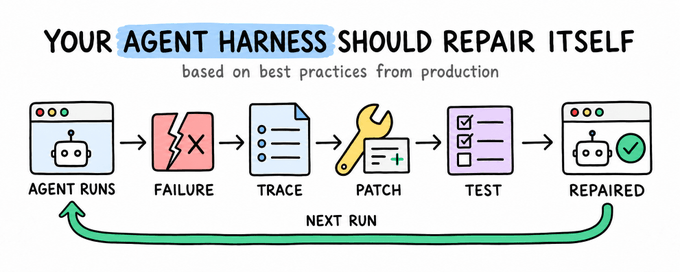
文章探讨了 Agent 系统如何在不更新模型权重的情况下实现自我改进。作者提出两条独立回路:成功运行可产出可复用流程(如 Hermes 的 SKILL.md 程序性记忆),失败运行可产出经审查的修复和回归用例。通过 Opik 工具链,生产失败被转化为结构化反馈:trace 记录、源码级诊断、人工批准 diff、重跑验证、回归测试。文章强调改动需版本管理、评估需确定性校验器,系统并非自动学习,而是把事故变成可审查的改进输入。
文章探讨了 Agent 系统如何在不更新模型权重的情况下实现自我改进。作者提出两条独立回路:成功运行可产出可复用流程(如 Hermes 的 SKILL.md 程序性记忆),失败运行可产出经审查的修复和回归用例。通过 Opik 工具链,生产失败被转化为结构化反馈:trace 记录、源码级诊断、人工批准 diff、重跑验证、回归测试。文章强调改动需版本管理、评估需确定性校验器,系统并非自动学习,而是把事故变成可审查的改进输入。
文章探讨 Agent 系统如何在不更新模型权重的情况下自我改进。作者阐述了两条反馈路径:成功运行产生可复用的程序性记忆(以 Hermes 的 SKILL.md 文件和 GEPA 离线优化为代表),失败运行则通过 Opik 的执行 trace 进行诊断,定位故障源头(模型、工具、配置或代码),提出修复方案,经人工审核后重跑并添加回归测试。文章强调失败必须被记录为可验证的预期行为和测试用例,才能转化为可复用的知识,并详细介绍了 trace 结构、失败检测与根因分析的工作流程。
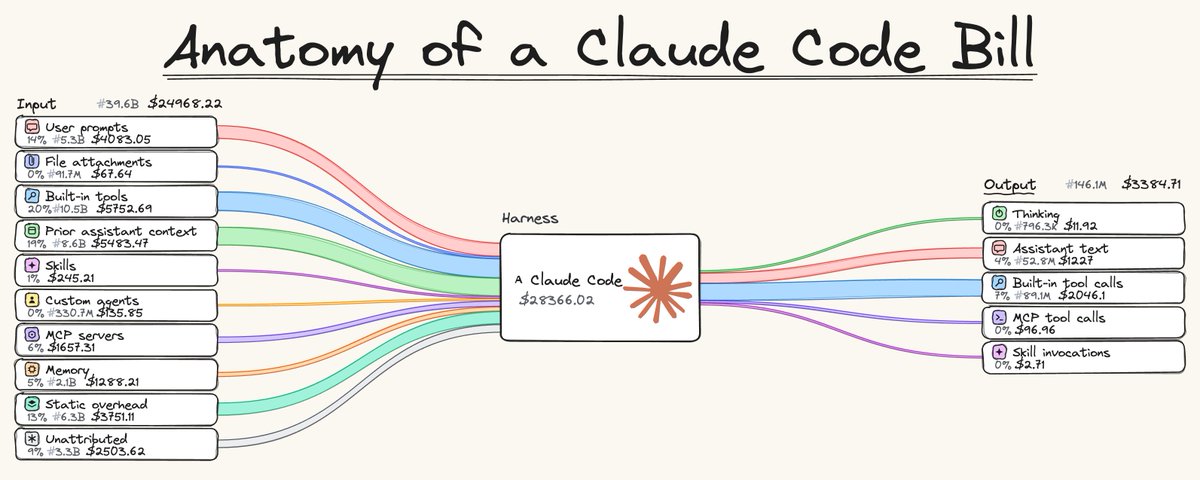
本文基于对45人工程团队30天的Claude Code使用追踪,剖析了其账单构成:真实用户提示仅占输入token的14%,其余为静态系统开销、CLAUDE.md与Skills、MCP服务器schema、工具结果回放及历史上下文等配置性开销。文章指出Uber等大规模部署中人均月支出高达500-2000美元,并介绍了Comet在Opik中推出的Cost Intelligence代理插件,通过token级可观测性帮助团队识别浪费,15分钟审计可削减20-40%账单。
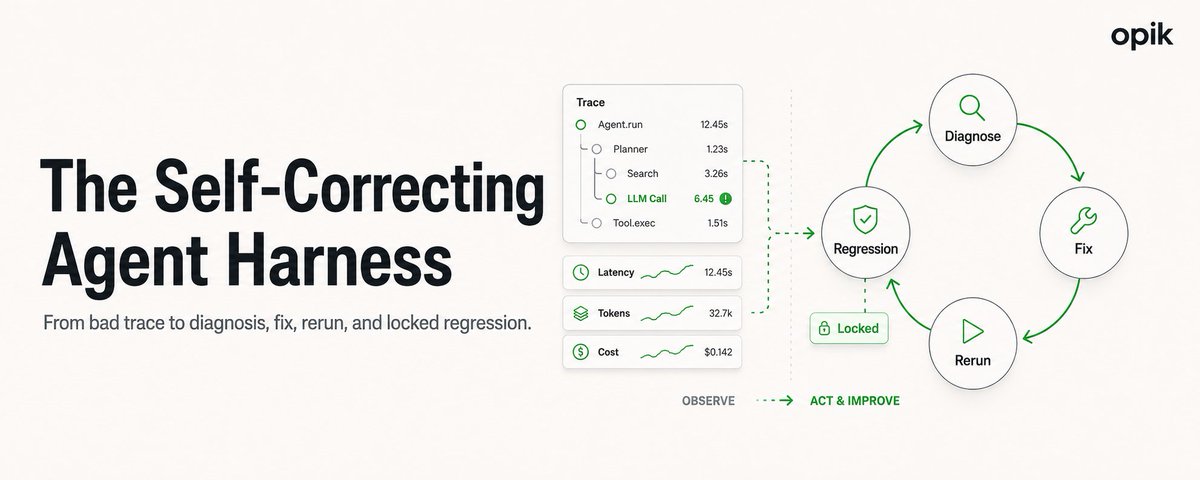
文章探讨了AI Agent在生产环境中失败时,传统可观测性工具仅能提供追踪数据,而无法自动解决修复问题的瓶颈。作者介绍了开源平台Opik,它通过四层架构(Tracing追踪、Ollie诊断与修复、Test Suites测试集、Agent Sandbox沙盒)形成闭环。该平台能自动诊断错误链路,内置代码代理提出修复方案,并将真实失败转化为回归测试,从而实现Agent框架的自我修复与持续优化。