Wiki 知识库

全部文档 / 标签: 可观测性

24 篇
清除

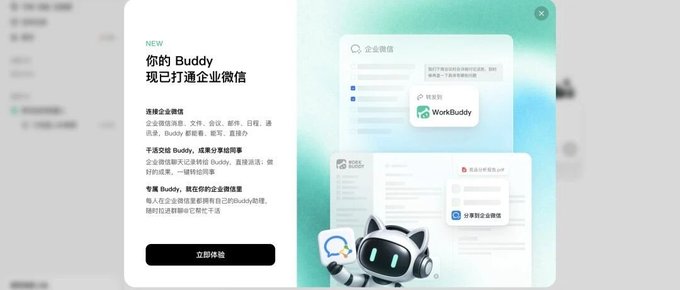
等了7个月,WorkBuddy终于住进企微,太丝滑了!

作者分享了WorkBuddy与企业微信正式打通后的使用体验。7个月前WorkBuddy只能作为单向传话筒被拉进企微群,如今联合版本让AI真正融入企业:它能理解企微内的消息、文件、日程、会议等全部上下文,产出的PPT可直接发回群聊并沉淀为公司资产。文章介绍了开通步骤(需认证企微)、三种任务入口,并演示了项目管理催进度、选题日报等实用场景,还强调了数据不外流和权限统一管理的安全性。此外,作者重点介绍了企业版可观测中心的三层监控机制(实时观测、会话追踪、轨迹详情),并建议普通人应在平台内沉淀经验、构建Skill,而非与平台抢入口。
技术 › Agent 袋鼠帝 2026-10-1616.2 KB 2.7K 6 77

Verification Engineering 时代

文章探讨 AI Native 组织中 Verification(验证工程)正成为关键工程环节。当 AI 和多个 agent 高频生成并提交代码时,验证速度和可靠性成为新瓶颈。作者提出设立专门的 Verification Engineer 岗位,并分享实践:用 Rust 工具链缩短反馈时间、程序化 E2E 分层、agent 定期真实操作巡检、使用 PGlite 减轻环境负担、merge queue 验证合并后代码、mutation testing 验证测试有效性,以及为验证系统本身建立可观测性指标(如反馈耗时、缓存命中率、flaky 测试跟踪),以实现更快、更可信的代码验证闭环。
技术 › DevOps Sanjin 2026-10-038.1 KB 7K 66 86

JevOps: 决策模型正在改变 DevOps 的早期信号

文章探讨了决策模型 Jev 在 DevOps 领域的早期应用,提出“JevOps”概念。DevOps 充满大量小型语义决策(如日志是否值得调查、告警是否严重、修复是否有效等),传统依赖确定性规则、分类器或 LLM。Jev 以低成本、低延迟的方式将这些语义决策直接嵌入运维系统。文章列举了多个案例:Cribl 探索遥测管道中的语义决策、Jev Logs 实现日志分流、Jevernetes 应用于 Kubernetes 日志、Datadog 将 Jev 用于生产环境 Agent 评估、SREGym 在 SRE Agent 旁构建第二评估循环、以及 Jev 对高风险动作的语义门控审查,展示了决策模型在各运维环节的广阔前景。

技术 › DevOps Josh Rosen 2026-09-2714.4 KB 42K 247 77

Use Jev to extract signals from millions of chat agent traces

本文介绍如何利用 Jev 类模型大规模分析数百万条聊天 Agent 生产轨迹,从中提取失败信号。传统 LLM-as-a-judge 评估依赖采样以控制成本,而 Jev 类模型可在同一上下文中并行回答多个问题,以极低成本对全部轨迹进行全面评估。文中讨论了显式反馈、行为追踪、事实结果和对话信号等不同类型的用户信号,并以航班改签客服对话为例,展示如何同时捕捉后续提问、用户挫败感和结果满意度等维度。文章最后介绍如何在 Langfuse 中配置基于 Jev 的批量评估模板,实现生产信号的监控与可视化。

技术 › LLM Annabell 2026-09-245.7 KB 59.9K 171 70

Your users are already evaluating your AI

文章介绍了在 LLM/Agent 产品中,除了搭建在线评估器之外,更应优先捕获用户评判信号(signals of judgment)。用户在使用过程中已通过行为在'评判'AI 输出质量,只需在应用中埋点捕获。信号分为四类:显式评分(点赞/星级,明确但稀少)、行为信号(复制、重新生成、放弃等,覆盖率高)、会话信号(改写问题、纠正、要求转人工等)和结果信号(草稿被原样发送、工单保持关闭等,最强但最难实现)。文章还讨论了信号解读方法:负信号值得逐条排查,正信号只看趋势;以及自我选择、幸存者偏差、界面曝光、群体差异等固有偏差,提醒不要单以正信号为优化目标。

技术 › LLM Lotte 2026-09-1711.5 KB 8.9K 63 86

Harness Engineering: 2026年取代提示词工程的核心技能

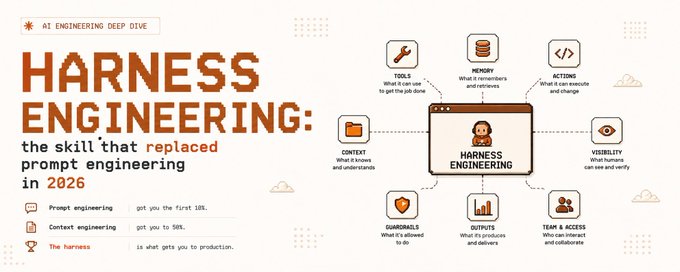
文章指出,2024年的核心技能是提示词工程,2025年是上下文工程,而2026年两者已被吸收进Harness Engineering。88%的企业AI Agent项目无法上线,问题几乎不在模型,而在模型外围的执行层。作者详细阐述了生产级Harness的七层架构:工具编排(草稿-提交模式防止危险操作)、验证循环(制作者与检查者分离)、上下文与记忆管理、护栏(行为/数据/工具/运营四类控制)、可观测性等。并以Anthropic Claude Code质量退化为案例,说明问题源于Harness层而非模型本身,强调Harness设计才是AI Agent产品质量的决定性因素。

技术 › Harness Engineering chuplung 2026-09-1515.5 KB 1.3M 552 78

如果你想做 AI 应用不妨考虑一下 Harness 开发

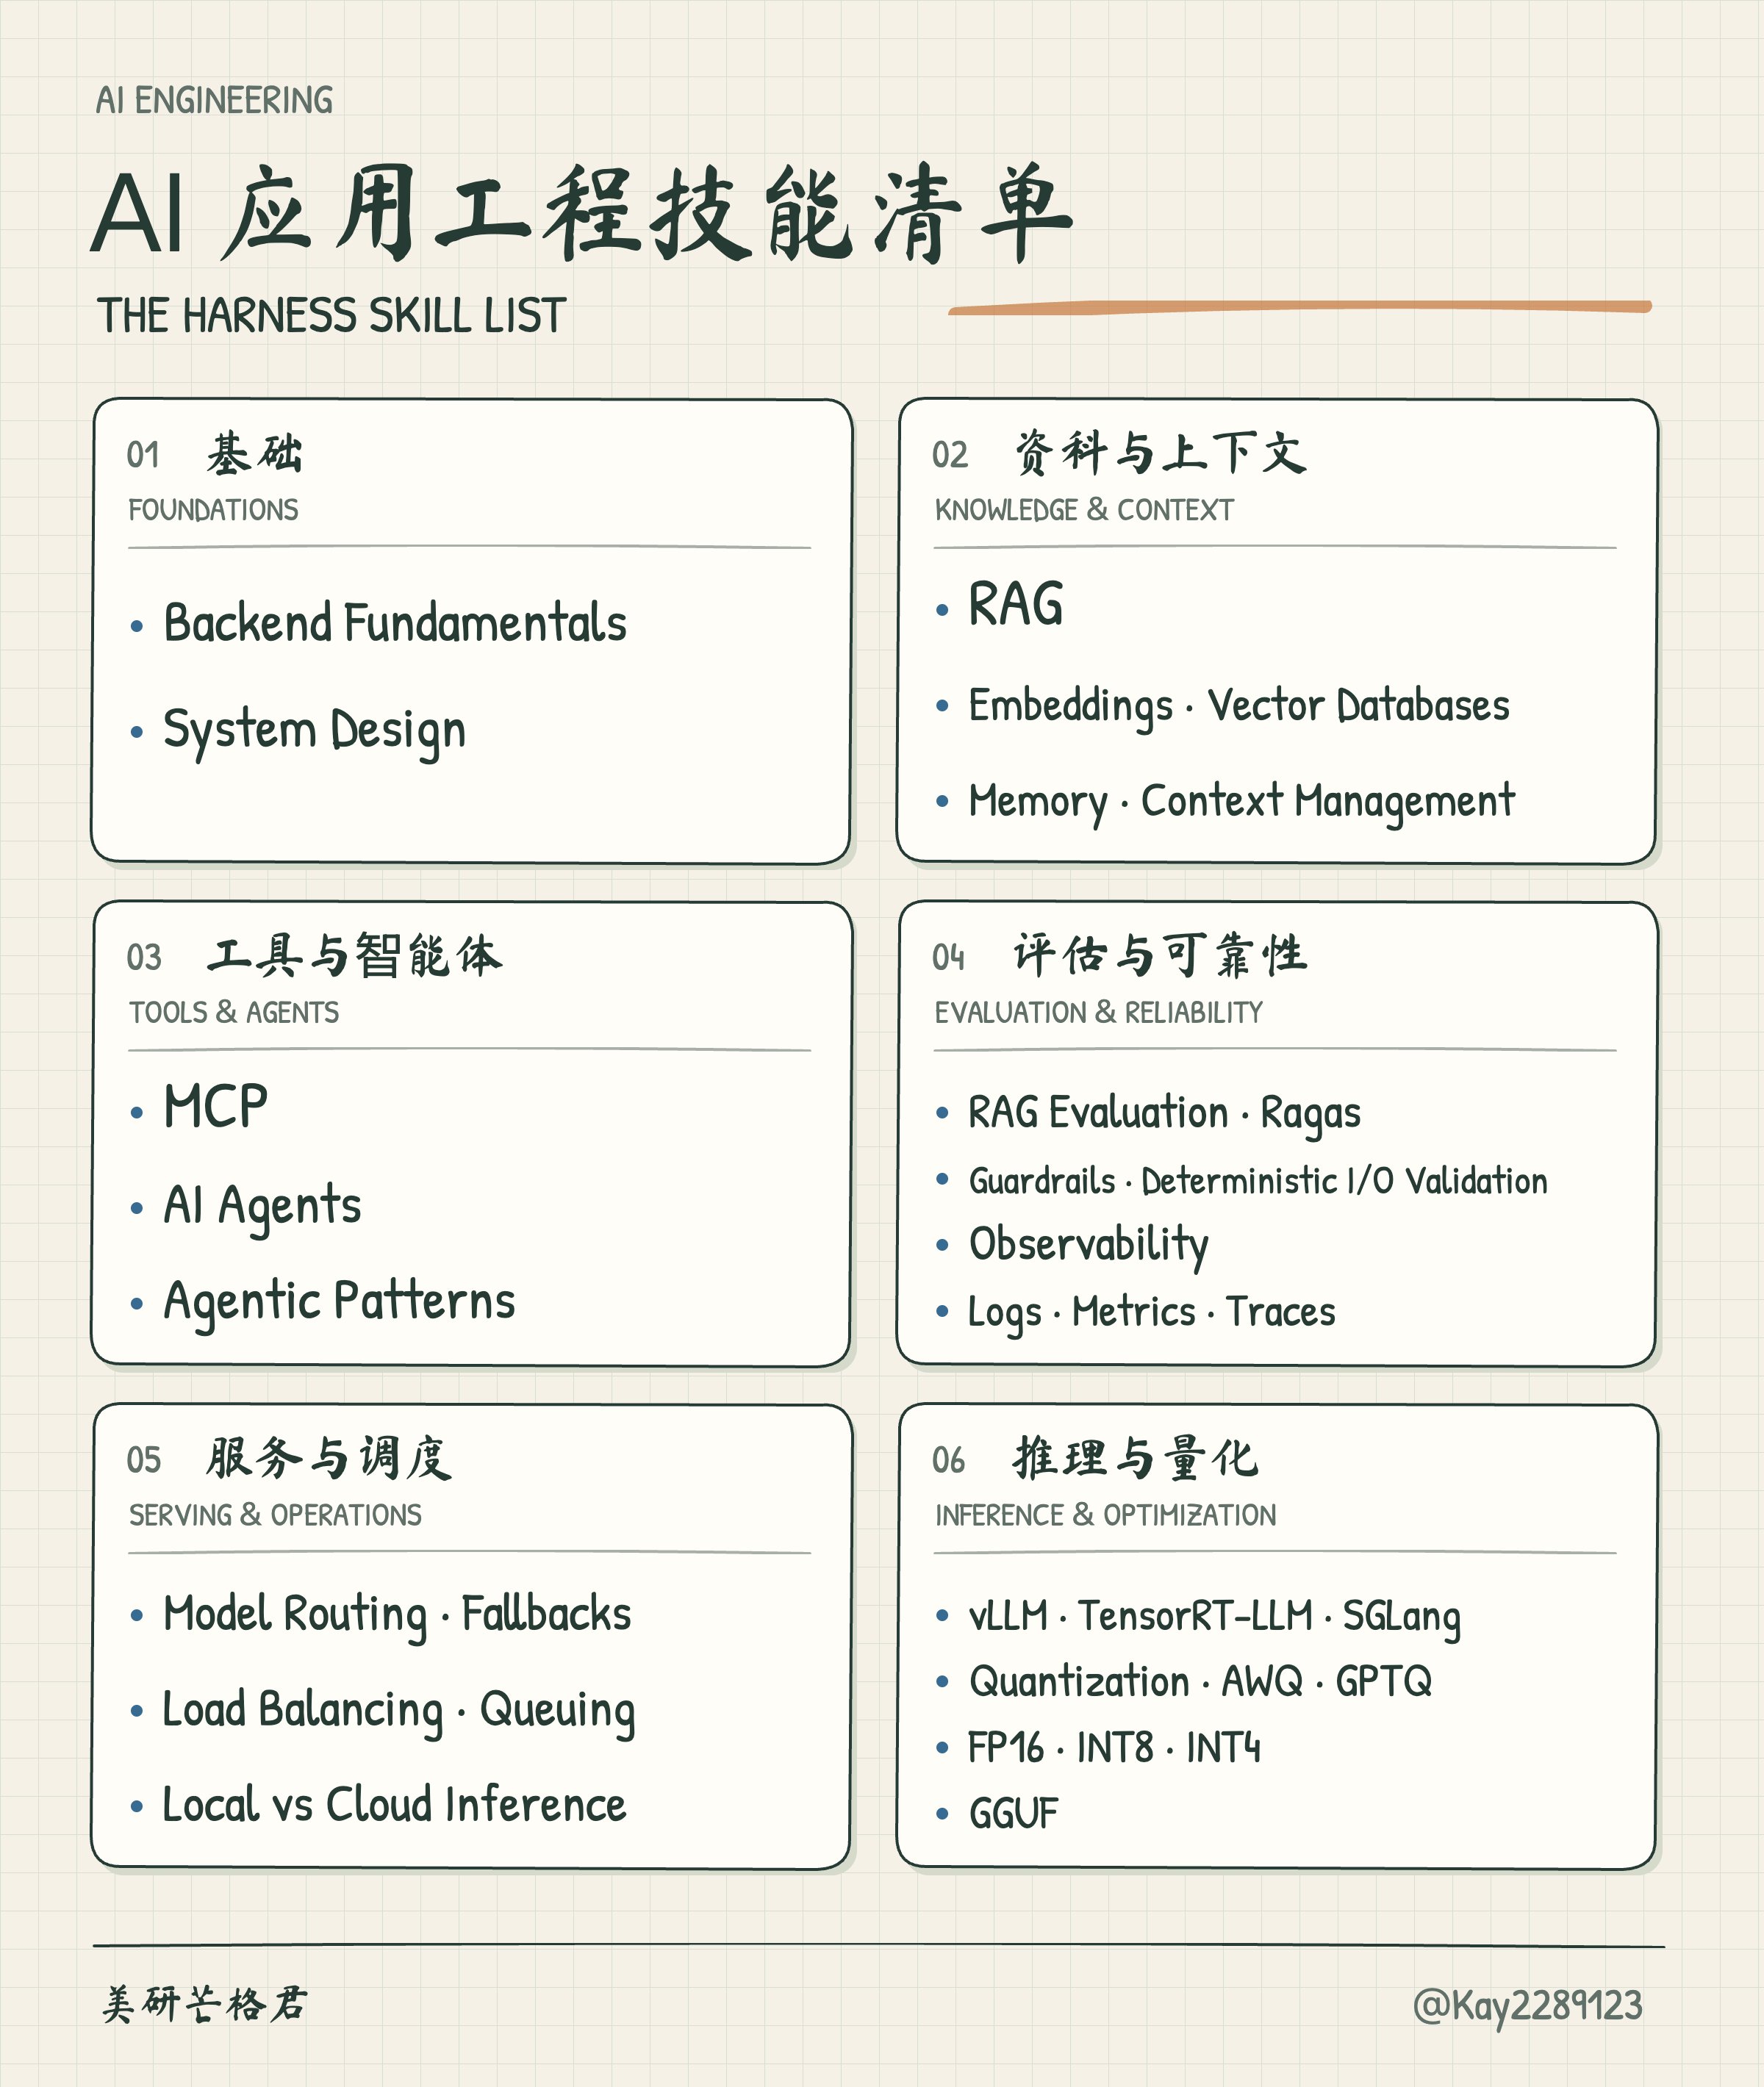
作者结合实际工作经验,整理出一份 AI Harness 开发的 11 条技能清单,涵盖后端与系统设计、RAG 与向量数据库、记忆与上下文管理、工具调用与 MCP、Agent 编排、护栏校验、评测、可观测性、模型路由降级、排队负载均衡以及推理部署引擎。作者指出 Harness 开发是硅谷热门方向(如 YC Demo Day 上大量项目),建议普通开发者从 AI 应用入手,把模型接入具体业务,并给出将清单交给 AI 逐项学习的 prompt 方法。

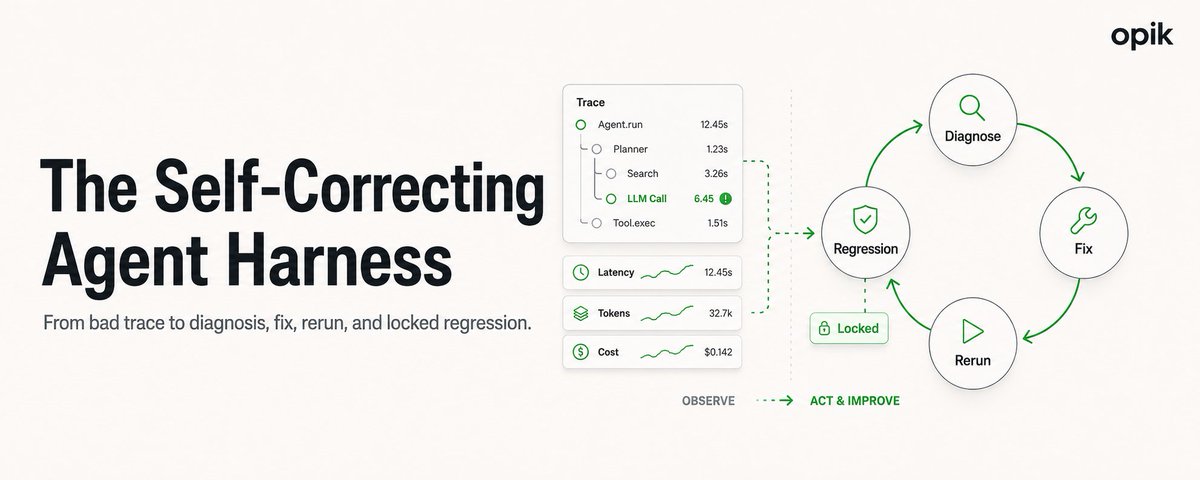
你的 Agent Harness 应该自我修复

文章探讨了 Agent 系统如何在不更新模型权重的情况下实现自我改进。作者提出两条独立回路:成功运行可产出可复用流程(如 Hermes 的 SKILL.md 程序性记忆),失败运行可产出经审查的修复和回归用例。通过 Opik 工具链,生产失败被转化为结构化反馈:trace 记录、源码级诊断、人工批准 diff、重跑验证、回归测试。文章强调改动需版本管理、评估需确定性校验器,系统并非自动学习,而是把事故变成可审查的改进输入。

技术 › Agent yibie 2026-09-1310.3 KB 2.5K 20 77

The software factory stack

本文由 Zach Lloyd 撰写,详细介绍了 Warp Factories 的软件工厂基础设施栈设计。该栈基于开放、可组合、代码定义的原则,分为五层:Factories-as-code(工厂即代码)、Data and context(数据与上下文)、Compute(计算)、Inference(推理)和 Improvement(改进)。文章逐层阐述了各层的核心组件与设计理念,强调版本化、可测试、可回滚的工厂定义,以及支持多模型、多代理、自托管和持续改进的基础设施,旨在帮助团队向工厂模式转型。

技术 › DevOps Zach Lloyd 2026-09-1013.4 KB 35.8K 351 79

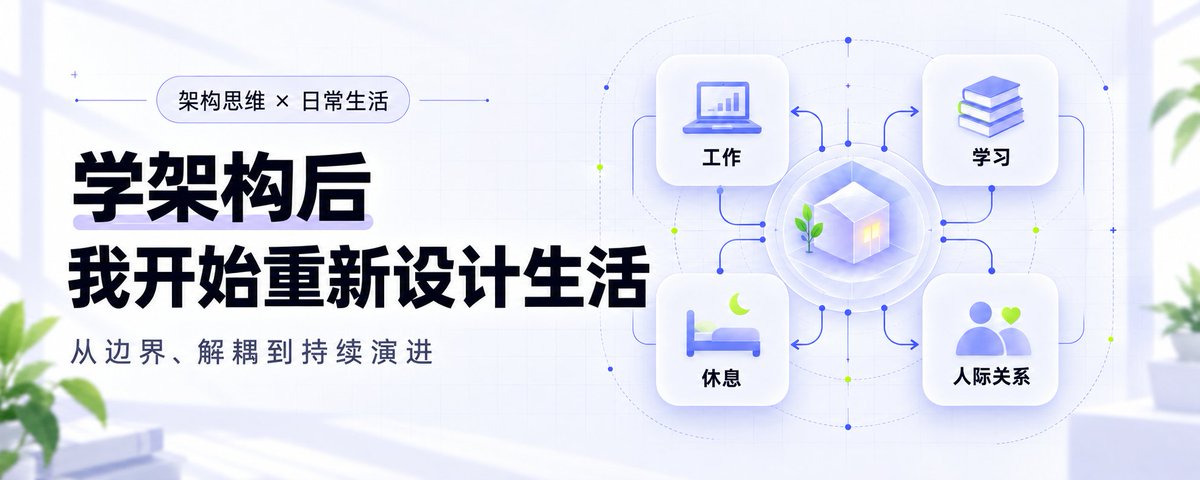
学习软件架构以后,我开始重新设计自己的生活

作者在备考软件架构师的过程中,发现架构思维不仅适用于技术系统,也能用于重新设计生活。文章将关注点分离、高内聚低耦合、模块化、接口契约、冗余设计、单点故障、容错降级、可观测性、性能瓶颈、缓存、异步思维、最小权限、权衡、避免过度设计、架构演进等软件架构原则,逐一映射到日常生活场景中,探讨如何用系统思维替代自责与蛮力,让生活更有弹性、更可持续。

生活 › 随笔 y y 2026-09-0929.5 KB 78

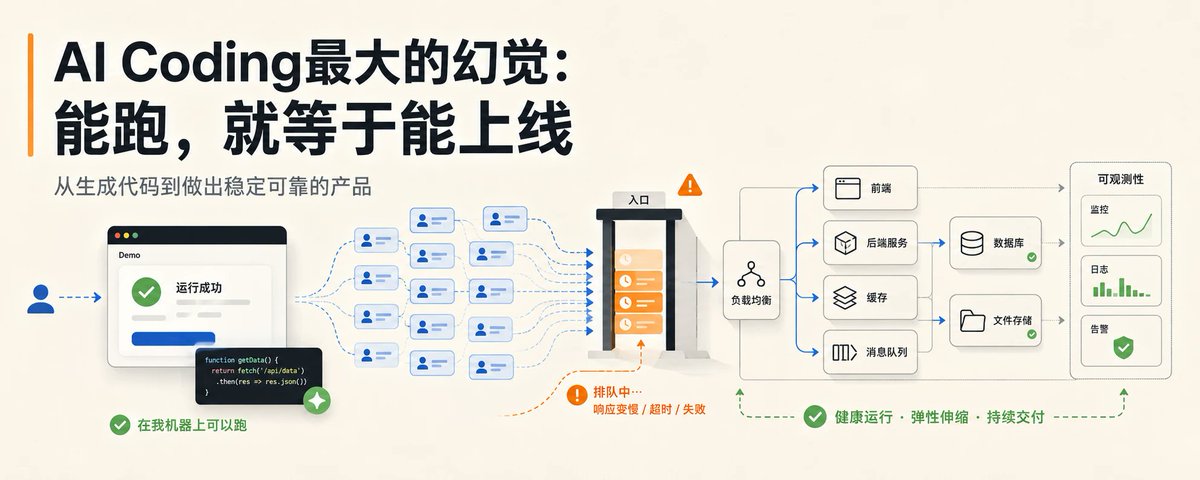
Ai Vibe Coding:小白也能看懂的产品稳定性教程

文章以面包店从街角小店成长到全国连锁的故事为比喻,系统讲解网站如何应对用户增长与稳定性挑战。从单体架构(一台烤箱)讲到垂直扩展、数据库索引、N+1 查询优化、缓存与缓存失效、水平扩展、负载均衡与自动扩缩容,再延伸到 Docker 容器化、CI/CD、可观测性、读写分离、微服务拆分、CDN 内容分发,以及限流、队列与异步处理等高并发应对手段。用通俗类比帮助零基础读者理解前后端、数据库、缓存等核心概念,掌握系统扩容与稳定性的基本方法论。

技术 › 后端 苏乐 2026-09-0333.6 KB 55.2K 67 79

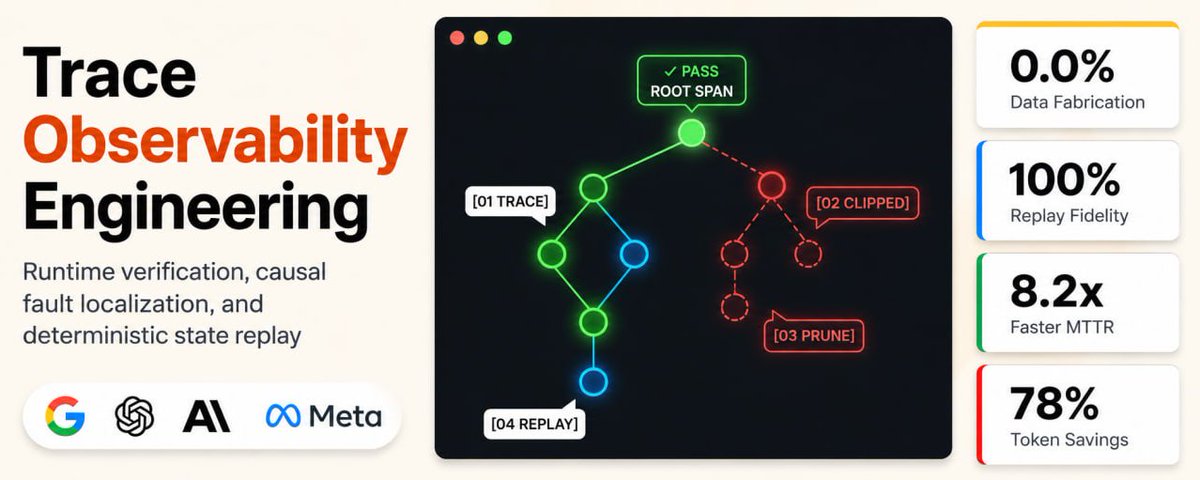
Trace Engineering: 自主 AI Agent 的可观测性架构

文章指出生产环境中多 Agent 系统的故障调试不是提示词问题,而是分布式系统可观测性问题。作者提出 Trace Engineering 架构,区分了日志、轨迹与分布式执行追踪三种对象:日志记录文本输出,轨迹记录顺序对话轮次,而追踪以 DAG 形式刻画因果图,支持并行分叉与子 Agent 委托。文章进一步阐述确定性重放与因果状态重建,通过事件溯源(append-only 事件账本)记录工具载荷、随机种子与采样参数,实现 Mocked Replay(离线零成本验证)与 Live State Resumption(从快照恢复现场)两种调试模式,避免不可控的递归重试烧毁大量 Token 成本。

技术 › Agent marfin 2026-08-3127.6 KB 264.1K 207 76

构建弹性生产级 Agent Harness 的 5 层架构

文章指出 Agent 可靠性的关键在于模型之外的确定性软件基础设施,即 Harness Engineering。作者提出构建弹性生产 harness 的 5 层方法:1)从模型优先转向系统优先架构,结构化工作流可将任务完成率从 31.7% 提升至 78.0%;2)实现持久化状态与检查点,避免长时间运行中丢失进度;3)通过角色分离(规划者、生成者、评估者)构建验证闭环;4)利用 hooks 和隔离运行时(如沙箱、网关)确保安全边界,防御提示注入;5)记录结构化追踪便于调试与自动化修复。文中结合 Google Antigravity、ADK 2.0、Gemini Enterprise 等工具给出实践建议。

技术 › Harness Engineering Google Cloud Tech 2026-08-298.7 KB 35.7K 263 81

BestBlogs 早报 · 08-29|AI 原生开发重排团队,LLM 网关直面故障取舍

本期早报精选 AI 工程领域三篇精讲:Amazon 50 个工程团队试点揭示 AI 原生开发的关键在于重构上下文、代码库与验证机制,而非简单叠加工具,高表现团队生产力提升可达 4.5 倍以上;Twilio 分享生产化 LLM 网关经验,指出可用性、延迟、护栏与成本无法同时最大化,需按业务路径做故障取舍;斯坦福研究者通过 J-space 实验探讨 AI 可解释性,区分看见、验证与控制三个层次。速览部分涵盖 AI 推理成本优化、Uber 多智能体代码审查、Figma MCP Server、Context Engineering 及 Spring 可观测性等实践。

技术 › LLM ginobefun 2026-08-2928.0 KB 5.3K 2 83

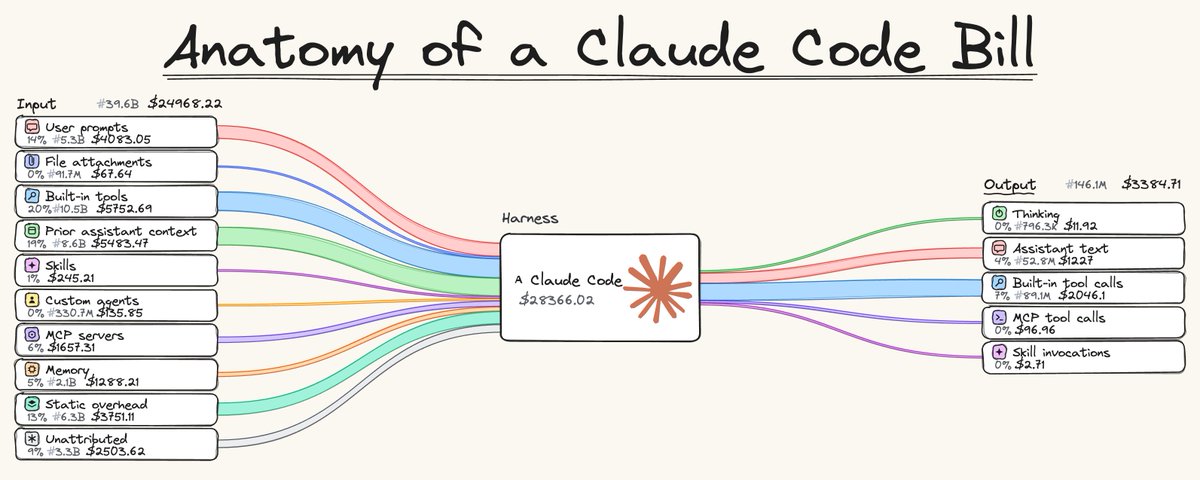
The Anatomy of a Claude Code Bill

本文基于对45人工程团队30天的Claude Code使用追踪,剖析了其账单构成:真实用户提示仅占输入token的14%,其余为静态系统开销、CLAUDE.md与Skills、MCP服务器schema、工具结果回放及历史上下文等配置性开销。文章指出Uber等大规模部署中人均月支出高达500-2000美元,并介绍了Comet在Opik中推出的Cost Intelligence代理插件,通过token级可观测性帮助团队识别浪费,15分钟审计可削减20-40%账单。

技术 › Claude Code Akshay 2026-08-2412.8 KB 18.1K 139 75

如何构建可持续维护的评估集

本文介绍了如何为AI Agent构建可长期维护的评估(eval)指标体系。指标分三类:目标指标、护栏指标和运营指标,三者结合使用。候选指标来源于错误分析和产品目标与硬约束。并非所有候选都值得跟踪:一次性问题用prompt修改解决即可,只有需要持续追踪的泛化问题才建指标;每个指标必须与具体决策挂钩,否则就是噪音。从零开始时,可先阅读30-50条trace并用自由文本笔记聚类失败模式。此外需定期重跑错误分析、退役失效指标,并警惕Goodhart定律导致的过拟合。

技术 › LLM Lotte 2026-08-198.4 KB 89.1K 476 83

现代SaaS架构:软件公司的实用指南

本文探讨了现代SaaS架构的关键决策,强调架构选择应从一开始就考虑合规性、可扩展性和可观测性。文章指出,SaaS架构模型不是终点,而是通往可扩展业务成果的道路。作者建议使用AWS Well-Architected框架的SaaS Lens来指导部署模型、可观测性、租户隔离和合规性等决策。文章详细比较了单租户、多租户和混合架构的优缺点,并强调了可观测性(日志、追踪、指标)和租户隔离的重要性,提供了在AWS上实现这些目标的工具和方法。

技术 › 后端 Amazon Web Services 2026-08-1115.4 KB 78.7K 440 75

7 rules for self-improving agent loops every AI engineer should know

本文介绍了自改进智能体循环的七条规则,强调在智能体编写代码时,定义“好”的标准才是真正的工程工作。文章指出,循环可以自动化一切,但无法告诉你“更好”意味着什么,因此指标成为你编写的工件。通过自定义指标(如 retention_offered)和分级(grading)打破循环的盲目性,并利用 agents-cli 工具实现测量与改进的自动化。七条规则包括:从单一案例开始、让评判者解释原因、对确定性答案使用代码、评分行为而非路径、将不稳定案例视为发现、防止提议者移动标准、最后进行一次性自动优化。这些规则确保人类保持对自动循环的控制,并使评估与可观测性统一为同一循环的两种采样方式。

技术 › Agent Google Cloud Tech 2026-08-119.9 KB 127.1K 83

你的 Agent 框架应该能够自我修复

文章探讨了AI Agent在生产环境中失败时,传统可观测性工具仅能提供追踪数据,而无法自动解决修复问题的瓶颈。作者介绍了开源平台Opik,它通过四层架构(Tracing追踪、Ollie诊断与修复、Test Suites测试集、Agent Sandbox沙盒)形成闭环。该平台能自动诊断错误链路,内置代码代理提出修复方案,并将真实失败转化为回归测试,从而实现Agent框架的自我修复与持续优化。

技术 › Agent Akshay 2026-08-099.9 KB 1.8M 1.6K 84

Harness Engineering:构建决定AI Agent可靠性的七层架构

文章指出,AI Agent的可靠性不取决于模型权重,而取决于周围的脚手架(Harness)。Harness分为七层:执行环境、工具接口、上下文管理、编排与生命周期、可观测性、验证和权限边界。这七层都是需要编写和版本控制的代码,而非模型属性。此外,Harness还分为由模型构建者提供的内部Harness和开发者自行组装的外部Harness。

技术 › Agent zostaff 2026-08-0920.2 KB 26.4K 45 88

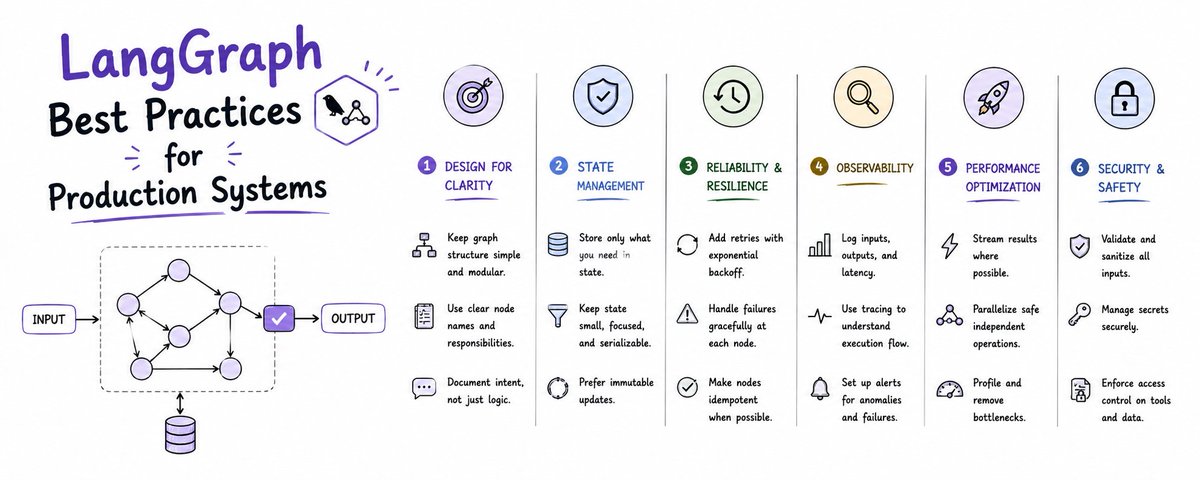
LangGraph 生产环境最佳实践

本文总结了将 LangGraph 智能体从原型推向生产环境的最佳实践。针对高并发、连接池耗尽等线上常见故障,文章提出了四大核心支柱:状态与检查点管理、系统可靠性(含重试与人类介入)、可观测性及部署扩展。作者详细解析了如何科学设计状态结构、正确选择 Postgres 检查点策略与线程隔离,并提供了避免无限工具循环、实现幂等性恢复的健壮代码模式,助力构建稳定可靠的线上系统。

技术 › Agent Vikas gupta 2026-08-0922.0 KB 8.5K 18 92

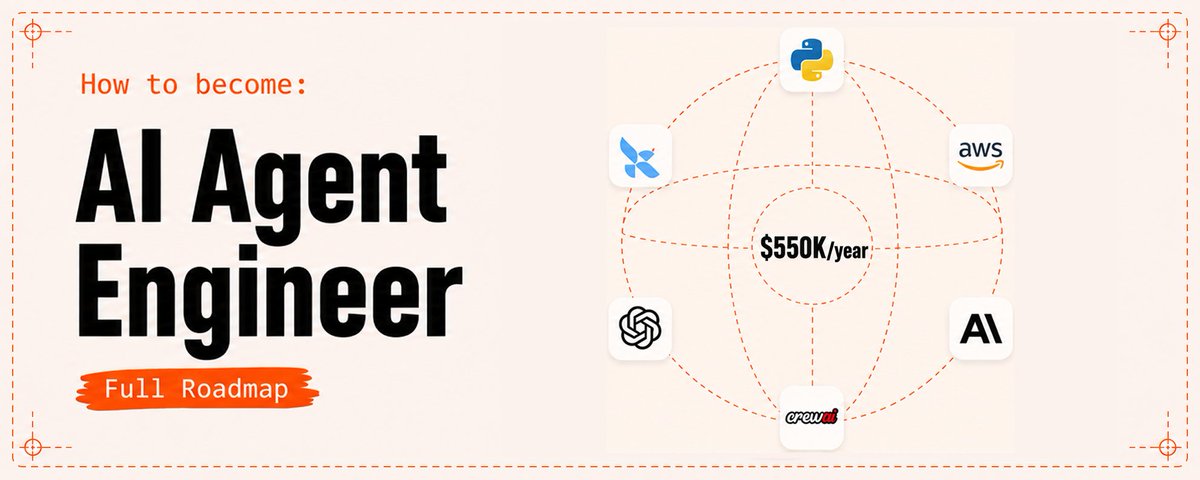
2026年AI Agent工程师成仙指南:通往55万美元年薪之路

随着AI技术的进步,市场对AI Agent工程师的需求呈爆炸式增长,相关岗位年薪高达18.5万至55万美元。与传统的问答型AI不同,Agent工程师的核心职责是设计能执行实际操作的系统并使其在生产环境中稳定运行。文章提供了详尽的职业进阶路线:首先需掌握Python、后端API开发等软件工程基础;其次熟练使用LangChain、RAG及大模型API等专属AI技术栈;最后,必须具备系统可观测性和评估能力。作者强调,拥有包含完整监控和复盘报告的真实部署项目,是求职者脱颖而出的关键。

技术 › Agent Chrome 2026-08-0713.4 KB 66.6K 56 83

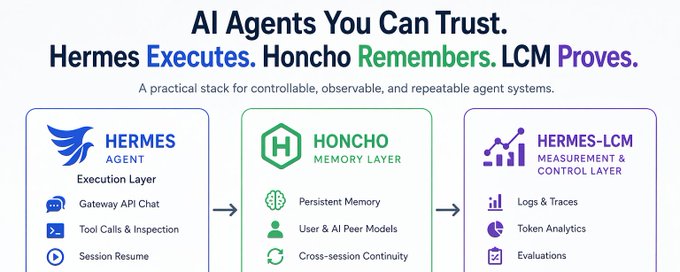
Hermes Agent 智能化升级:集成 Honcho 与 Hermes-LCM 构建可控系统

文章介绍了一种通过集成 Honcho(自托管记忆层)和 Hermes-LCM(测量控制层)来升级 Hermes Agent 的技术架构。该方法解决了传统 AI Agent 容易遗忘上下文、缺乏可观测性和难以在生产环境中复现的问题。通过建立执行(Hermes)、记忆和验证(LCM)的三层体系,构建了一个具备持续上下文、透明操作和可重复结果的可靠 AI 系统。

技术 › Agent d david bayendor 2026-04-2214.0 KB 71

Agentic 生产级工程实践的 4 个坑

作者基于 Figma 设计稿转代码项目的实战经验,总结了 Agent 开发的四个关键坑点:一是避免让昂贵的大模型做“脏活”,应将固定流程脚本化以节省 Attention;二是 Skill 只是软约束,长上下文会稀释早期指令导致步骤跳过,需拆散流程但会增加上下文传递成本;三是强调可观测性的重要性,缺乏可视化的 Pipeline 盲目跑测试集只会浪费 Token;四是人类不能仅做监督者,需深度思考并跑通流程以引导 AI。

技术 › Agent Kieran Zhang 2026-04-173.5 KB 30.8K 32 70