Harness 是组合泛化器
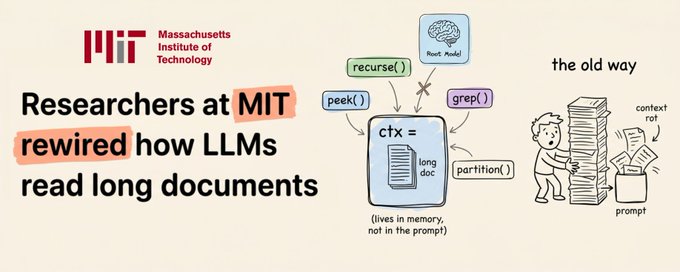
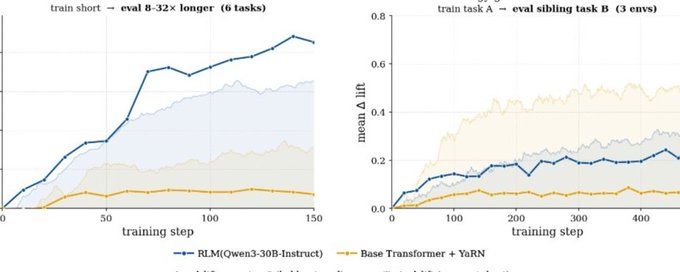
本文介绍 Alex L. Zhang 与 Omar Khattab 提出的观点:Transformer 不擅长组合泛化,而更好的泛化应主要由 harness 完成。Harness 位于外部世界与神经网络之间,通过 context offloading(上下文卸载)和程序化子 agent 调用两个机制,让每次 LM 调用看到的观察处于训练分布内(LID),把复杂、陌生的问题归约为简单、熟悉的问题。实验基于 Qwen3-30B 的递归语言模型(RLM)显示在长度泛化和跨域策略泛化上远胜裸 Transformer,30B RLM 甚至可逼近 GPT-5.5。作者提醒不要手工硬编码 harness 结构,数据 scaling 仍是最大驱动力,但 harness 决定 scaling 系数。