Wiki 知识库

全部文档 / 标签: 低延迟

6 篇
清除

如何使用 Gemini Live API 构建实时语音 AI Agent

本文介绍如何使用 Gemini Live API 构建具备自然对话体验的实时语音 AI Agent。与传统的单向 TTS 不同,Gemini Live 采用音频到音频的双向通信,能感知语气、停顿并支持随时打断。文章详细讲解了系统架构:浏览器客户端通过 WebSocket 连接 Python 后端,再与 Gemini 建立持久双向会话,并实现发送、接收、播放的并发核心循环。针对打断延迟问题,作者提出本地立即静音的 barge-in 技巧,并结合内置 VAD 实现即时响应。最后通过工具调用(function calling)与异步确认模式,让语音 Agent 能够播放音乐等实际操作且不产生尴尬停顿。完整示例代码已在 GitHub 开源。

技术 › Agent Annie Wang, Annie Cusack (Google Cloud) 2026-09-248.3 KB 35.9K 326 82

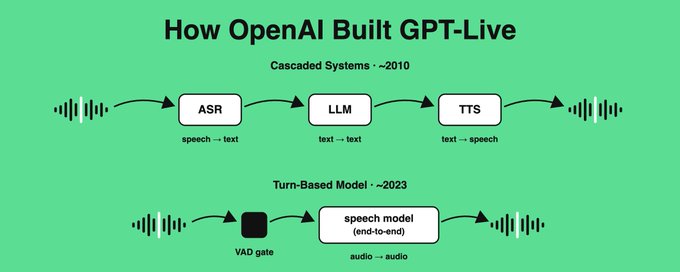
How OpenAI Built GPT-Live

本文深入解析了 OpenAI GPT-Live-1 全双工语音模型的架构原理。文章回顾了语音系统的三代演进:级联设计(ASR+LLM+TTS 串联,存在信息丢失和延迟叠加问题)、轮次式端到端语音模型(保留语气情感但依赖 turn detector,容易不自然)、以及全双工架构(模型同时监听和说话,沉默也是一种 token)。GPT-Live 通过将思考从说话中委托出去,保持语音模型小而快以实现毫秒级响应,同时依赖服务端系统的低延迟优化。文章还讨论了全双工系统的评估方法与实时系统工程经验。

技术 › TTS Alex Xu 2026-09-2320.7 KB 83.3K 507 70

Building low latency, streaming voice agents

本文介绍 Google 最新的语音转文本模型 Gemini 3.5 Transcribe,重点讲解其实时流式端点 gemini-3.5-transcribe-live 如何通过 WebSocket 以亚秒级延迟实现低延迟语音交互。作者以实时辩论代理为例,展示如何结合 Agent Development Kit (ADK) 构建多智能体流水线:在用户仍在说话时流式获取中间转录结果,经 Gemini 3.7 Flash 做意图过滤,后台并行触发 Google Search grounding 检索证据,最后通过 Cloud Text-to-Speech 生成自然语音回复。该模式支持 85+ 语言,适用于会议实时查证、呼叫中心坐席辅助、交互式语音机器人、直播字幕等场景,消除了传统语音应用的等待延迟。

技术 › TTS Wei Hsia 2026-09-118.7 KB 30.1K 208 74

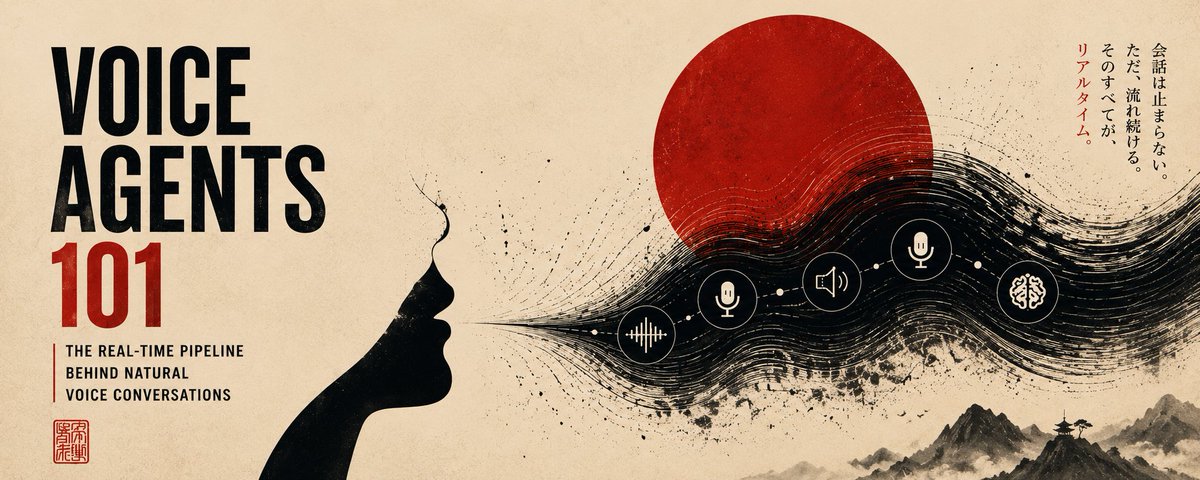
如何构建 AI 语音代理:全流程指南

文章揭示了构建语音代理的核心要素:并非追求最强模型,而是建立低延迟的实时管道。作者阐述了三种主流架构,并详细拆解了链条式流程中 STT(听力)、LLM(大脑)、TTS(嘴巴)、检索(记忆)与执行(手)这五个关键组件的选型、调优与避坑指南,强调对话设计的重要性。

技术 › Agent Avid 2026-05-1951.0 KB 545.5K 297 88