Wiki 知识库

全部文档 / 标签: ASR

16 篇
清除

FDE 实战案例:海量多模态数据清洗成可信数据的八步方法

作者以美妆企业 FDE 落地项目为例,讲解如何将小红书、抖音、视频号、微博等平台采集的多模态数据(文字、图片、音频、视频)清洗成一套可信、可查询的结构化数据。文章提出八步通用链路:定数据规范、保留原始内容、梳理用户/帖子/评论关系、多模态归一处理、冲突与质量清洗(含证据分级)、生成结构化数据、执行验收、按规则和版本入库。文中还给出 OCR/ASR 工具选型建议(FFmpeg、PaddleOCR、Whisper 等)以及大模型结构化输出的实践经验。

技术 › 后端 Miles Ma 2026-10-2712.9 KB 5.8K 61 86

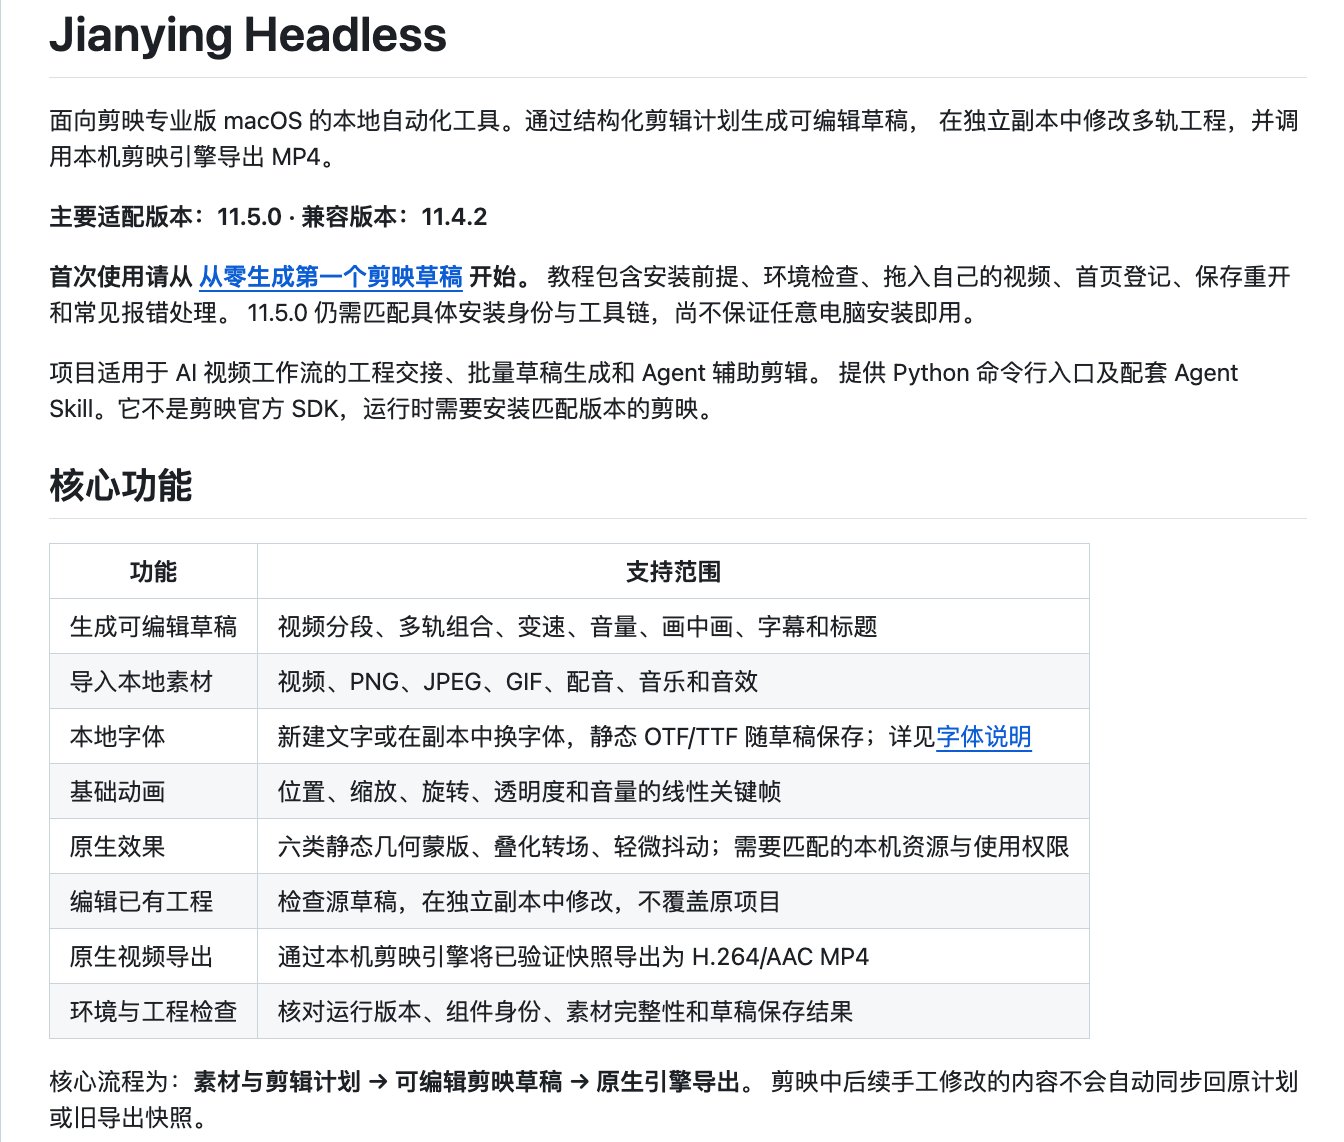
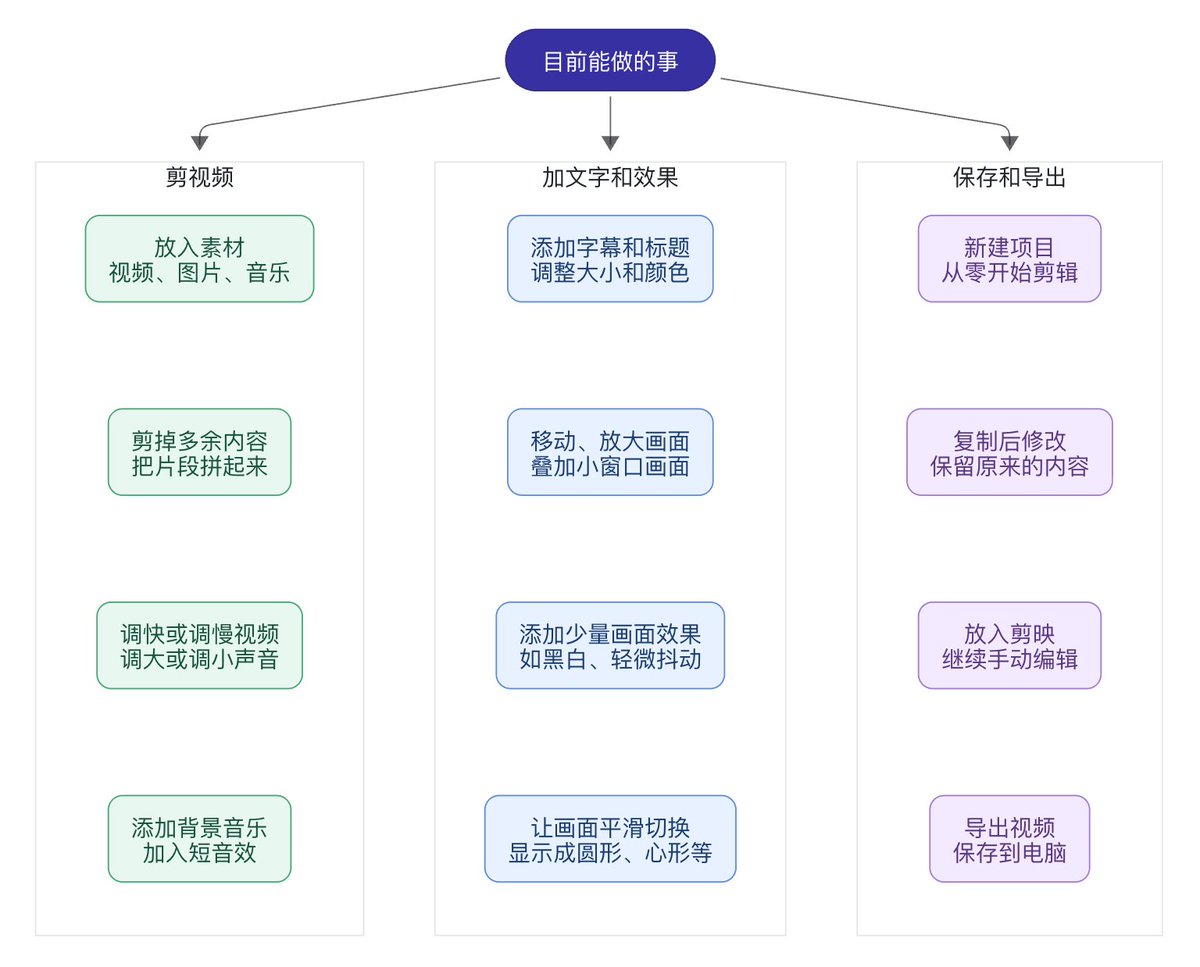
无头剪映和剪映Skill大升级

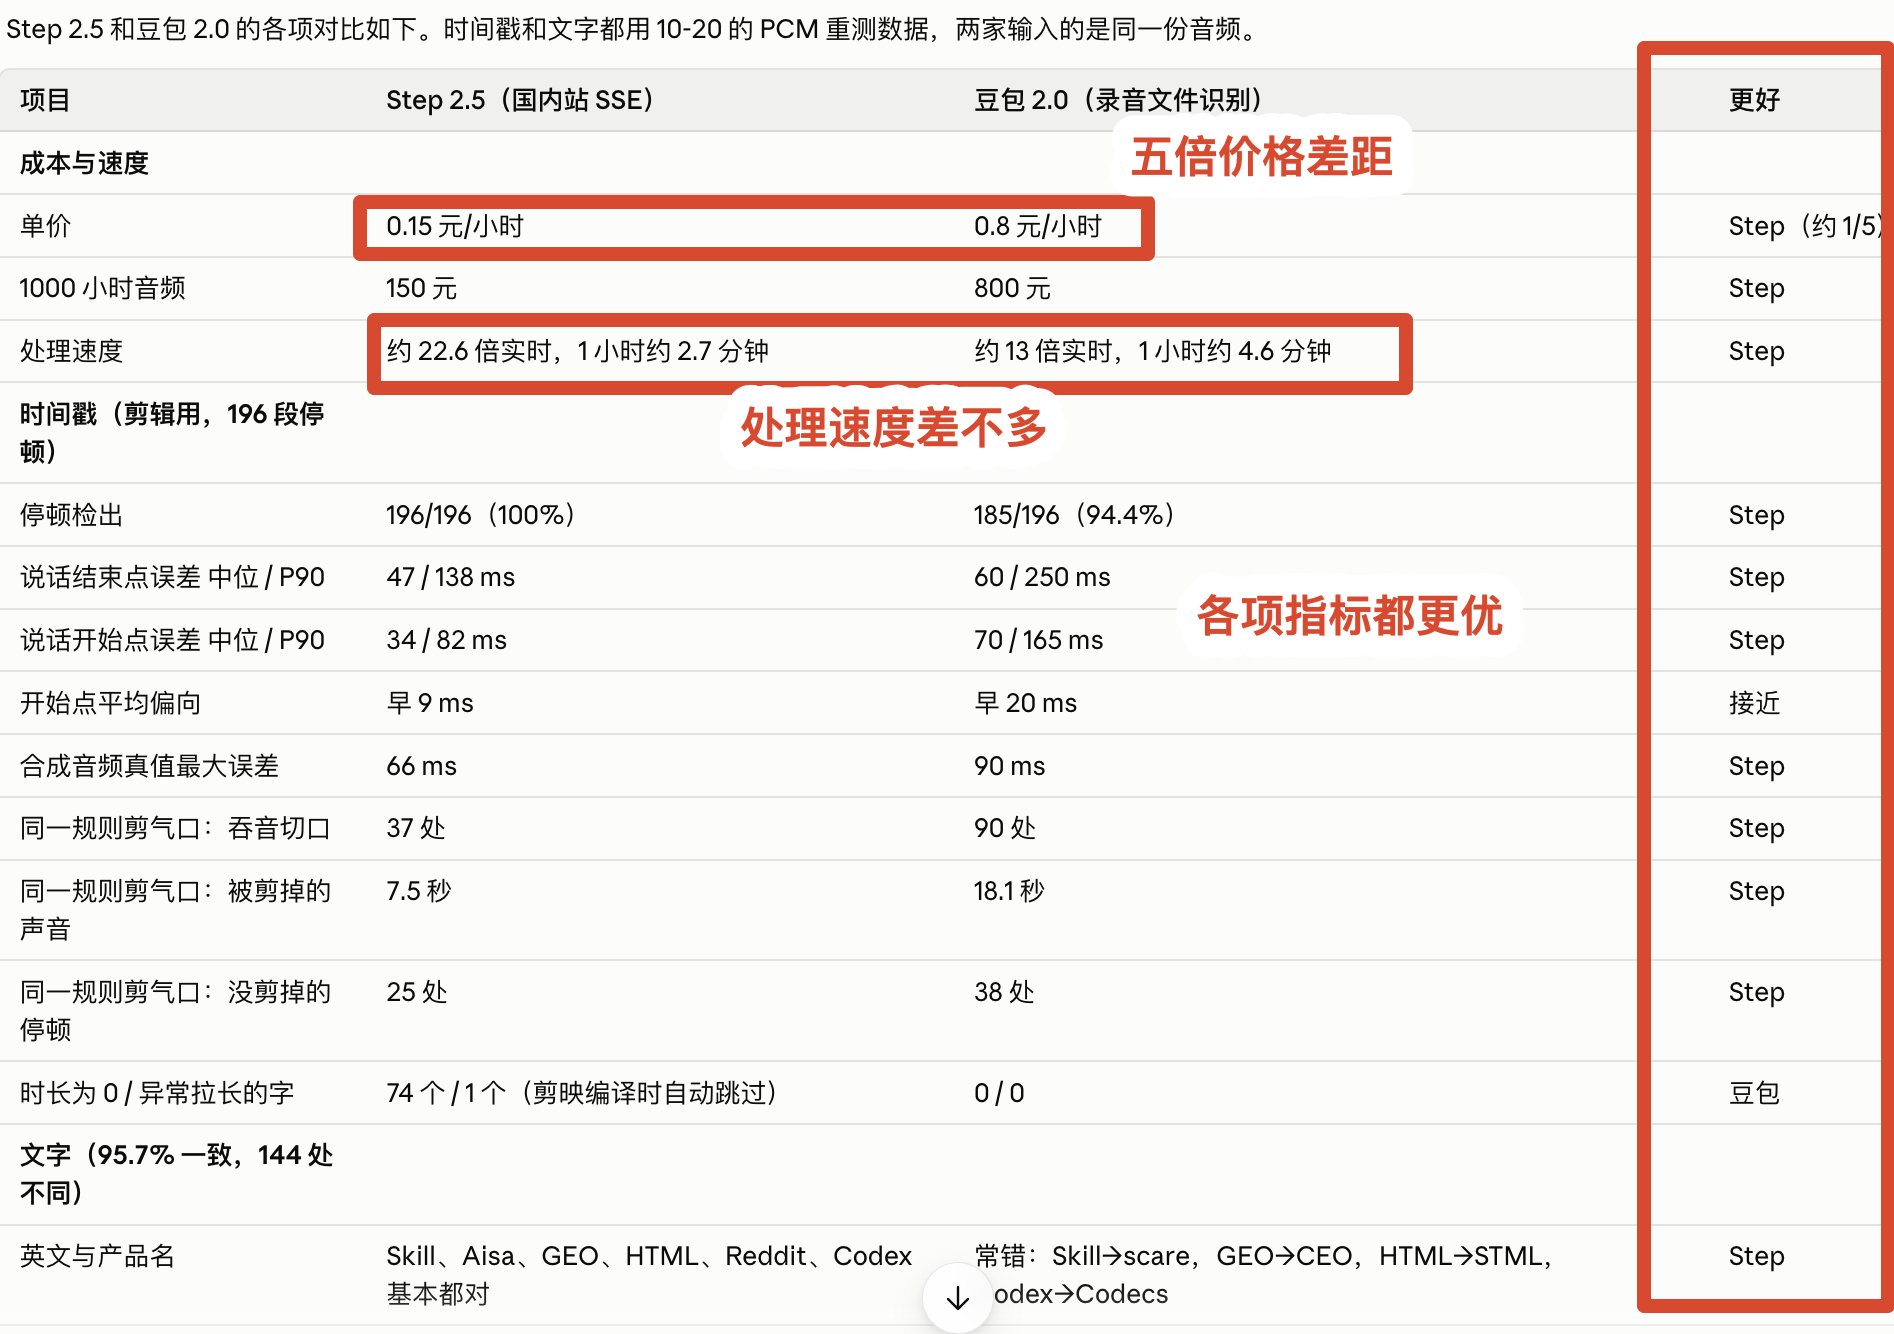
作者发布无头剪映和配套剪映Skill的重大升级:1) 适配剪映11.6.0并继续兼容11.5和11.4.2版本;2) 接入Openverse,提供超过520万个免费音频文件用于视频音效;3) 将ASR模型从豆包切换到Step 2.5,成本降低五倍至0.15元/小时,支持毫秒级输出。作者分享了剪映11.6.0永久安装包网盘地址及无头剪映的GitHub开源地址,并展示了将口播类视频剪辑全程托管给Codex的自动化能力。帖子回复中作者还确认该工具可配合Claude Opus 5.5实现长视频精彩片段自动提取剪辑,Windows版本也即将推出。

技术 › Skill 逸尘 (@gengdaJ) 2026-10-214.1 KB 75

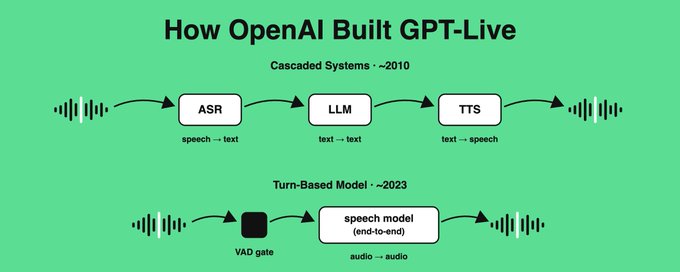
How OpenAI Built GPT-Live

本文深入解析了 OpenAI GPT-Live-1 全双工语音模型的架构原理。文章回顾了语音系统的三代演进:级联设计(ASR+LLM+TTS 串联,存在信息丢失和延迟叠加问题)、轮次式端到端语音模型(保留语气情感但依赖 turn detector,容易不自然)、以及全双工架构(模型同时监听和说话,沉默也是一种 token)。GPT-Live 通过将思考从说话中委托出去,保持语音模型小而快以实现毫秒级响应,同时依赖服务端系统的低延迟优化。文章还讨论了全双工系统的评估方法与实时系统工程经验。

技术 › TTS Alex Xu 2026-09-2320.7 KB 83.3K 507 70

剪映推出 Agent,逸尘逆向项目开源实现无界面控制剪映

剪映官方推出 Agent,走封闭全家桶路线,能力仅限软件内并售卖 AI 会员。与此相反,逸尘开源的逆向项目 jianying-headless 将剪映控制权交还外部 Agent:可用 Codex 一条指令批量粗剪、加字幕、配 BGM;借助 DeepSeek 和豆包 ASR,一小时视频成本不到一块钱;生成的是剪映原生工程文件,可随时人工微调。作者认为这是目前最自由、成本最低的视频剪辑自动化方案,并建议大家尽快 Fork 以防项目被下架(404)。该项目替代了此前用 Computer Use 模拟鼠标操作的笨办法。

技术 › Agent 余温 (@gkxspace) 2026-09-212.2 KB 67

用开源实时 ASR 模型 Confucius4-R2T2 + Jev 平替英语流利说

作者介绍网易有道开源的实时流式 ASR 模型 Confucius4-R2T2 与 Jev 模型组合,可平替英语流利说的口语评测功能。R2T2 是真流式模型,以 160ms 间隔输出且具备 stable prefix 机制,保证已提交文本不被修改;Jev 则快速判断文本层面的漏读、多读和错读类型。两模型均为开源,可在 NVIDIA 显卡本地部署,适合在家朗读练习。作者也指出当前方案仅限文本层面纠错,读音纠错需接入音标识别模型,应对语序跳跃、替换词等复杂场景仍需更深入的声学模型支持。

技术 › LLM WquGuru (@wquguru) 2026-09-212.9 KB 75

剪映11.4.2开源:用Codex+Skill全自动剪辑口播视频

作者分享其逆向剪映的开源项目 jianying-headless,以及配套的 yichen-jianying-edit Skill。用户只需简单提示词,即可将口播类视频剪辑工作全程托管给 Codex 自动完成,无需人工操作。项目调用豆包 ASR 进行毫秒级语音切割,生成的剪映草稿即使有误也可人工微调。作者展示了8分钟视频自动剪辑为3分钟的对照效果。成本主要包括 Codex Token 费用(可用便宜模型替代)和豆包 ASR 费用(每小时约0.8元)。文中还提及 TradeWinds 社群第二期开放的消息。

技术 › Skill 逸尘 (@gengdaJ) 2026-09-184.9 KB 68

语音 agent 这 30 天:全双工落地,排行榜开始打假,生产数字出来了

本文汇总了近 30 天(8/16-9/15)语音 agent 领域的重大进展。核心变化包括:OpenAI 推出全双工语音模型 GPT-Live-1 进 API,替代传统 STT-LLM-TTS 三段拼接架构;一波新模型与产品密集发布(Tavus、Soniox、HeyGen、ElevenLabs 等);评测开始'打假',Jarvis Bench 把真人放进排行榜检验模型真实能力;Natera 公司首次公开生产环境语音 agent 的详实数据(成本、延迟、NPS 等);语音正从'对话层'演变为'编排层',成为调度多个 agent 的入口;开源与本地方案(Voicebox 等)蓬勃发展。

技术 › TTS yibie 2026-09-159.8 KB 3.9K 11 81

我预判月薪 1 万左右的剪辑手即将面临大裁员

作者黄赟预测月薪1万左右的剪辑师将面临大规模裁员。他使用 GPT-6 Astra Ultra + QWen3 ASR FileTrans,通过一条提示词将张元拆解抖音商业大V清华陈晶的11分30秒视频自动切分出6个观点切片,展示了AI自动剪辑的惊人效果。他引用了张元对陈晶880+视频的拆解要点:精准人群定位、账号起号标准(吸引、信任、转化)、内容不断层等。作者认为对于口播和连麦内容,视频切片与分发已可完全自动化,剪辑工作将大量被AI取代。

技术 › LLM 黄赟 (@huangyun_122) 2026-09-122.7 KB 41

网易叭哥说AI语音输入法评测:识别速度快到没朋友

作者对比了Typeless、闪电说、豆包输入法和网易新推出的叭哥说四款AI语音输入法。叭哥说采用双模型架构(ASR语音识别+纠错润色),实现E2E平均1683ms的极速识别,支持小声拾音、专业术语识别、个人词典导入、多语言翻译和粤语识别等功能。文章通过小声嘀咕、长Prompt输入、翻译等多个场景实测,认为叭哥说基本补齐了竞品的短板,并展望语音输入让人机交互回归自然口语表达的未来。

技术 › TTS 卡尔的AI沃茨 2026-09-1113.5 KB 36.9K 109 78

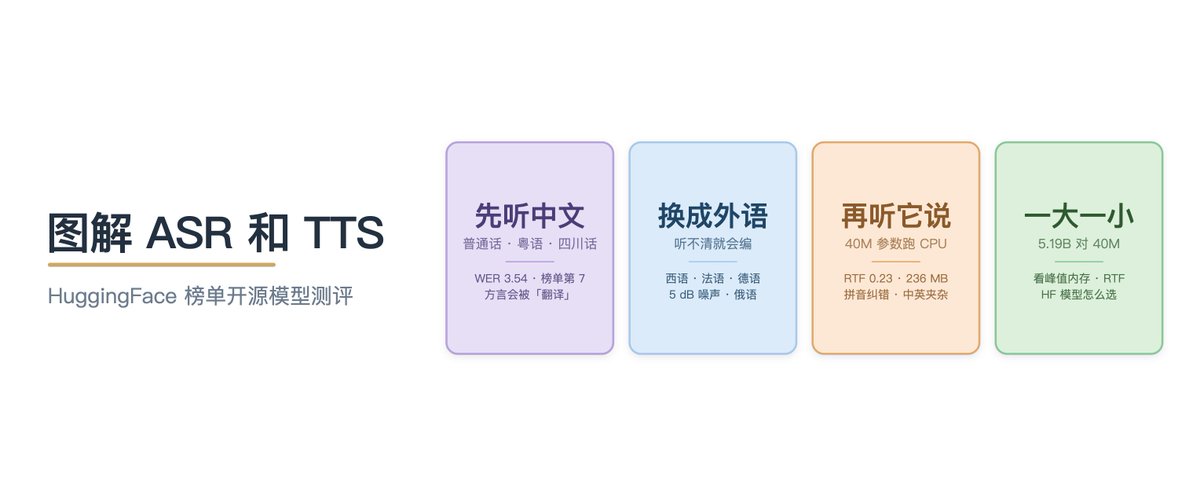
图解 ASR 和 TTS:HuggingFace 开源模型测评

作者实测了 HuggingFace 上多语种榜单第一、可本地部署的开源语音模型 Hojo-ASR-Multi-V1 和 Hojo-TTS-Light-40M。通过普通话、粤语、四川话及多国外语的实际听写测试,发现该 ASR 模型在普通话和粤语表现出色,但在方言虚词、专名和噪声场景下会出错;TTS 小模型在 CPU 上即可快速合成中英夹杂语音。文章还分析了模型体量、内存和 RTF 的关系,并给出不同场景下 ASR/TTS 开源模型的选型建议。

技术 › TTS WquGuru 2026-09-0514.2 KB 108.2K 105 86

让我们聊聊语音输入

Vokie 开发者 alan 介绍了这款面向 AI Agent 协作的语音输入工具的理念与功能。文章阐述了语音相比打字更开放自然的优势,并介绍 Vokie 的核心能力:基于深度调教的 ASR 模型实现高识别率并支持 20 多种方言;通过'热词学习'记住用户纠正的词汇;通过'中翻中'将口语转译为不同场景下恰当的书面文本,兼顾 Agent 指令、私人消息、工作沟通等不同需求。此外还支持小米和 Apple TV 遥控器输入以缓解'开口尴尬症',并提供插件让 ESP32 等硬件接入,拓展极客玩法。

技术 › 工具与效率 alan酱 2026-09-036.6 KB 6.6K 17 65

普通人做 AI 视频必懂基础概念

面向 AI 视频制作新手的入门科普文章,去繁就简地讲解了四大模块的基础概念:音频部分(TTS、ASR、SRT 字幕、声音克隆等)、视频底层工具(ffmpeg、帧率、补帧、超分、人脸修复)、AI 生成画面核心概念(Prompt、Seed、LoRA、时序一致性、图生视频等)以及流水线工程概念(推理、量化、ComfyUI、智能体等)。每个概念只讲是什么与实操重点,并给出新手避坑建议:先跑通最小流水线、显存决定速度、理解文件流转逻辑,最后附完整专有名词速查表。

技术 › 短剧 Modengsir AI 2026-08-296.8 KB 8K 71 78

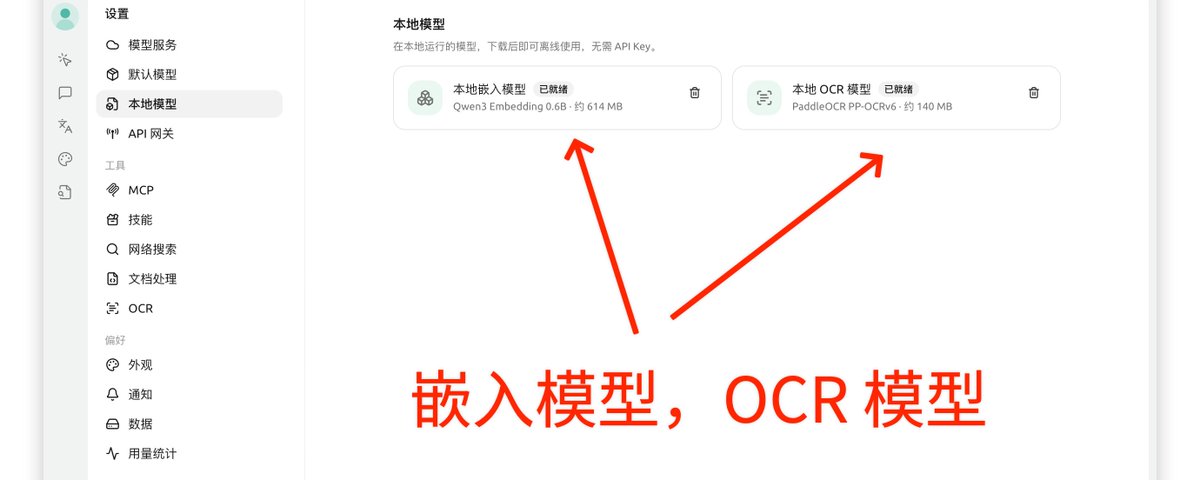
聊聊 Cherry Studio 2.0 对本地模型的支持

文章探讨了 Cherry Studio 2.0 对本地模型的支持策略。作者认为本地模型的主要价值不在于替代云端大语言模型,而是通过 Embedding、OCR、ASR 和数据脱敏等轻量级模型,补齐 AI 产品中的关键基础能力。这种设计旨在降低用户使用门槛,提高隐私保护,并确保功能的稳定性。

技术 › 工具与效率 Yinsen 2026-08-067.8 KB 7.3K 29

隆重推出 Violin:一款开源视频翻译技能

作者推出了名为 Violin 的开源视频翻译技能。该工具结合了语音识别(ASR)、LLM 翻译和语音合成(TTS)技术,旨在打破高质量视频内容的语言壁垒。Violin 支持个性化翻译、多语言处理及与视频互动,提供 Web、CLI 和代理技能等多种使用方式,并已在 MIT 协议下完全开源。

技术 › LLM Kevin Lin 2026-05-152.5 KB 58