Wiki 知识库

全部文档 / 标签: 语音识别

9 篇
清除

一个假期,用 AI 自制 Telos 全能 App 替代多个付费工具

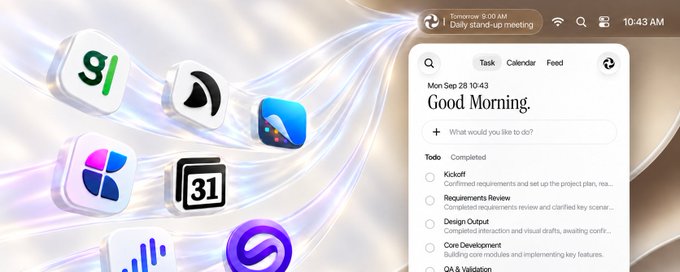
作者在国庆假期用 3 天时间和 Astra 聊天,用 credits 开发出了全能 Mac 应用 Telos,替代了 Granola、Typeless、Things、CleanShot X、Notion Calendar 等多个付费软件,每年省下约四五百美元。Telos 基于 DeepSeek 模型和 Hermes Harness,功能包括:状态栏 Todo list、自动会议转录与总结(ScreenCaptureKit + Qwen3-ASR)、AI 语音标注截图、全局语音输入等。作者认为这些 App 打着买断制旗号行订阅制之实,经济下行下软件生态出现'自产自用'的消费降级趋势。
技术 › Harness Engineering Cellier 2026-10-126.0 KB 10.6K 36 72

16.9 MB 的语音识别,和它不认识的语言

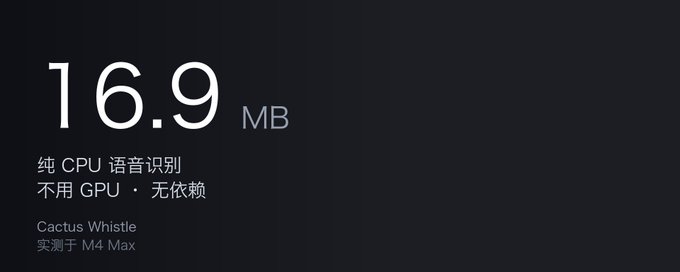
Cactus Compute 发布了 16.9 MB 的本地语音识别模型 Whistle,纯 CPU 运行、无依赖,与同公司的 Needle 模型共享引擎。作者实测发现:七种欧洲语言(英德法西意荷波)识别准确度高,首 token 仅 5-8 毫秒,解码速度约 1300 token/秒,官方性能数据基本可信。但关键缺陷在于:遇到不支持的语言(如中文、日文)时,模型不会报错也不会返回空,而是硬套进已知语种生成'假词',造成静默污染。文章指出该模型设计目标是端上语音自动化入口而非单纯转写,并提醒中文用户慎用。

技术 › TTS yibie 2026-10-116.2 KB 4.4K 36 83

AI 时代必备的语音输入神器!闪电说保姆级教程

本文是语音输入工具「闪电说」的保姆级使用教程。闪电说是一款桌面端 AI 语音输入工具:短按快捷键可将语音转为文字,长按则让 AI 结合屏幕上下文帮你生成回复,适用于微信、飞书、文档等场景。文章从权限开启、界面介绍讲起,详细说明三类模型的配置方法(语音识别推荐豆包,含 20 小时免费额度的接入步骤),并介绍短按输入、长按「帮我说」两种核心玩法及指令技巧,还涵盖资料库个性化设置(风格、词典、关于我、技能、记忆)与快捷键、麦克风、系统等常用设置,帮助用户快速上手。

技术 › 工具与效率 Hytidel聊商业 2026-10-0621.5 KB 20.8K 22 77

用开源实时 ASR 模型 Confucius4-R2T2 + Jev 平替英语流利说

作者介绍网易有道开源的实时流式 ASR 模型 Confucius4-R2T2 与 Jev 模型组合,可平替英语流利说的口语评测功能。R2T2 是真流式模型,以 160ms 间隔输出且具备 stable prefix 机制,保证已提交文本不被修改;Jev 则快速判断文本层面的漏读、多读和错读类型。两模型均为开源,可在 NVIDIA 显卡本地部署,适合在家朗读练习。作者也指出当前方案仅限文本层面纠错,读音纠错需接入音标识别模型,应对语序跳跃、替换词等复杂场景仍需更深入的声学模型支持。

技术 › LLM WquGuru (@wquguru) 2026-09-212.9 KB 75

Building low latency, streaming voice agents

本文介绍 Google 最新的语音转文本模型 Gemini 3.5 Transcribe,重点讲解其实时流式端点 gemini-3.5-transcribe-live 如何通过 WebSocket 以亚秒级延迟实现低延迟语音交互。作者以实时辩论代理为例,展示如何结合 Agent Development Kit (ADK) 构建多智能体流水线:在用户仍在说话时流式获取中间转录结果,经 Gemini 3.7 Flash 做意图过滤,后台并行触发 Google Search grounding 检索证据,最后通过 Cloud Text-to-Speech 生成自然语音回复。该模式支持 85+ 语言,适用于会议实时查证、呼叫中心坐席辅助、交互式语音机器人、直播字幕等场景,消除了传统语音应用的等待延迟。

技术 › TTS Wei Hsia 2026-09-118.7 KB 30.1K 208 74

网易叭哥说AI语音输入法评测:识别速度快到没朋友

作者对比了Typeless、闪电说、豆包输入法和网易新推出的叭哥说四款AI语音输入法。叭哥说采用双模型架构(ASR语音识别+纠错润色),实现E2E平均1683ms的极速识别,支持小声拾音、专业术语识别、个人词典导入、多语言翻译和粤语识别等功能。文章通过小声嘀咕、长Prompt输入、翻译等多个场景实测,认为叭哥说基本补齐了竞品的短板,并展望语音输入让人机交互回归自然口语表达的未来。

技术 › TTS 卡尔的AI沃茨 2026-09-1113.5 KB 36.9K 109 78

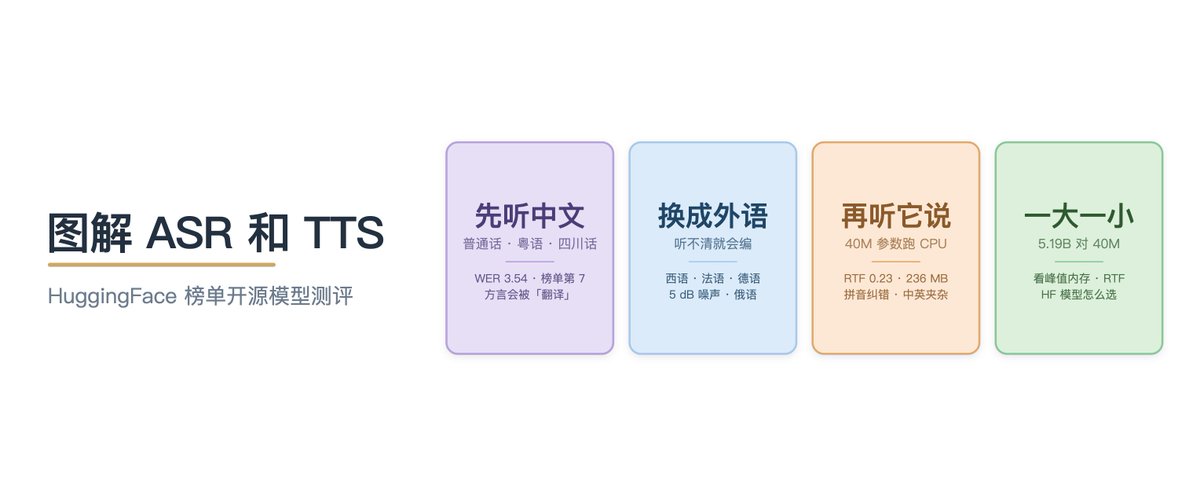
图解 ASR 和 TTS:HuggingFace 开源模型测评

作者实测了 HuggingFace 上多语种榜单第一、可本地部署的开源语音模型 Hojo-ASR-Multi-V1 和 Hojo-TTS-Light-40M。通过普通话、粤语、四川话及多国外语的实际听写测试,发现该 ASR 模型在普通话和粤语表现出色,但在方言虚词、专名和噪声场景下会出错;TTS 小模型在 CPU 上即可快速合成中英夹杂语音。文章还分析了模型体量、内存和 RTF 的关系,并给出不同场景下 ASR/TTS 开源模型的选型建议。

技术 › TTS WquGuru 2026-09-0514.2 KB 108.2K 105 86

Flow:Windows 开源提词器,语音跟读+隐形模式

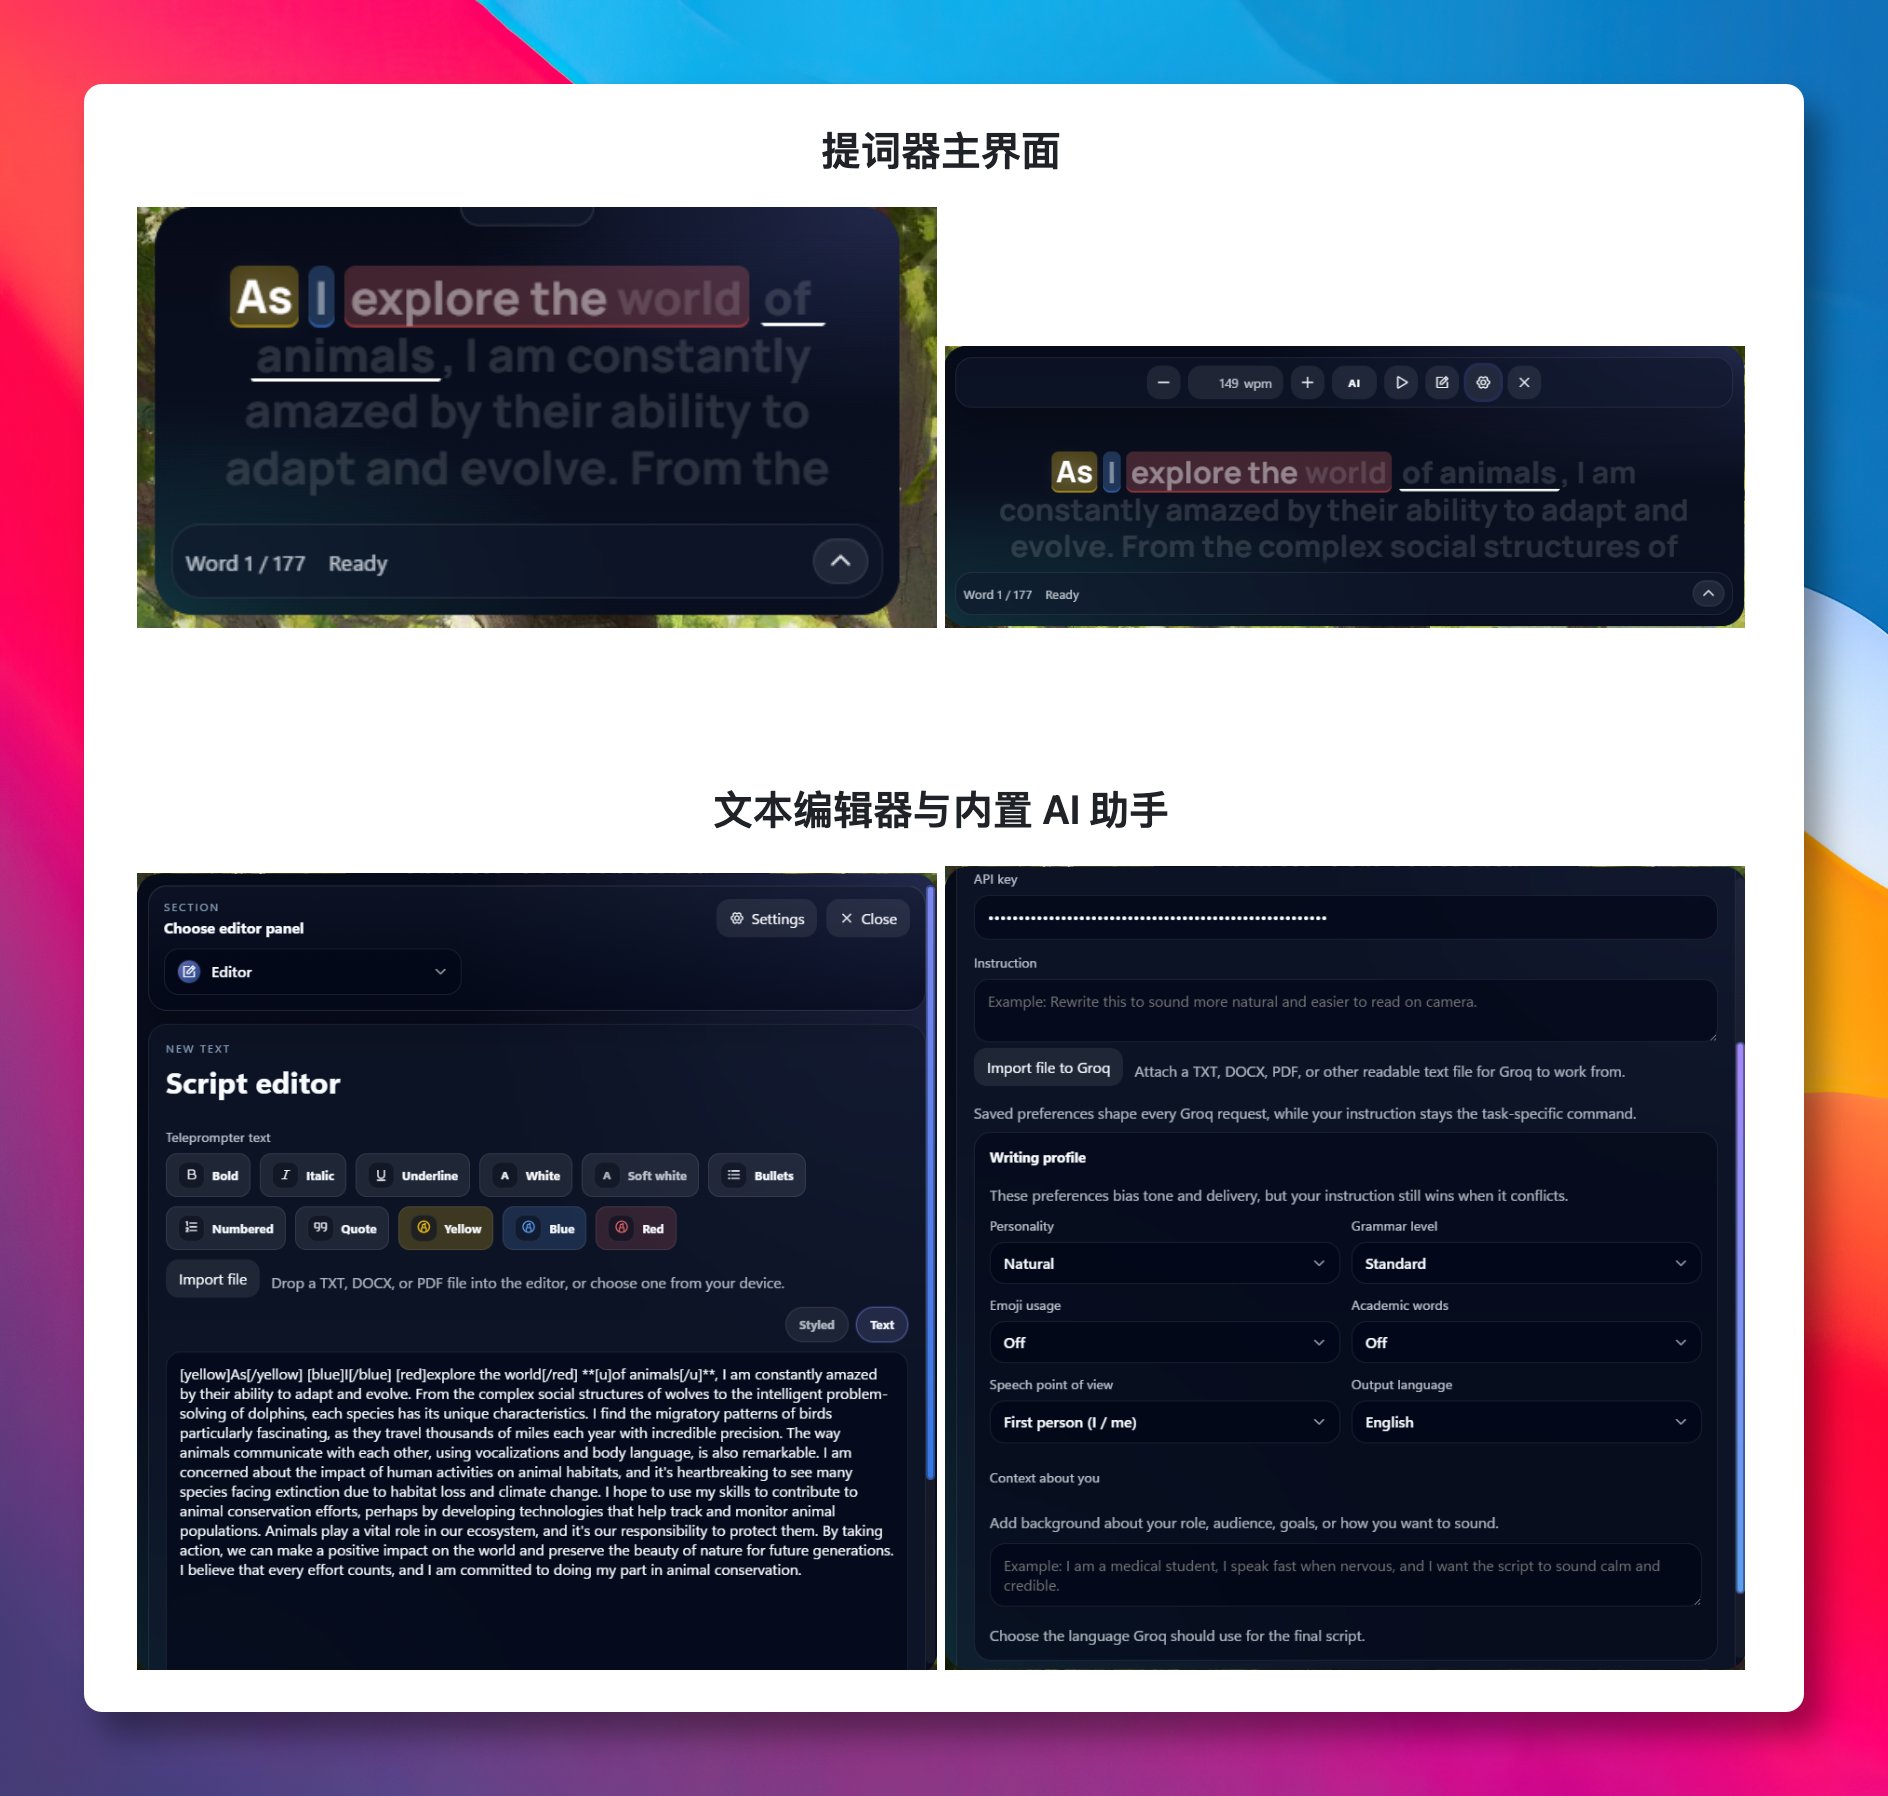
本文介绍了一款 Windows 上的开源提词器 Flow,解决录课、录口播视频时低头看稿导致眼神下飘、暴露念稿痕迹的问题。Flow 将稿件放入贴着摄像头的置顶悬浮窗,让视线无需离开镜头。其招牌功能是语音跟读,基于本机语音识别实现念到哪滚到哪,无需手动调速。此外还支持隐形模式,屏幕共享或视频通话时对方看不到提词器;提供脚本库统一管理稿件,可分段打标记、追踪长稿进度。支持 Windows 10 和 11,可在微软商店直接安装,适合主播、老师和网课短视频创作者使用。

技术 › 工具与效率 GitHubDaily 2026-08-301.2 KB 67

我本来只想把两个视频拼在一起:ChatCut 与 Codex 的使用体验

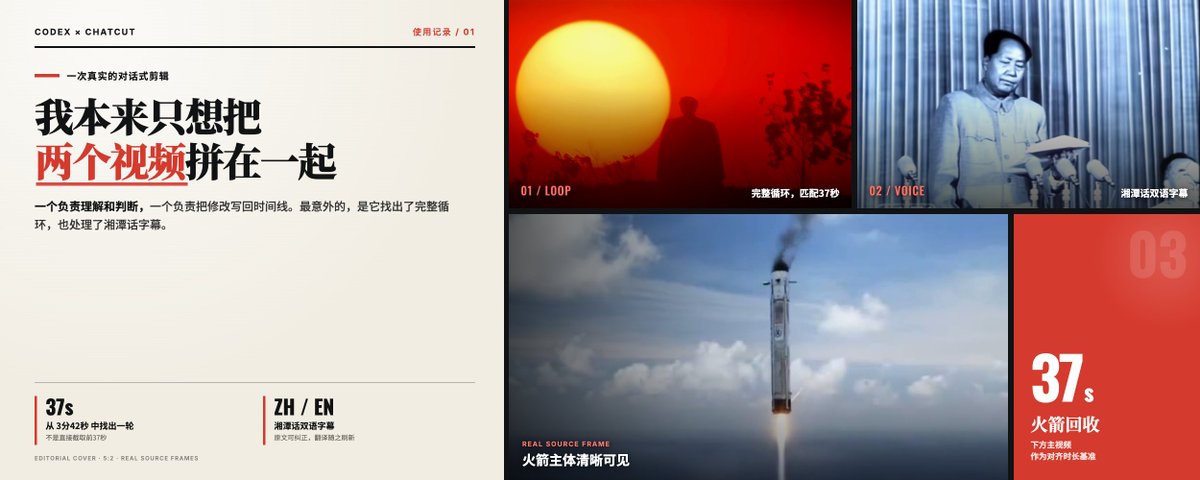
作者在尝试使用 ChatCut 和 Codex 进行视频剪辑时,意外发现其强大的智能化功能。工具不仅能自动识别循环画面并精准对齐,还能准确识别带有湘潭口音的方言并生成中英字幕。文章详细记录了对话式剪辑如何解决素材循环匹配、方言转写及字幕修正等痛点,展现了 AI 在视频编辑领域的应用潜力。