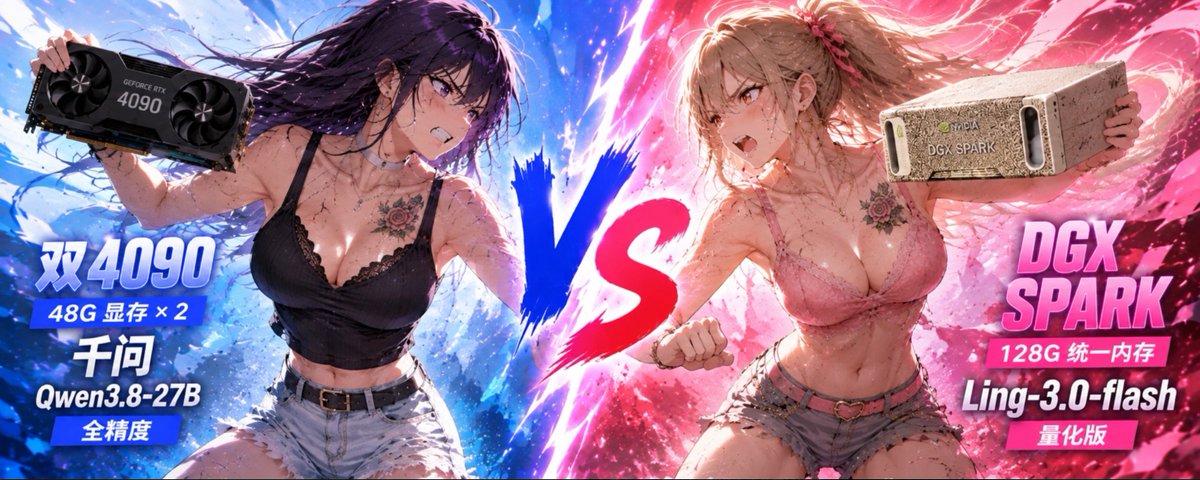
最强的矛与盾:本地部署大模型到底该买什么
本文对比 NVIDIA DGX Spark 与双 48G 魔改 RTX 4090 两台偏科硬件,测试 Qwen3.8-27B(Dense)与 Ling-3.0-flash(稀疏 MoE)四个组合的推理表现。作者详细讲解 Dense/MoE 区别、显存带宽与算力的关系、投机解码与 MTP 原理,并给出单会话速度、并发吞吐的实测数据。结论是 Spark 适合跑 MoE 或量化模型,双 4090 借助高带宽速度更快,Ling 在并发服务上吞吐约为 Qwen 的 2.4 倍,并给出选购建议。
